tactile-video-pretrain-nc
收藏资源简介:
Tactile Video Pretrain非商业版本数据集是一个专门聚合不允许商业使用的多模态触觉视频数据集,作为MIT许可主数据集的补充。该数据集整合了Baihu-VTouch数据集的一个子集,涵盖4个不同的机器人操作任务,分布在两种机器人平台上:轮式人形机器人D-WHEEL(执行废品回收和堆叠盘子任务)和手持式双夹爪智能终端PIKA(执行尺子入袋和路由器线缆任务)。数据集规模在1千到1万个样本之间,具体包含至少758个任务片段。每个片段提供丰富的多模态数据:包括4个GelSight式触觉传感器的视频(240×240分辨率)、3个RGB摄像头视频(手部摄像头848×480,头部摄像头640×480)、2个红外摄像头视频(848×480灰度)、16位精度的深度视频,以及Parquet格式记录的关节状态和动作数组。数据以分层目录结构组织,并附带相机内参外参和元数据。该数据集专为机器人学、视频分类和特征提取任务设计,特别适用于触觉-视觉多模态预训练和自监督学习。数据集采用CC-BY-NC-SA-4.0许可,要求署名、仅限非商业使用,且衍生作品必须采用相同许可。使用需引用VTouch++相关论文。
The Tactile Video Pretrain Non-Commercial Version dataset is a specialized aggregation of multimodal tactile video datasets that are not permitted for commercial use, serving as a supplement to the main dataset under MIT license. This dataset currently integrates a subset of the Baihu-VTouch dataset, covering 4 different robot manipulation tasks across two robot platforms: the wheeled humanoid robot D-WHEEL (performing waste recycling and plate stacking tasks) and the handheld dual-gripper smart terminal PIKA (performing ruler insertion into a bag and router cable tasks). The dataset scale ranges from 1,000 to 10,000 samples, specifically including at least 758 task episodes. Each episode provides rich multimodal data: including videos from 4 GelSight-style tactile sensors (240×240 resolution), 3 RGB camera videos (hand camera 848×480, head camera 640×480), 2 infrared camera videos (848×480 grayscale), 16-bit precision depth videos, as well as joint state and action arrays recorded in Parquet format. The data is organized in a hierarchical directory structure and comes with camera intrinsic and extrinsic parameters and metadata. This dataset is designed for robotics, video classification, and feature extraction tasks, particularly suitable for tactile-visual multimodal pretraining and self-supervised learning. The dataset adopts the CC-BY-NC-SA-4.0 license, requiring attribution, non-commercial use only, and derivative works must use the same license. Usage requires citation of the VTouch++ related paper.
数据集概述
数据集名称:Tactile Video Pretrain — non-commercial sibling (yxma/tactile-video-pretrain-nc)
许可证:CC-BY-NC-SA-4.0(非商业用途、署名、相同方式共享)
任务类别:机器人技术、视频分类、特征提取
标签:触觉、视觉触觉、GelSight、视频、预训练、自监督、非商业、Baihu-VTouch、OpenLoong
数据规模:1K < n < 10K(样本数)
数据集描述:该数据集是 yxma/tactile-video-pretrain 的非商业版,聚合了来自 Baihu-VTouch 的 GelSight 风格触觉视频源,其许可协议不允许商业使用。目前已包含 4 个任务(涉及 2 种机器人平台)的子集。
数据格式
每个 episode 存储在 videos/baihu_vtouch/<task>/<robot>/<episode_id>/ 目录下,包含以下文件:
| 文件 | 说明 |
|---|---|
bimanual.mp4 |
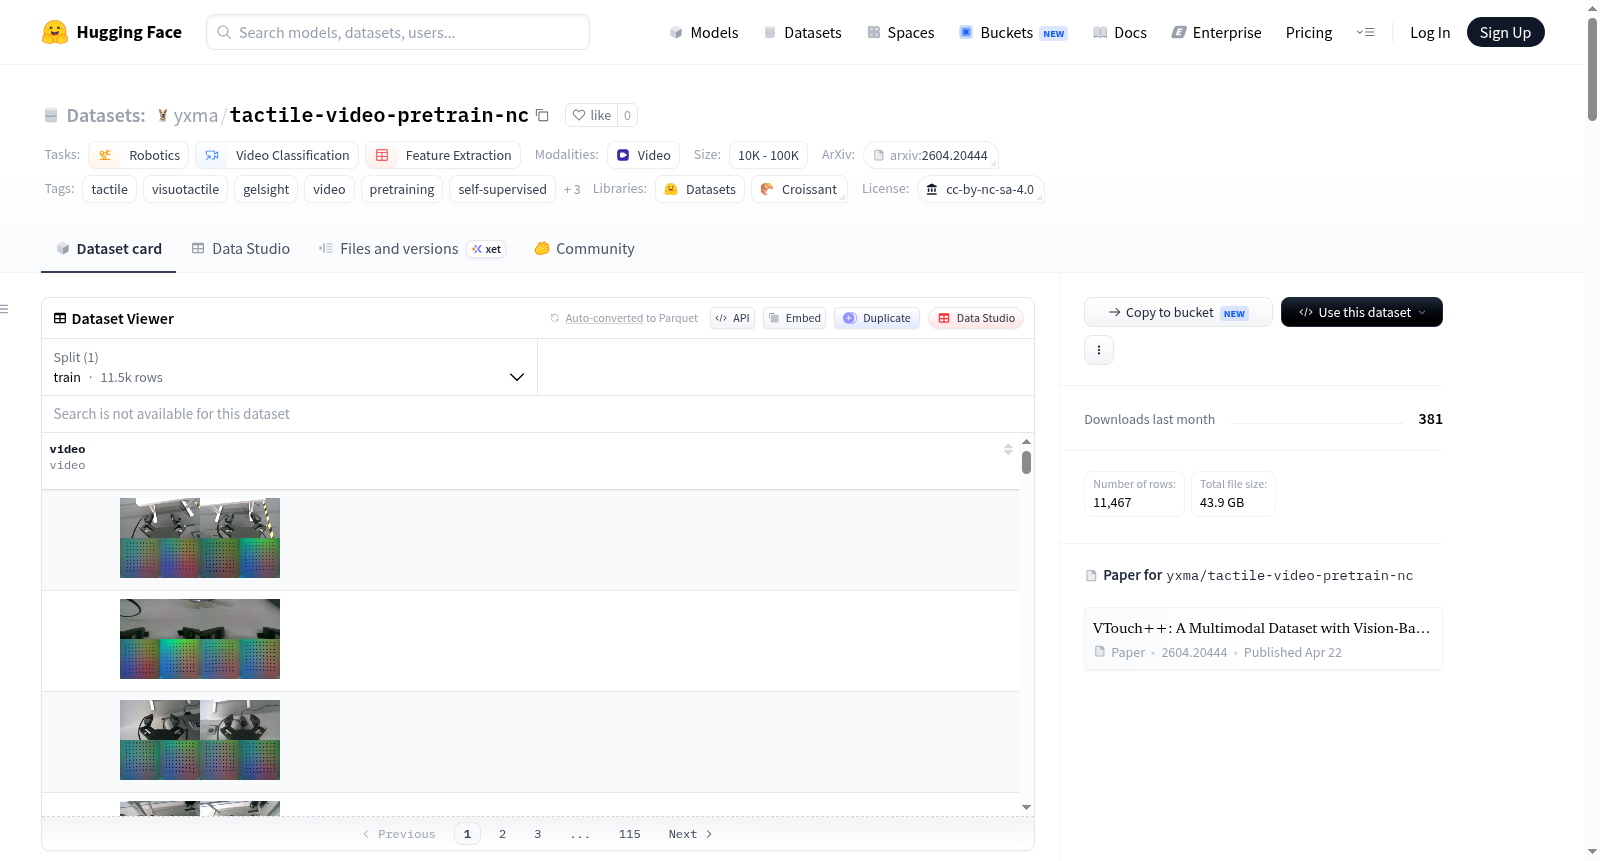
紧凑预览视频(顶部为手部相机画面,底部为4个触觉传感器画面) |
tactile_left_l.mp4 |
左手指左侧触觉视频,240×240,H.264 CRF 18 |
tactile_left_r.mp4 |
左手指右侧触觉视频,240×240,H.264 CRF 18 |
tactile_right_l.mp4 |
右手指左侧触觉视频,240×240,H.264 CRF 18 |
tactile_right_r.mp4 |
右手指右侧触觉视频,240×240,H.264 CRF 18 |
cam_hand_left.mp4 |
左手腕相机视频,848×480,H.264 CRF 18 |
cam_hand_right.mp4 |
右手腕相机视频,848×480,H.264 CRF 18 |
cam_head.mp4 |
头部相机视频,640×480 |
head_ir_left.mp4 |
头部左侧红外视频,848×480,灰度,H.264 CRF 18 |
head_ir_right.mp4 |
头部右侧红外视频,848×480,灰度,H.264 CRF 18 |
head_depth.mkv |
头部深度视频,FFV1 无损,16位灰度,灰度16le |
joints.parquet |
关节状态和动作数组 |
metadata.json |
元数据 |
params/ |
相机内参和外参 |
注意:原始 Baihu-VTouch H5 文件未镜像到 Hugging Face,如需获取,请从 ModelScope 官方页面 直接下载。
任务预览(已处理)
数据集当前包含来自 4 个 Baihu-VTouch 任务的处理 episode,具体如下:
-
废物回收(Waste Recycling)— D-WHEEL 平台(轮式人形机器人)
- 已处理 273 个 episode
-
叠盘子(Stack Plates)— D-WHEEL 平台
- 已处理 84 个 episode
-
尺子放入袋中(Ruler into Pouch)— PIKA 平台(手持式智能终端)
- 已处理 261 个 episode
-
路由器线缆操作(Router Cable)— PIKA 平台
- 已处理 140 个 episode
双手机器人布局(每 episode 预览)
每个 episode 的 bimanual.mp4 文件采用以下布局:
+-------------------+-------------------+ | 左手腕相机画面 | 右手腕相机画面 | ← 每个手腕的场景RGB画面 +--------+----------+--------+----------+ | 左手指左侧| 左手指右侧| 右手指左侧| 右手指右侧| ← 4个触觉传感器 +--------+----------+--------+----------+
顶部宽行显示每个手腕相机视角的工作空间,下方4个区域为每个手指两侧的 GelSight 触觉传感器画面。
上游 H5 文件架构
每个 Baihu-VTouch episode 的原始 HDF5 文件结构如下(本数据集已压缩为上述格式):
<task>/<robot_config>/<episode_id>.h5 ├── cameras/{head,hand_left,hand_right}/color/data # (T,) JPEG 字节 ├── cameras/head/{depth,ir_left,ir_right}/data # (T,) 字节/数组 ├── tactile/{hand_left,hand_right}/{left,right}/data # (T,) PNG 字节(凝胶图像) ├── joints/state/{arm,effector,robot,waist}/... # (T, K) float32 ├── joints/action/... ├── parameters/camera/{head,hand_left,hand_right}.json ├── metadata.json └── timestamp # (T,) int64
每个 Baihu-VTouch episode 运行约 400-1500 帧,采样率为 30 Hz(对应 几秒到约 50 秒的运动)。
机器人平台
| 机器人 | 描述 | 本仓库中的任务 |
|---|---|---|
| D-WHEEL | 轮式人形机器人(青龙级) | 废物回收、叠盘子 |
| PIKA | 手持式双夹爪智能终端 | 尺子放入袋中、路由器线缆操作 |
两个平台均采用相同的 4 触觉 + 3 相机 + 16位深度 + 2 红外 + 关节状态架构,便于跨平台预训练。
快速开始
python from huggingface_hub import snapshot_download import glob, os, pyarrow.parquet as pq
root = snapshot_download("yxma/tactile-video-pretrain-nc", repo_type="dataset") episodes = glob.glob(os.path.join(root, "videos/baihu_vtouch///*")) print(f"{len(episodes)} episodes available locally")
ep = episodes[0] tactile_left = os.path.join(ep, "tactile_left_l.mp4") depth = os.path.join(ep, "head_depth.mkv") # FFV1 16-bit joints = pq.read_table(os.path.join(ep, "joints.parquet"))
仍在处理中的内容
完整的 Baihu-VTouch 数据集共 17 TB,涵盖 29 个任务。当前正在后台下载更多任务(按数据量从小到大处理),转换为上述格式,并每 15 分钟自动推送。请稍后查看更新。
引用
bibtex @article{hua2026vtouch, title = {VTouch++: A Multimodal Dataset with Vision-Based Tactile Enhancement for Bimanual Manipulation}, author = {Hua, Qianxi and Li, Xinyue and Yan, Zheng and Li, Yang and Zhang, Chi and Li, Yongyao and Liu, Yufei}, journal = {arXiv preprint arXiv:2604.20444}, year = {2026} }