
Puffin-16M
收藏资源简介:
Puffin-16M是一个大规模多模态三维世界状态数据集,由南洋理工大学S-Lab等机构联合构建。该数据集包含1500万视觉-语言-相机三元组和100万条复杂运动轨迹,总计1600万样本,涵盖场景外观、几何深度、重力场等原生世界状态。数据通过采集真实场景并标注绝对相机参数、深度图及物理场创建,确保物理一致性与多样性。该数据集旨在支持统一多模态模型的三维世界感知、生成与重建任务,为空间智能与物理AI研究提供规模化训练基础。
Puffin-16M is a large-scale multimodal 3D world state dataset jointly constructed by S-Lab of Nanyang Technological University and other institutions. This dataset contains 15 million vision-language-camera triples and 1 million complex motion trajectories, totaling 16 million samples, covering native world states such as scene appearance, geometric depth, and gravitational field. It is created by collecting real scenes and annotating absolute camera parameters, depth maps and physical fields, ensuring physical consistency and diversity. This dataset aims to support 3D world perception, generation and reconstruction tasks of unified multimodal models, providing a large-scale training foundation for spatial intelligence and physical AI research.
Puffin-16M 数据集详情总结
数据集概览
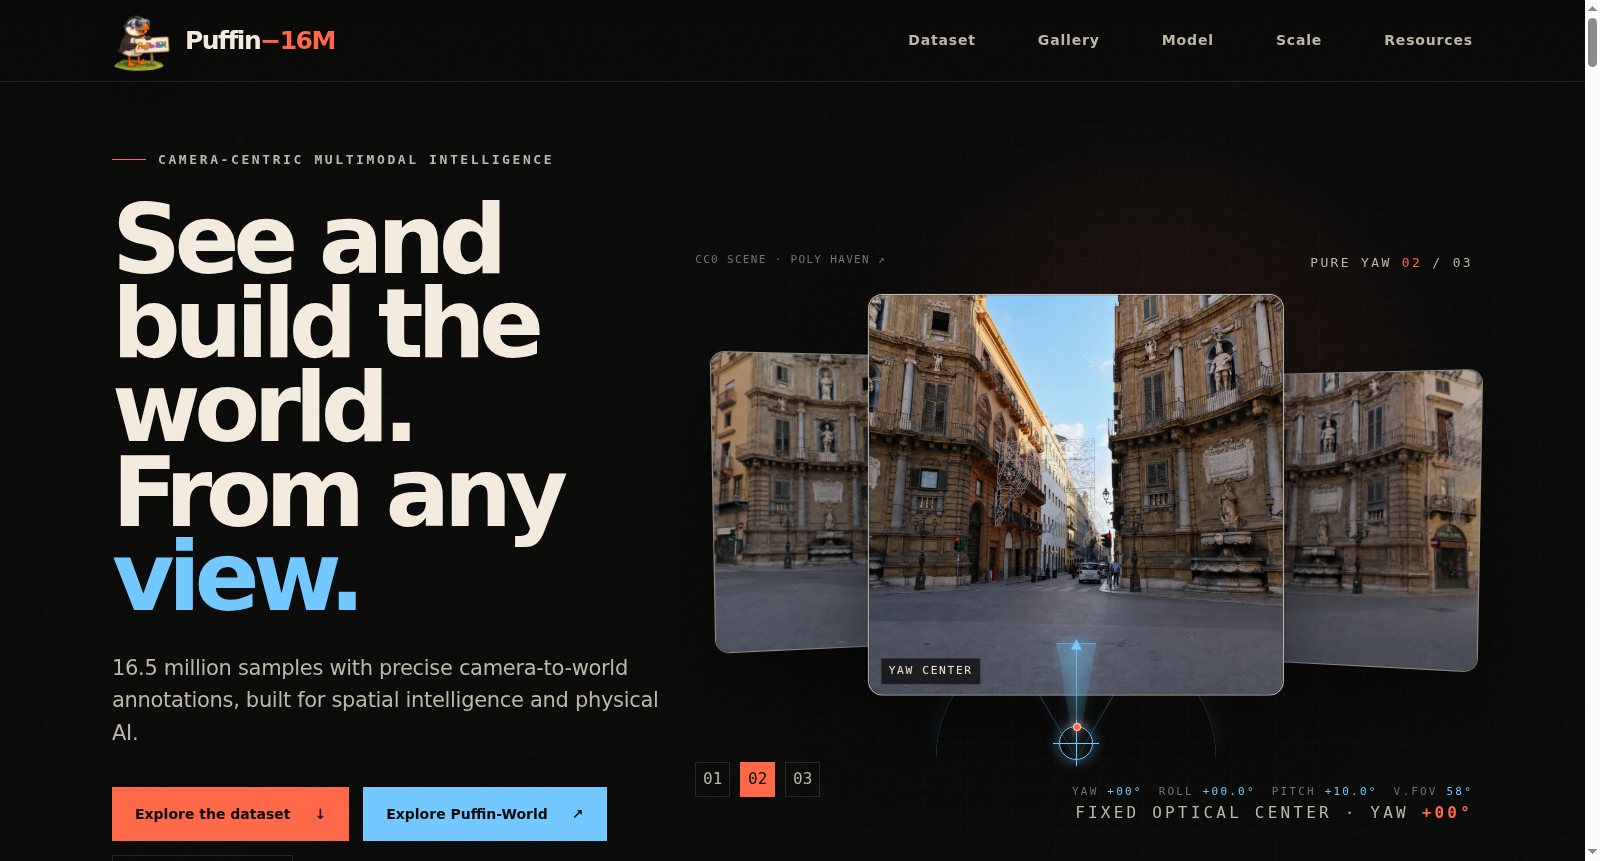
Puffin-16M 是一个面向空间多模态智能与物理 AI 的相机中心数据集,包含 1650 万个样本,提供精确的相机到世界的标注,支持空间智能和物理 AI 的研究与应用。数据集由两个互补的子集构成:大规模单视角相机监督数据与密集运动轨迹数据。
核心特性:
- 16.5M 总样本数
- 精确的相机参数(roll、pitch、FoV 等)
- 多模态:视觉-语言-相机三元组
- 统一的数据格式
子集构成
A / 单视角数据:Puffin-Cam-15M(15,338,221 样本)
从多样化的室内外全景图中渲染得到视觉-语言-相机三元组。
相机参数范围:
- Roll(滚动角):-45° 至 +45°
- Pitch(俯仰角):-45° 至 +45°
- V.FOV(垂直视场角):20° 至 105°
B / 轨迹数据:Puffin-Traj-1M(1,136,696 样本)
包含连续帧序列,具备密集的逐帧内参、绝对与相对外参标注,每条轨迹均为 90 帧 × 1° 的相机运动序列。
相机高度分类法
数据集包含五种视角层级:
- 水下(Underwater)
- 低位置(Low-position)
- 视线高度(Eye-level)
- 高位置(High-position)
- 空中(Aerial)
数据画廊
Puffin-Cam-15M 图像-标题对
包含 36 个精选样本,覆盖 7 种画面宽高比(1:1、3:3、3:2、4:3、16:9、9:16 等),每个样本配有关联的描述文本与相机参数,例如 roll、pitch、FoV 和径向畸变值。
Puffin-Traj-1M 相机轨迹
包含 27 个序列,分布于三个运动轴(X 轴 Pitch、Y 轴 Yaw、Z 轴 Roll),每个轴的旋转过程均保持光心固定。相机的坐标定义为:X 向右、Y 向下、Z 向前。
模型能力:Puffin-World
基于 Puffin-16M 训练的 Puffin-World 模型,将统一的理解与生成能力整合到单一多模态框架中,并延伸至 3D 世界建模任务:
- 相机理解(Camera Understanding):从图像中估计 roll、pitch 和垂直视场角,将几何线索与摄影语言关联。
- 可控生成(Controllable Generation):通过显式相机控制进行图像生成。
- 世界探索(World Exploration):超越初始视角,探索更广阔的空间。
模型子版本:
- Puffin-World-Base:综合能力
- Puffin-World-Pro:强生成能力
- Puffin-World-Caption:专家模型
基准评测表现
Puffin-World 在四个公开权威基准(Stanford2D3D、MegaDepth、TartanAir、LaMAR)上的表现优于以往方法,在所有中位误差指标和大部分 AUC 指标上均取得领先,获得物理感知 Top-1 排名(Roll、Pitch、FoV 估计)。
相机标注数据集扩展
使用 Puffin-World 为 28 个广泛使用的图像/视频数据集进行物理相机参数标注,累计产生:
| 类别 | 数量 |
|---|---|
| 相机标注样本总数 | 44.5M+ |
| 单图像相机标签 | 39.0M |
| 绝对相机帧 | 5.47M |
| 公开数据集版本 | 28 个 |
标注类型:
- CAMERA(单图像数据集):每张独立图像标注可见相机状态(roll、pitch、FoV)。
- ABSOLUTE-CAMERA(视频/多时间步数据集):每帧在共享世界坐标系中标注绝对相机参数。
部分代表性标注数据集:
- SA-1B-Camera(897,572 张)
- CC12M-Camera(10.97M 张)
- Open-Images-Camera(8,338,780 张)
- ImageNet-1K-Camera(1.33M 张)
- ScanNet-Absolute-Camera(2.32M 帧)
- DL3DV-Absolute-Camera(2.16M 帧)
- 以及更多(共 28 个)——此列表将持续更新扩展。
获取与资源
- 完整数据集大小:约 11.6 TB
- 数据获取方式:通过 Hugging Face 下载(数据集地址:
hf download KangLiao/Puffin-16M --repo-type dataset) - 发布内容包含:分片压缩包、索引、标题文本和稠密相机标注
- 配套资源:Hugging Face 数据集页面、GitHub 实现代码、arXiv 论文(Puffin-World, 2026)、Puffin-World 模型权重
许可协议:NTU S-Lab License 1.0,由新加坡南洋理工大学 S-Lab 开发。
- 1Puffin-World: Scaling a Unified Multimodal Model with Native 3D World States南洋理工大学·S-Lab; 密歇根大学; 北京交通大学; ACE机器人 · 2026年


