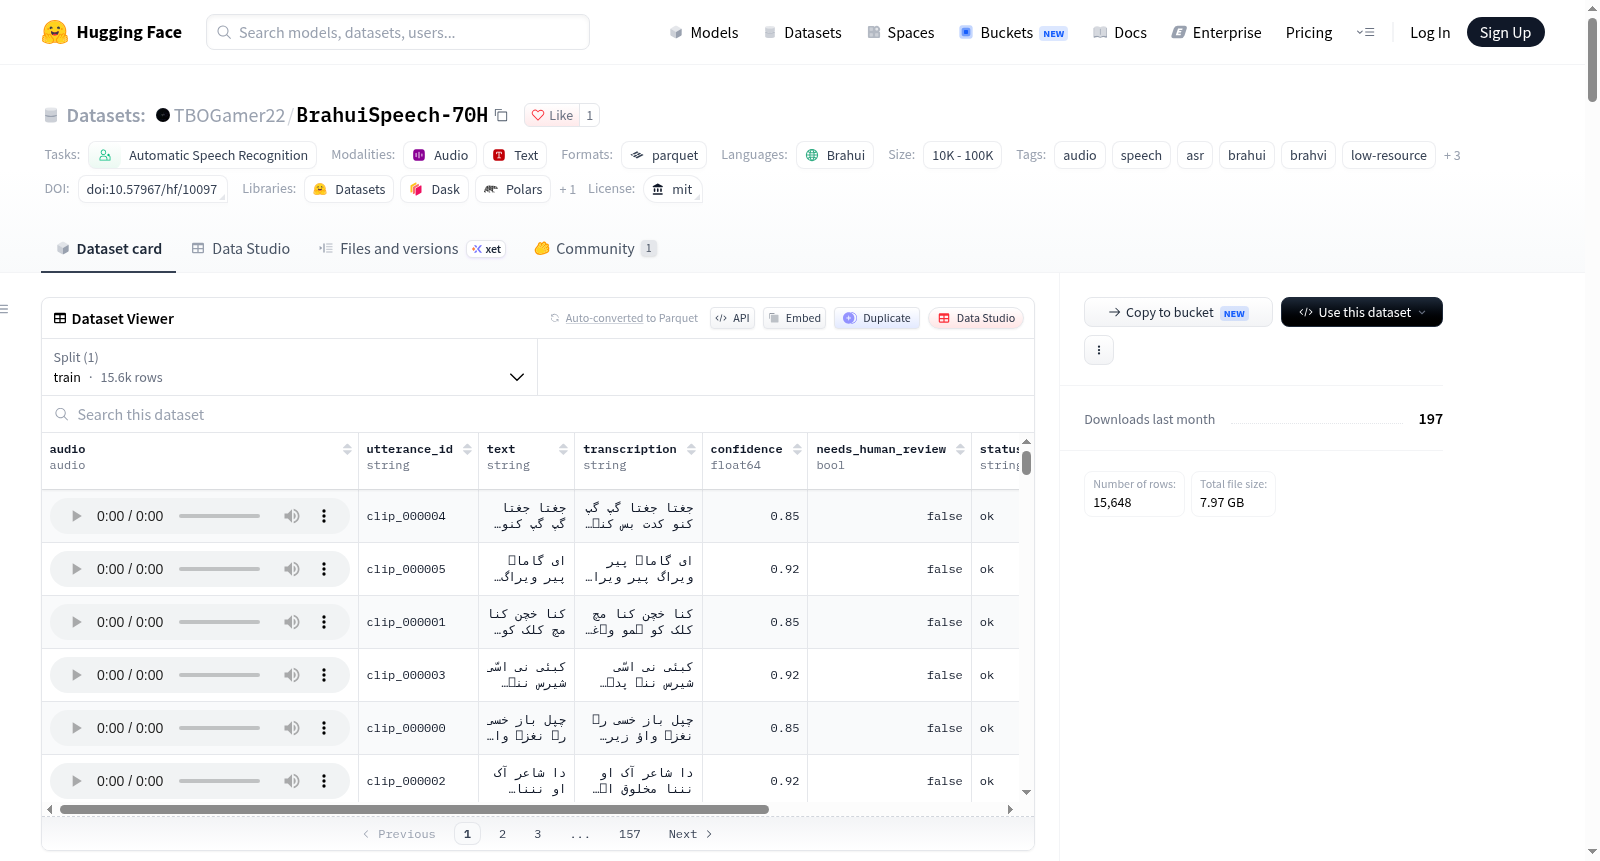
BrahuiSpeech-70H
收藏资源简介:
BrahuiSpeech-70H 是一个大规模自动语音识别语料库,包含超过70小时的已转录真实布拉灰语(Brahui,亦称Brahvi)语音。该数据集包含15,000多个语音-文本对,音频统一为16 kHz单声道格式,转录采用布拉灰语常用的波斯-阿拉伯字母。数据来源广泛,涵盖自然发生的真实语音场景,包括对话、访谈、讨论、故事、教育材料、娱乐节目、播客、新闻频道、广播、非正式讲话、叙述性语音及在线语音媒体等,旨在为语音识别系统提供比传统脚本语料库更丰富的语音分布。该数据集是首个公开可用的大规模布拉灰语ASR语料库,超过70小时,适用于ASR训练、多语言ASR微调、低资源语音研究、语音表示学习、语言识别、声学建模、基准测试、迁移学习等任务。 ⚠️ 重要提示:该数据集已被弃用,不推荐用于新项目的研究或模型开发。后续审查发现部分样本存在转录质量问题,包括不准确或不可靠的音频-文本对齐和转录错误。此仓库因已分配DOI并作为学术记录永久保留。用户应使用更正后的改进版本。
BrahuiSpeech-70H is a large-scale automatic speech recognition corpus containing over 70 hours of transcribed real Brahui (also known as Brahvi) speech. The dataset includes more than 15,000 speech-text pairs, with audio uniformly formatted as 16 kHz mono, and transcriptions using the Perso-Arabic script commonly used for Brahui. Data sources are diverse, covering naturally occurring real speech scenarios, including conversations, interviews, discussions, stories, educational materials, entertainment programs, podcasts, news channels, radio, informal speech, narrative speech, and online voice media, aiming to provide a richer speech distribution for speech recognition systems than traditional scripted corpora. This dataset is the first publicly available large-scale Brahui ASR corpus, exceeding 70 hours, suitable for ASR training, multilingual ASR fine-tuning, low-resource speech research, speech representation learning, language identification, acoustic modeling, benchmarking, transfer learning, and other tasks. ⚠️ Important Note: This dataset has been deprecated and is not recommended for new research or model development. Subsequent review found that some samples have transcription quality issues, including inaccurate or unreliable audio-text alignment and transcription errors. This repository is permanently retained as an academic record because it has been assigned a DOI. Users should use the corrected improved version.
BrahuiSpeech-70H 数据集概述
⚠️ 重要状态警告
该数据集已废弃,不建议用于模型训练或评估。 后续审查发现部分数据存在转录质量问题,包括音频-文本对齐不准确及转录错误。由于这些问题可能对ASR训练、微调、基准测试和评估产生负面影响,用户不应在新研究或模型开发中使用此版本。该仓库因已分配DOI而保留,属于学术记录的一部分。一个已修正且大幅改进的Brahui语音数据集版本将取代此版本。
数据集简介
BrahuiSpeech-70H 是一个包含 70+ 小时 转录的真实世界 Brahvi 语音的大型自动语音识别(ASR)语料库,包含超过 15,000 个语音-文本对。
Brahui(也常写作 Brahvi)是一种低资源达罗毗荼语系语言,主要在巴基斯坦俾路支省使用。尽管使用人口众多,但公开可用的 Brahui 语音资源极为有限。该数据集据发布时了解,是首个公开的、超过70小时转录语音并面向研究和商业模型开发发布的大规模 Brahui ASR 语料库。
数据特点
- 70+ 小时 转录的 Brahui 语音
- 15,000+ 个 音频-文本对
- 聚焦自然发生的真实世界语音,而非纯脚本录制语料
- 涵盖多样的说话人、说话风格、领域和录音条件
- 音频标准化为 16 kHz 单声道
- 转录文本使用 Brahui 波斯-阿拉伯文字
- 适用于 ASR 训练、微调、评估及低资源语音研究
- 面向研究和商业模型开发设计
数据规模与结构
- 规模类别:10K < n < 100K
- 每个样本包含一个音频片段及其对应的 Brahui 转录文本
- 典型结构:
audio(音频)、text(字符串) - 可使用 Hugging Face Datasets 库加载:
python from datasets import load_dataset dataset = load_dataset("TBOGamer22/BrahuiSpeech-70H")
音频信息
- 采样率:16 kHz
- 声道:单声道
- 单个样本为适合监督式 ASR 训练的短语音片段
语音领域
数据集涵盖广泛的真实世界媒体和说话情境,包括:
- 对话、访谈、讨论
- 故事、教育材料、娱乐内容
- 播客、新闻频道、广播类语音
- 非正式语音、叙述性语音、在线口语媒体
转录信息
- 使用巴基斯坦 Brahui 书面语常用的波斯-阿拉伯文字系统
- 语料构建经过多阶段转录处理和质控,包括:转录清理、文本规范化、音频-文本一致性检查、语音存在性验证、静音过滤、畸形样本移除、人工审查
语言信息
| 字段 | 值 |
|---|---|
| 语言 | Brahui |
| 别名 | Brahvi, Brohi |
| ISO 639-3 | brh |
| 主要区域 | 巴基斯坦俾路支省 |
| 文字系统 | 波斯-阿拉伯文字 |
| 语系 | 达罗毗荼语系 |
Brahui 在达罗毗荼语系中较为特殊,因其主要语言社区与南亚主要达罗毗荼语区在地理上分离,且数字资源代表性有限。
预期用途
可用于:
- 自动语音识别(ASR)
- 多语言 ASR 模型微调
- Brahui 语音识别系统训练
- 低资源语音研究
- 语音表示学习
- 多语言语音建模
- 语言识别
- 声学建模
- 语音基准测试
- 迁移学习
- Brahui 语言技术研究
质量控制
语料在发布前经过自动和人工质量控制阶段,质量检查包括:音频验证、转录规范化、语音存在性检测、静音过滤、音频-文本一致性检查、畸形样本过滤、转录审查。在底层语音适合语音识别训练的前提下,保留了自然发生的声学变化。
局限性
- 录音条件不统一,样本可能存在背景噪声、录音设备差异、麦克风质量、说话人距离、区域发音、语速、非正式语言、代码转换、领域特定词汇等变化
- 不应将数据集解读为同等代表所有 Brahui 方言、地理区域、人口群体或说话风格
知识产权与引用
- 许可证:MIT
- 数据集面向研究和商业模型开发发布,用户需确保使用符合适用的许可条款
- 引用信息:
bibtex @dataset{binomar2026brahuispeech70h, author = {Talha Bin Omar}, title = {BrahuiSpeech-70H: A Large-Scale Real-World Brahui Speech Recognition Corpus}, year = {2026}, publisher = {Hugging Face}, url = {https://huggingface.co/datasets/TBOGamer22/BrahuiSpeech-70H}, language = {Brahui} }
发布仓库
Hugging Face: TBOGamer22/BrahuiSpeech-70H
现有 Brahui 语音资源对比
Brahui 历史上公开可用的语音数据极为有限。现有资源包括较小的 Brahui 语料(如 Mozilla Common Voice)以及大型多语言语音计划(如 Meta 的 Omnilingual ASR 语料库)中包含的 Brahui 样本。BrahuiSpeech-70H 的主要区别在于其规模及其对多样化真实世界 Brahui 语音的聚焦,70+ 小时的转录音频使研究者无需自行构建大型 Brahui 语音语料库即可进行实质性 ASR 微调和实验。