
遇见数据集

INSAIT-Institute/rit-hellaswag

收藏
Hugging Face2026-06-22 更新2026-07-22 收录
官方服务:

资源简介:

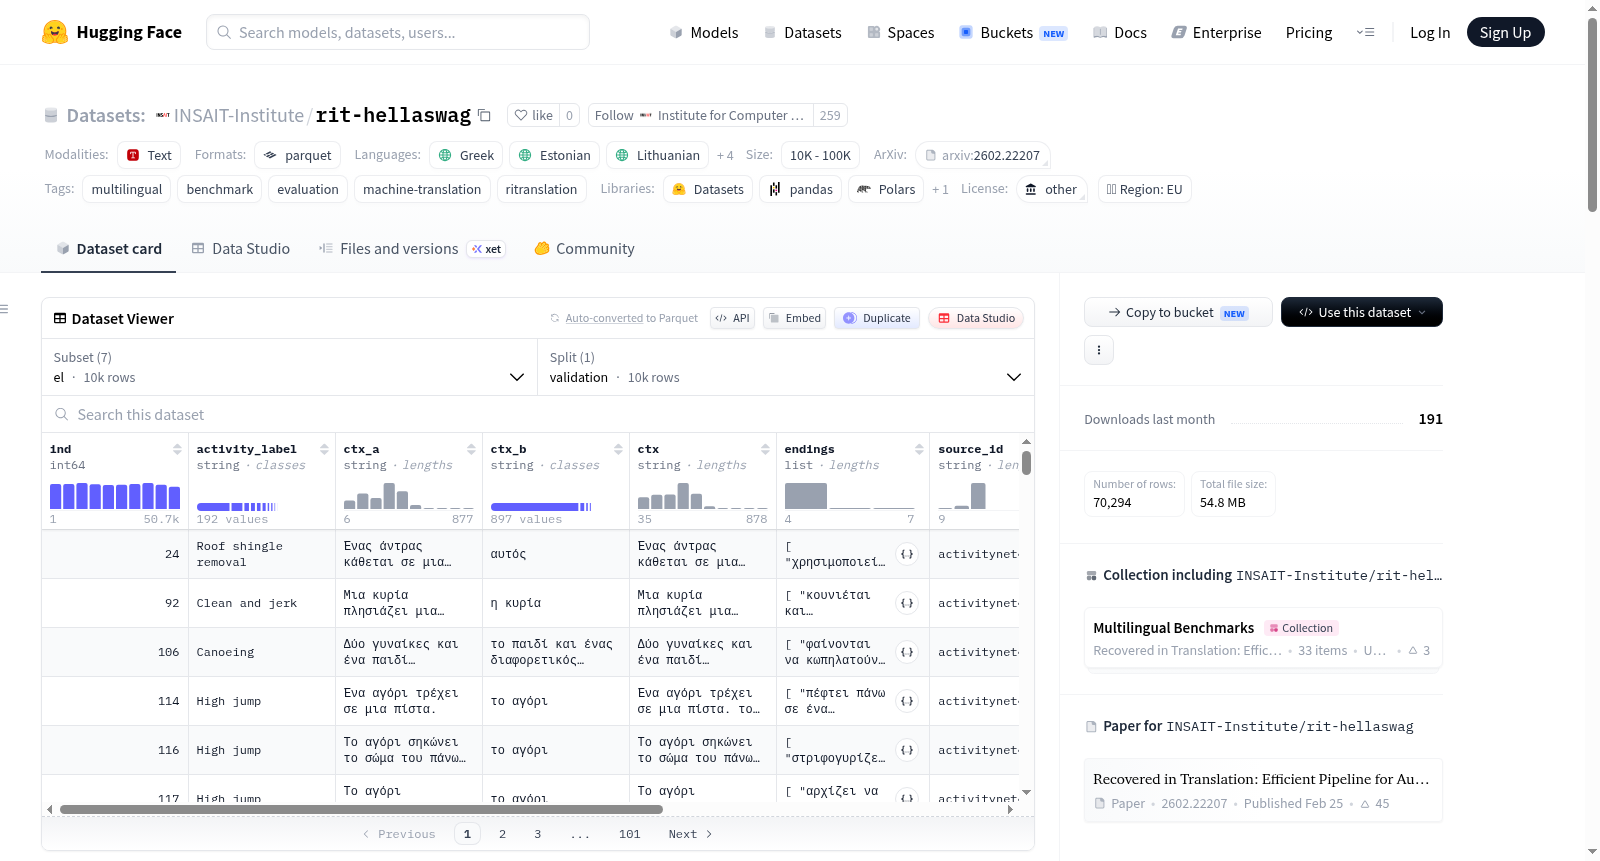
HellaSwag Multilingual 是一个多语言常识句子补全基准测试数据集,专注于日常情境中的合理延续。该数据集通过自动翻译框架(RiTranslation)从原始HellaSwag基准测试翻译而来,支持多种东欧和南欧语言,包括乌克兰语、希腊语、爱沙尼亚语、立陶宛语、罗马尼亚语、斯洛伐克语和土耳其语。每个语言作为一个独立的配置(config),数据集结构包含ind、activity_label、ctx_a、ctx_b、ctx、endings、source_id、split、split_type和label等字段。该数据集旨在便于跨语言比较模型性能,适用于多语言基准评估和分析。

HellaSwag Multilingual is a commonsense sentence-completion benchmark centered on plausible continuations for everyday situations. It is a multilingual version of the HellaSwag benchmark, translated through an automated framework (RiTranslation) and includes languages such as Ukrainian, Greek, Estonian, Lithuanian, Romanian, Slovak, and Turkish. Each language is provided as a separate config, with dataset fields including ind, activity_label, ctx_a, ctx_b, ctx, endings, source_id, split, split_type, and label. The dataset is intended for multilingual benchmark evaluation and analysis, facilitating cross-language model comparisons.
提供机构:
INSAIT-Institute
搜集汇总
数据集介绍
INSAIT-Institute/rit-hellaswag 数据集图片
构建方式
在自然语言处理领域,常识性句子补全基准HellaSwag的原始版本仅覆盖英语,限制了其在多语言场景下的应用。为突破这一瓶颈,RiTranslation研究团队提出了一种高效的自动化翻译框架,通过结合自检、最佳采样、通用自我改进及T-RANK多轮排序等测试时计算策略,系统性地将原始HellaSwag基准翻译为乌克兰语、希腊语、爱沙尼亚语、立陶宛语、罗马尼亚语、斯洛伐克语和土耳其语七种语言。该数据集以每个语种为独立配置(config)的形式整合于同一仓库中,各配置下仅包含验证集(validation)的Parquet格式文件,保留了源数据集的字段结构如`ind`、`activity_label`、`ctx`、`endings`及`label`,确保数据在不同语言间的一致性与可比性。
特点
rit-hellaswag数据集的核心特色在于其多语言覆盖下的精细粒度与评估可靠性。每个语种配置均严格继承原始HellaSwag的推理任务设计,即从四个候选结尾中选出最符合常识的延续项,从而在多语言环境中复现对模型常识推理能力的严苛测试。该数据集特别聚焦于东欧及南欧语言,填补了现有基准在多语种常识推理评估上的空白。此外,通过RiTranslation框架的先进翻译策略和严格的质量控制,数据集在保持语义准确性的同时,巧妙地规避了机器翻译常见的信息损失,为跨语言模型性能对比提供了可信赖的评测工具。
使用方法
用户可通过Hugging Face的`datasets`库便捷地加载该资源。例如,使用`load_dataset('INSAIT-Institute/hellaswag', 'ukr')`即可获取乌克兰语子集,其中`ukr`可替换为`el`、`et`等指定语种配置。需注意,数据集仅包含验证集,适合直接用于模型评估而非训练。为确保正确加载,可调用`get_dataset_config_names`函数列出所有可用配置。研究者应当审慎解读机器翻译基准上的评估结果,考虑语言特异性歧义、文化语境及潜在的数据污染问题,结合原始基准的许可条款进行合理引用与发布。
背景与挑战
背景概述
HellaSwag多语言数据集由保加利亚INSAIT研究所的Hanna Yukhymenko、Anton Alexandrov和Martin Vechev等人于2026年创建,源于其论文《Recovered in Translation: Efficient Pipeline for Automated Translation of Benchmarks and Datasets》。该数据集旨在将原本为英语设计的常识性句子补全基准HellaSwag扩展到七种语言(乌克兰语、希腊语、爱沙尼亚语、立陶宛语、罗马尼亚语、斯洛伐克语和土耳其语),以促进多语言自然语言理解评估。作为自动化翻译框架RiTranslation的核心产出之一,它通过高质量的机器翻译和测试时计算策略(如Self-Check、Best-of-N等)解决了多语言基准稀缺的问题,为评估跨语言大语言模型的常识推理能力提供了标准化工具,对多语言NLP和低资源语言评估研究具有重要推动作用。
当前挑战
该数据集面临的核心挑战包括:领域层面上,常识推理任务本身要求模型理解隐含在情境中的文化常识和世界知识,而不同语言间的文化背景差异(如特定场景的合理性)可能导致翻译后的基准评估结果出现偏差。构建过程中,确保机器翻译的语义保真度和消除语言歧义是主要难题,尤其是处理那些跨语言结构不一致的复杂句子;此外,自动化翻译框架需兼顾翻译质量与成本效率,RiTranslation所采用的T-RANK多轮排序等策略虽提升了性能,但模型翻译结果的可靠性仍需通过严格的人工检验和跨语言对比验证来保障,且数据集在许可证和原始基准的传播约束下存在复用限制。
常用场景
经典使用场景
HellaSwag 多语言数据集主要被设计用于评估和提升语言模型在常识推理任务上的跨语言理解能力。其核心使用场景是作为多语言基准测试,衡量模型在给定一个日常情境的描述后,能否从多个候选选项中选出最合理的后续发展。该数据集涵盖了乌克兰语、希腊语、爱沙尼亚语、立陶宛语、罗马尼亚语、斯洛伐克语和土耳其语等语言,为跨语言常识推理研究提供了标准化的评估框架。通过在统一的基准上比较模型在不同语言上的表现,研究者能够深入探讨当前语言模型在非英语环境下的常识推理短板,从而推动多语言自然语言处理技术的均衡发展。
实际应用
在实际应用中,该数据集可用于多语言聊天机器人的常识验证、教育领域的自动问答系统,以及跨语言内容审核与场景理解。例如,部署在乌克兰、土耳其等非英语国家的智能助手,可以利用该数据集训练的模型来更准确地理解当地用户的日常对话情境,从而提供更合逻辑的回应。此外,多语言新闻摘要生成和跨文化故事续写等场景也能从该数据集中获益,因为模型需要根据特定语言的文化背景选择恰当的后续发展。该数据集还为企业级多语言客服系统提供了常识推理能力的评测手段,确保模型在不同语种中保持一致的推理质量,提升用户体验。
衍生相关工作
围绕该数据集衍生出一系列相关研究工作,其中最引人注目的是 RiTranslation 论文中提出的自动化基准翻译框架。该工作探讨了多种测试时计算策略,如自检(Self-Check)、最优选择(Best-of-N)、通用自我改进(USI)以及多轮排序方法 T-RANK,显著提升了翻译质量和多语言 LLM 评估的可靠性。此外,该数据集还直接支持了 INSAIT-Institute 的多语言基准集合项目,推动了对多语言环境下的模型污染分析、跨语言歧义处理以及文化语境敏感性研究。基于此数据集,后续研究聚焦于验证翻译数据在跨语言知识迁移中的作用,并衍生出关于如何高效扩展多语言常识推理资源的方法论探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

