
遇见数据集

veeraragavan410/gitechgames-dataset

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

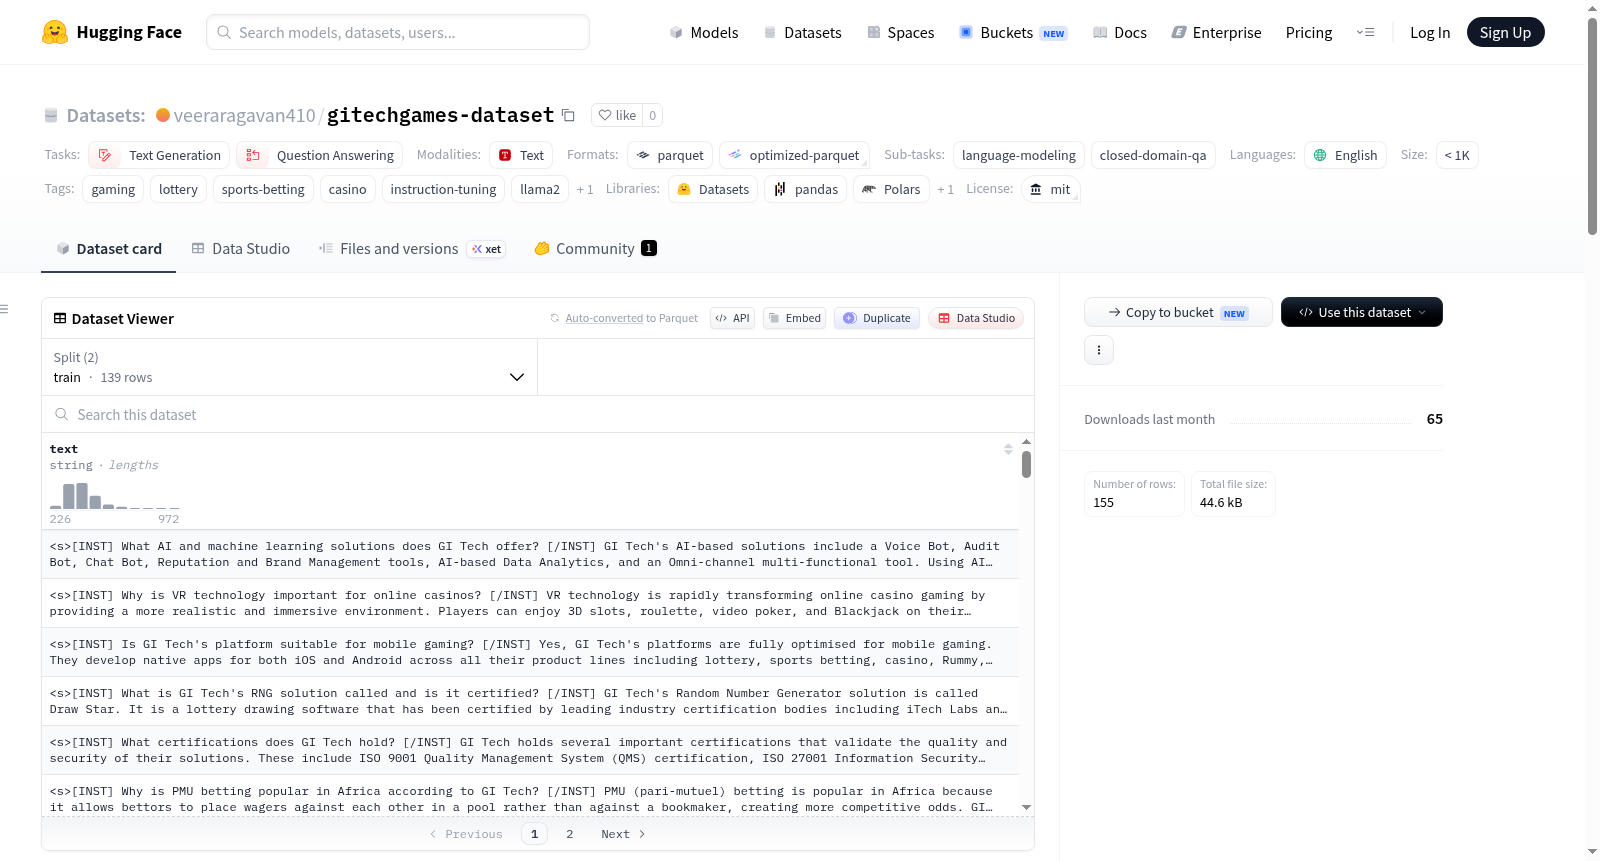
GI Tech Games数据集是一个特定领域的指令跟随数据集,基于GI Tech I Game(一家总部位于印度、业务遍及40多个国家的游戏和彩票技术公司)构建。该数据集采用Llama 2指令格式(格式为:<s>[INST] 问题 [/INST] 答案 </s>),旨在微调语言模型以回答关于GI Tech游戏产品和服务的相关问题。数据集包含155个条目,分为训练集(139行)和测试集(16行)。数据内容涵盖多个主题,包括彩票解决方案、赌场/轮盘赌、体育博彩、公司概述、服务/AI/云、拉米游戏、宾果游戏、虚拟体育、百家乐、扑克、合作伙伴/联系方式等。数据集可用于微调Llama 2、Mistral或其他指令跟随大语言模型,进行领域特定的问答任务,也适用于低资源领域适应的QLoRA/LoRA微调、游戏和彩票运营商的聊天机器人训练,以及游戏行业知识的检索增强生成(RAG)基线评估。数据来源于公开网站gitechgames.com,包括彩票、体育博彩、赌场、拉米游戏、宾果游戏、扑克、百家乐、虚拟体育和服务等产品页面。

A domain-specific instruction-following dataset built from GI Tech I Game — a gaming and lottery technology company based in India operating across 40+ countries. This dataset is formatted in the Llama 2 instruction format (<s>[INST] question [/INST] answer </s>) and is designed for fine-tuning language models to answer questions about GI Techs gaming products and services. The dataset contains 155 entries, with 139 in the train split and 16 in the test split. Topics covered include Lottery Solutions, Casino / Roulette, Sports Betting, Company Overview, Services / AI / Cloud, Rummy, Bingo, Virtual Sports, Baccarat, Poker, Partner / Contact, and others. Intended uses include fine-tuning Llama 2, Mistral, or other instruction-following LLMs for domain-specific Q&A; QLoRA / LoRA fine-tuning for low-resource domain adaptation; chatbot training for gaming and lottery operators; and RAG baseline evaluation for gaming industry knowledge. All data was sourced from the public website https://gitechgames.com, including product pages for lottery, sports betting, casino, rummy, bingo, poker, baccarat, virtual sports, and services.
提供机构:
veeraragavan410
搜集汇总
数据集介绍
veeraragavan410/gitechgames-dataset 数据集图片
构建方式
该数据集源自印度跨40多个国家运营的博彩与彩票技术公司GI Tech I Game的官方网站,通过爬取产品页面与公司介绍信息,经人工整理为指令遵循格式。所有样本均被封装为Llama 2对话模板(<s>[INST] 问题 [/INST] 答案 </s>),涵盖单轮与多轮问答形式。数据集包含155个样本,其中训练集139条、测试集16条,存储于Parquet文件中,并预设了默认配置以供直接加载。
特点
数据集聚焦于博彩与游戏领域的垂直知识,针对彩票解决方案、轮盘赌、体育博彩、公司概览等12个主题构建了分布均衡的语料。其独特之处在于采用标准化指令格式,便于兼容主流大语言模型的微调框架。此外,样本规模微小但覆盖全面,特别适合低资源场景下的领域适配,以及作为检索增强生成(RAG)系统的基线评估素材。
使用方法
使用时可通过HuggingFace Datasets库加载train与test划分,直接提取text字段进行文本生成或问答任务的训练。该数据集专为Llama 2、Mistral等指令跟随模型设计,支持结合QLoRA或LoRA技术进行高效微调,有效缓解通用模型在博彩领域中的知识盲区。亦可将其作为构建行业聊天机器人的核心语料,或用于验证RAG管道在特定行业知识上的检索性能。
背景与挑战
背景概述
在大型语言模型(LLM)领域,针对特定行业进行指令微调是提升模型领域适配性的关键策略。该数据集由研究者Veeraragavan于2026年创建,源自印度跨40余国运营的游戏与彩票技术企业GI Tech的官方网站。核心研究问题在于如何构建高质量、领域聚焦的指令遵循数据集,以微调如Llama 2等模型,使其精准回答关于彩票、体育博彩及赌场游戏等垂直场景的复杂查询。该数据集仅含155条样本,却覆盖9大主题,展示了小样本数据在专业问答中的潜力,为游戏行业对话系统与检索增强生成(RAG)评估提供了基础基准。
当前挑战
当前该数据集面临多重挑战。在领域问题层面,游戏与彩票行业涉及复杂的法规、概率与运营细节,语言模型需克服专业术语理解与精准数学推理的瓶颈,避免输出误导性信息,这远超通用问答的难度。在构建过程中,数据来源仅限于公开网页,导致样本量稀疏(训练集仅139条)且主题分布不均(如虚拟运动仅4条),难以覆盖长尾知识;同时,网页文本的噪声与多轮对话的语义连贯性维持,对数据清洗与格式化提出了严苛要求,增加了模型过拟合与泛化能力不足的风险。
常用场景
经典使用场景
该数据集以Llama 2指令格式精心构建,专为领域特定的指令微调而生。在游戏与彩票技术的垂直领域中,它常被用于对Llama 2、Mistral等开源大语言模型进行参数高效微调,如QLoRA或LoRA方法,使模型精准掌握博彩科技、彩票方案、体育博彩及赌场游戏等专业问答能力。数据集虽体量精巧,却覆盖从公司概览到具体产品的多轮对话场景,是低资源领域适配与聊天机器人训练的卓越起点。
解决学术问题
该数据集精准回应了大型语言模型在垂直行业知识迁移中的核心挑战——通用模型难以准确回答封闭域中高度专业化的疑问。它构建了一个聚焦于博彩与游戏技术的小样本指令数据集,解决了领域内问答系统缺乏高质量、结构化训练数据的困境。其意义在于为学术研究提供了探索少样本微调、领域适配与指令跟随能力的可复现基准,推动语言模型从泛化走向专精,助力理解对话系统在窄域知识上的性能边界。
衍生相关工作
该数据集衍生出一系列聚焦于游戏行业的对话系统与知识抽取研究。它常被用作低资源领域指令微调的样本,启发了针对博彩技术的小样本学习与数据增强方法。相关工作包括基于该数据集的指令微调模型在封闭域问答中的性能分析,以及将其作为RAG评估基准的检索策略对比实验。此外,研究者还借鉴其构建思路,拓展了面向体育博彩与虚拟体育的垂直数据集,持续丰富行业知识图谱与对话训练资源。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

