
遇见数据集

Nemotron-RL-Instruction-Following-MultiTurnChat-v1-prompt-only

收藏
Hugging Face2026-06-27 更新2026-06-29 收录
官方服务:

资源简介:

该数据集名为Nemotron-RL-Instruction-Following-MultiTurnChat-v1-prompt-only,是从源数据集nvidia/Nemotron-RL-Instruction-Following-MultiTurnChat-v1中提取的仅包含提示(prompt-only)的版本。数据内容主要包括prompts.csv文件,其中每条记录对应源数据集的一行,包含提取的prompt、可选的独立system_prompt以及当源行定义可用工具时的结构化tools字段,嵌套值在CSV单元格中以JSON格式编码。数据集还包含两个辅助文件:summary.md提供源行数、提取行数、计数差异和失败提示计数的摘要;null_or_empty_rows.md列出提示提取结果为空或null的行索引。数据规模为提取行数2011行,失败提示行数为0,行数差异为0。该数据集适用于需要多轮对话指令跟随的提示工程、强化学习后训练或语言模型微调任务,尤其关注提示的提取和结构化表示。数据集由Nemotron后训练v3提示提取工作流生成,并通过jamesdborin上传。

The dataset is named Nemotron-RL-Instruction-Following-MultiTurnChat-v1-prompt-only, extracted from the source dataset nvidia/Nemotron-RL-Instruction-Following-MultiTurnChat-v1 as a prompt-only version. The data primarily consists of a prompts.csv file, where each record corresponds to a row in the source dataset and includes the extracted prompt, an optional independent system_prompt, and a structured tools field when tools are defined in the source row, with nested values encoded in JSON format within CSV cells. The dataset also includes two auxiliary files: summary.md provides a summary of source row count, extracted row count, count differences, and failed prompt counts; null_or_empty_rows.md lists row indices where prompt extraction resulted in empty or null values. The data scale is 2011 extracted rows, with 0 failed prompt rows and 0 row count differences. This dataset is suitable for prompt engineering, reinforcement learning post-training, or language model fine-tuning tasks requiring multi-turn dialogue instruction following, particularly focusing on prompt extraction and structured representation. The dataset was generated by the Nemotron post-training v3 prompt extraction workflow and uploaded by jamesdborin.

创建时间:
2026-06-27
搜集汇总
数据集介绍
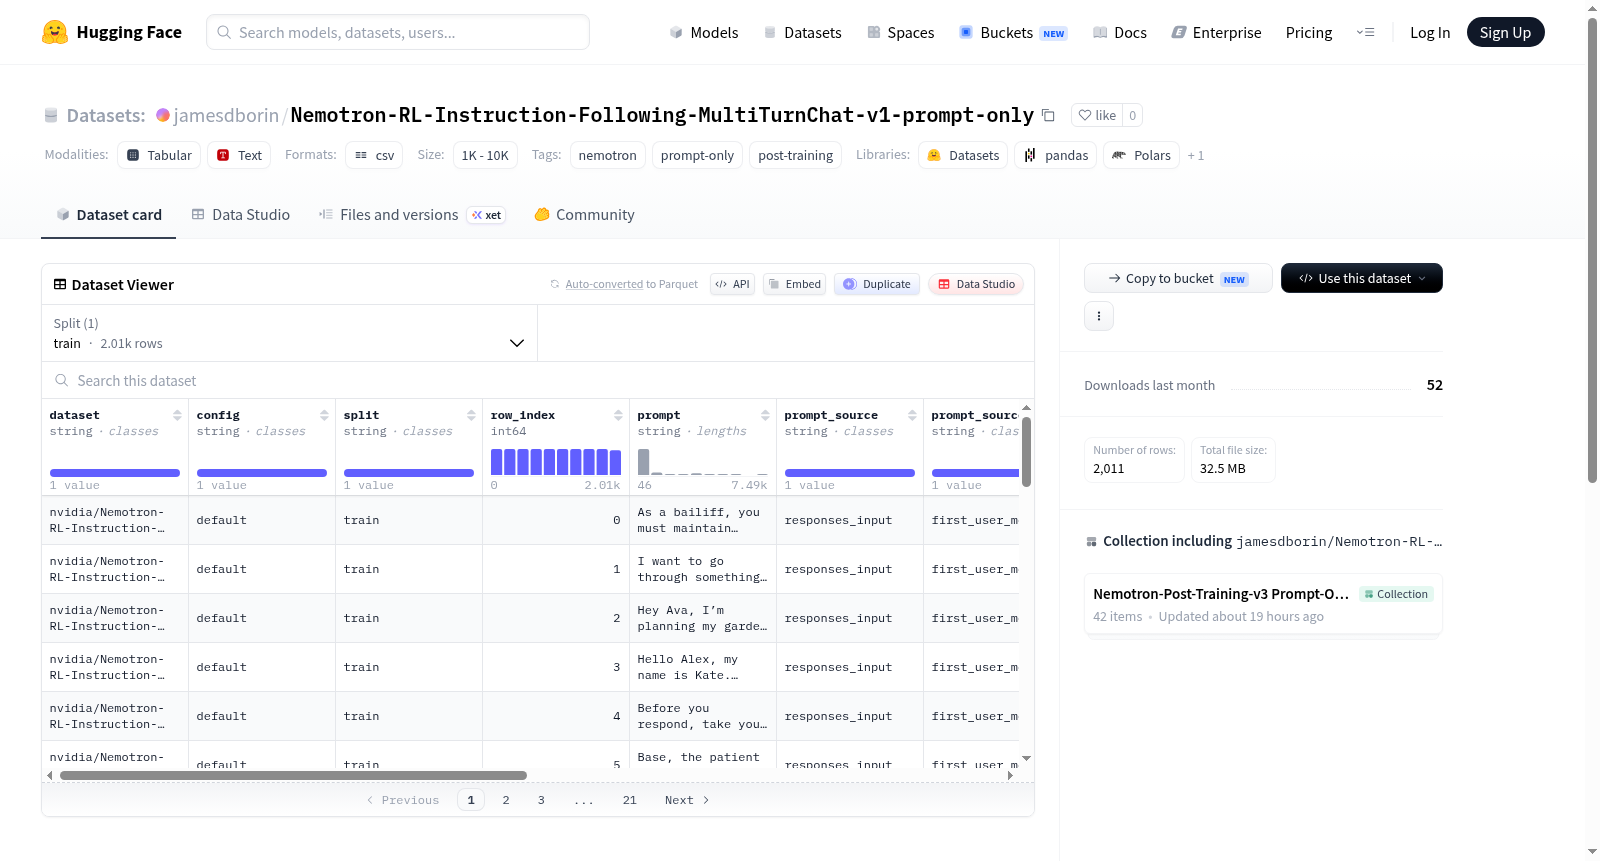
Nemotron-RL-Instruction-Following-MultiTurnChat-v1-prompt-only 数据集图片
构建方式
本数据集源自NVIDIA推出的Nemotron-RL-Instruction-Following-MultiTurnChat-v1,通过专门设计的提示提取工作流,从原始多轮对话数据中抽取出仅包含提示(prompt)的记录。提取过程保留了每条源数据中的提示文本、分离的系统提示(system_prompt),以及当源数据定义了可用工具时,以JSON格式嵌入CSV单元格的结构化工具信息。最终形成包含2011条记录、无提取失败行的高质量提示专用数据集。
特点
该数据集聚焦于提示(prompt)这一核心要素,去除了原始多轮对话中的响应部分,专为强化学习与后训练阶段中的奖励建模或策略优化场景设计。其结构简洁而信息丰富,每条记录不仅包含对话提示,还附带了系统级指令与可调用工具的定义,使得模型能够学习在复杂交互环境下如何理解和遵循指令。数据完整性极高,无任何提取失败或空值记录。
使用方法
数据集以CSV格式提供,可直接通过pandas等工具读取。用户可加载`prompts.csv`文件,利用其中的`prompt`字段作为模型输入,`system_prompt`字段作为上下文指导,`tools`字段作为可调用函数的定义。适用于微调大语言模型对多步指令的遵循能力,或在离线强化学习环境中作为状态(state)输入,以训练模型生成更符合用户意图的响应。建议结合原始多轮对话数据集进行对比分析。
背景与挑战
背景概述
该数据集由NVIDIA研究团队于2024年创建,隶属于Nemotron系列,专注于后训练阶段(post-training)的多轮对话指令遵循任务。其核心研究问题在于如何从原始多轮对话数据中高效提取结构化提示(prompt),以支持强化学习(RL)微调,从而提升大语言模型在复杂交互场景中的指令遵循能力。作为Nemotron-RL-Instruction-Following-MultiTurnChat-v1的提示专用子集,该数据集通过去除无关对话内容、保留关键指令与工具定义,为多轮对话生成基准测试提供了标准化输入源,对探索语言模型在工具调用、上下文保持等高级能力上具有重要推动作用。
当前挑战
当前数据集构建面临多重挑战。在领域问题层面,多轮对话指令遵循需解决模型对复杂意图的精准捕捉、跨轮次上下文一致性维持以及动态工具调用的正确响应,传统单轮基准难以评估此类协同能力。在构建过程中,原始多轮数据包含大量非结构化信息,提取系统需在保留系统提示、工具定义等关键要素的同时,消除无关噪声,并应对嵌套JSON与CSV格式的兼容性难题。此外,数据量仅2011条,样本稀疏性可能限制模型泛化;而零失败提取记录虽验证了流程可靠性,却难以覆盖极端边缘场景,如工具定义冲突或空提示异常的处理策略仍需完善。
常用场景
经典使用场景
Nemotron-RL-Instruction-Following-MultiTurnChat-v1-prompt-only 数据集聚焦于多轮对话中的指令跟随能力评估与强化学习训练。其经典使用场景在于为后训练阶段(post-training)提供仅包含提示(prompt-only)的高质量交互数据,涵盖系统提示、用户指令及可选工具结构定义。研究者利用这些结构化的提示记录,对大型语言模型在多轮对话中执行复杂指令、调用外部工具以及维持上下文一致性的能力进行针对性训练与基准测试。该数据集特别适用于评估模型在模拟真实对话场景时,如何准确理解并逐步完成连续、嵌套的用户需求。
衍生相关工作
该数据集衍生了一系列相关经典工作,主要集中在基于提示工程的强化学习与多轮对话系统架构改进。例如,研究者利用其提示结构提出了“交互式工具学习”框架,通过将工具描述嵌入系统提示,实现了模型在对话中动态选择与更新调用策略。此外,该数据集被应用于“上下文指令记忆”研究,探索了如何通过奖励建模增强模型对长对话中历史指令的注意力。在评估方面,基于该数据集的“指令跟随一致性基准”被广泛用于对比不同后训练方法(如DPO与RLHF)在工具辅助对话中的效果差异,还催生了自动化的提示质量检测流水线。
数据集最近研究
最新研究方向
该数据集聚焦于多轮对话场景下的指令遵循能力强化,为后训练阶段(post-training)的强化学习提供纯提示(prompt-only)样本。在当前大语言模型对齐研究的前沿,如何通过精准的指令跟随训练提升模型在复杂对话中的可控性与鲁棒性已成为热点。Nemotron-RL-Instruction-Following-MultiTurnChat-v1-prompt-only的提出,剥离了完整对话中的响应,保留结构化提示、系统提示及工具定义,为探索无需完整轨迹的稀疏奖励强化学习、提示工程优化以及工具调用场景下的语义理解提供了标准化基准。其提取流程的透明化(如失败记录)也促进了数据质量评估方法的进步,对推动人机交互中更可信赖的对话系统发展具有重要实践意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

