rerandomization-benchmarks
收藏资源简介:
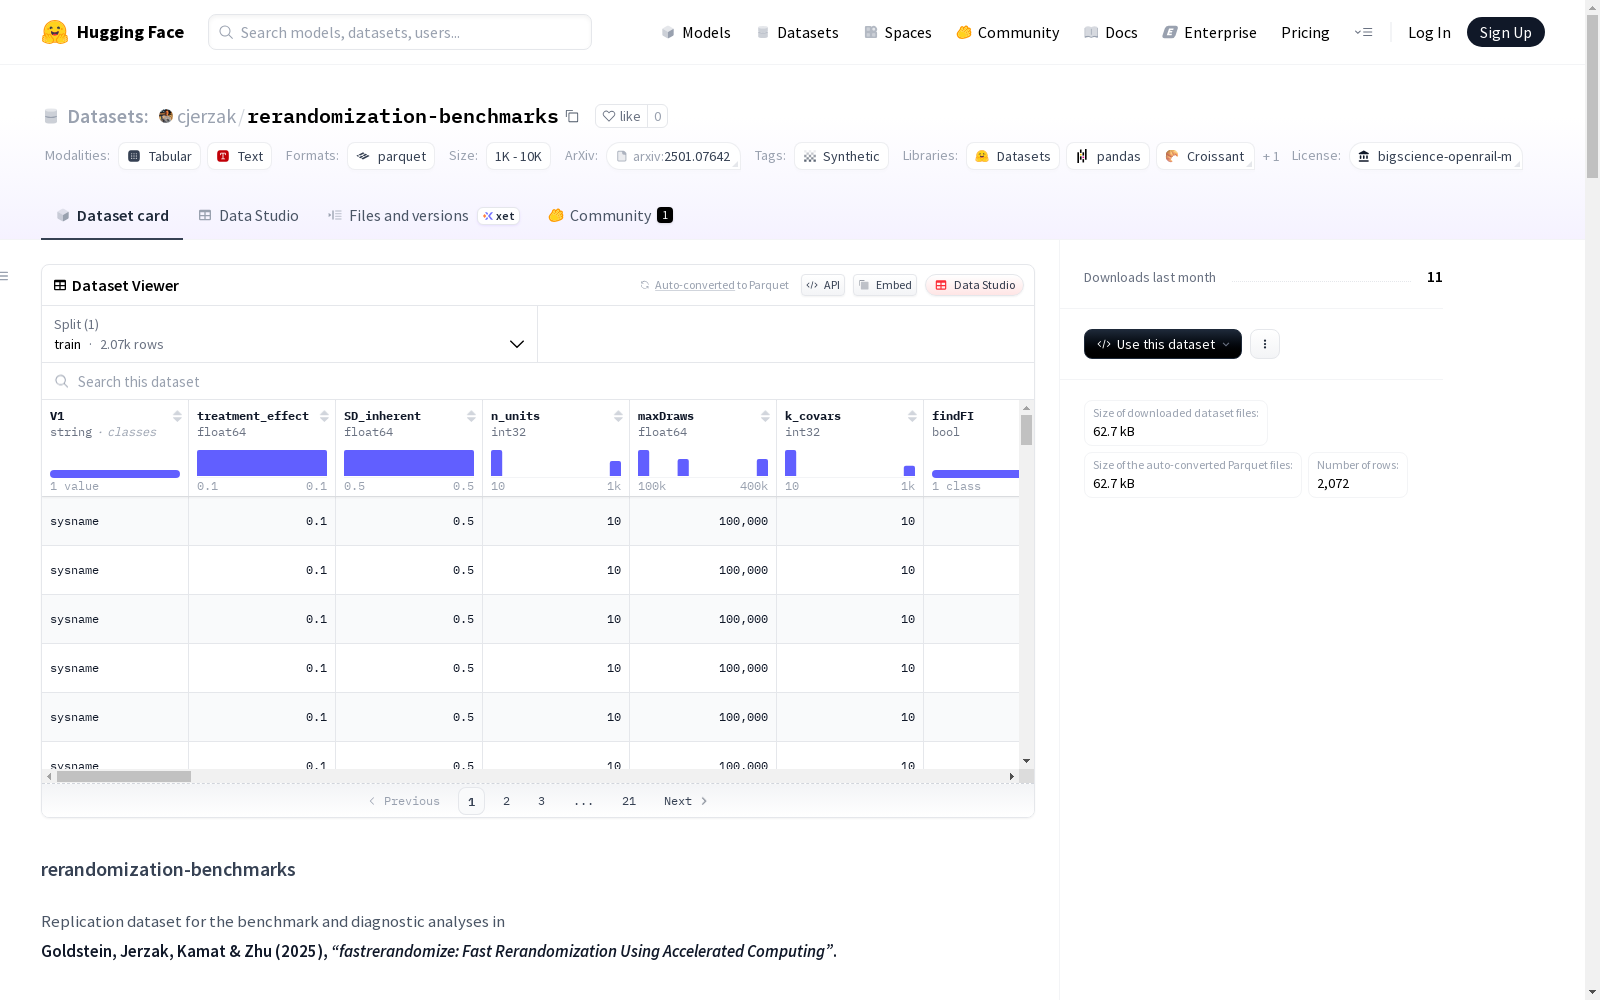
这是一个用于比较不同硬件后端、问题规模和重随机化规范的模拟基准结果的数据集,旨在评估和比较加速计算在重随机化过程中的性能。数据集包含了设计变量、性能指标、统计诊断和硬件系统元数据等信息。
数据集概述
基本信息
- 数据集名称: rerandomization-benchmarks
- 许可证: bigscience-openrail-m
- 数据规模: 1K<n<10K
- 标签: synthetic
数据集用途
该数据集包含用于比较以下内容的基于模拟的基准测试结果:
- 不同硬件后端(M4-CPU、M4-GPU、RTX4090、BaseR、jumble)
- 不同问题规模(样本量、协变量维度、蒙特卡洛抽样预算、精确与近似线性代数)
- 不同重新随机化规范(接受概率目标、是否使用基准区间)
文件结构
VaryNAndD_main.csv:论文中使用的所有配置的聚合基准测试/模拟结果VaryNAndD_main.parquet:相同表格的Parquet版本(在许多环境中加载更快)
主要列概述
核心设计变量
treatment_effect:模拟中使用的恒定处理效应SD_inherent:潜在结果的基线标准差n_units:实验单元总数k_covars:协变量数量prob_accept:目标接受概率maxDraws:候选随机化抽取的最大数量findFI:是否计算基准区间approximate_inv:是否使用近似逆/稳定线性代数Hardware:硬件/实现标签monte_i:蒙特卡洛复制索引
时间和硬件元数据
t_GenerateRandomizations:生成随机化池的时间(秒)t_RandomizationTest:基于随机化的推断时间(秒)randtest_time:在某些上下文中重复/便利版本的随机化测试时间sysname、machine、hardware_version:操作系统和机器级元数据nCores:CPU核心数cpuModel:CPU型号名称
数据应用
这些数据用于:
- 生成运行时基准图(CPU vs GPU vs 基线R / jumble)
- 计算加速因子和时间减少摘要
- 输入到论文中的宏命令
使用方式
Python使用
python from datasets import load_dataset ds = load_dataset("cjerzak/rerandomization-benchmarks", split="train")
或使用pandas: python import pandas as pd df = pd.read_csv("VaryNAndD_main.csv")
R使用
r library(data.table) bench <- fread("VaryNAndD_main.csv")
引用信息
bibtex @misc{goldstein2025fastrerandomizefastrerandomizationusing, title = {fastrerandomize: Fast Rerandomization Using Accelerated Computing}, author = {Rebecca Goldstein and Connor T. Jerzak and Aniket Kamat and Fucheng Warren Zhu}, year = {2025}, eprint = {2501.07642}, archivePrefix= {arXiv}, primaryClass = {stat.CO}, url = {https://arxiv.org/abs/2501.07642} }
联系方式
- 联系人: Connor T. Jerzak
- 邮箱: connor.jerzak@austin.utexas.edu
- 问题反馈: 使用fastrerandomize的GitHub仓库问题页面