
遇见数据集

ellamind/grips

收藏
Hugging Face2026-06-16 更新2026-06-21 收录
官方服务:

资源简介:

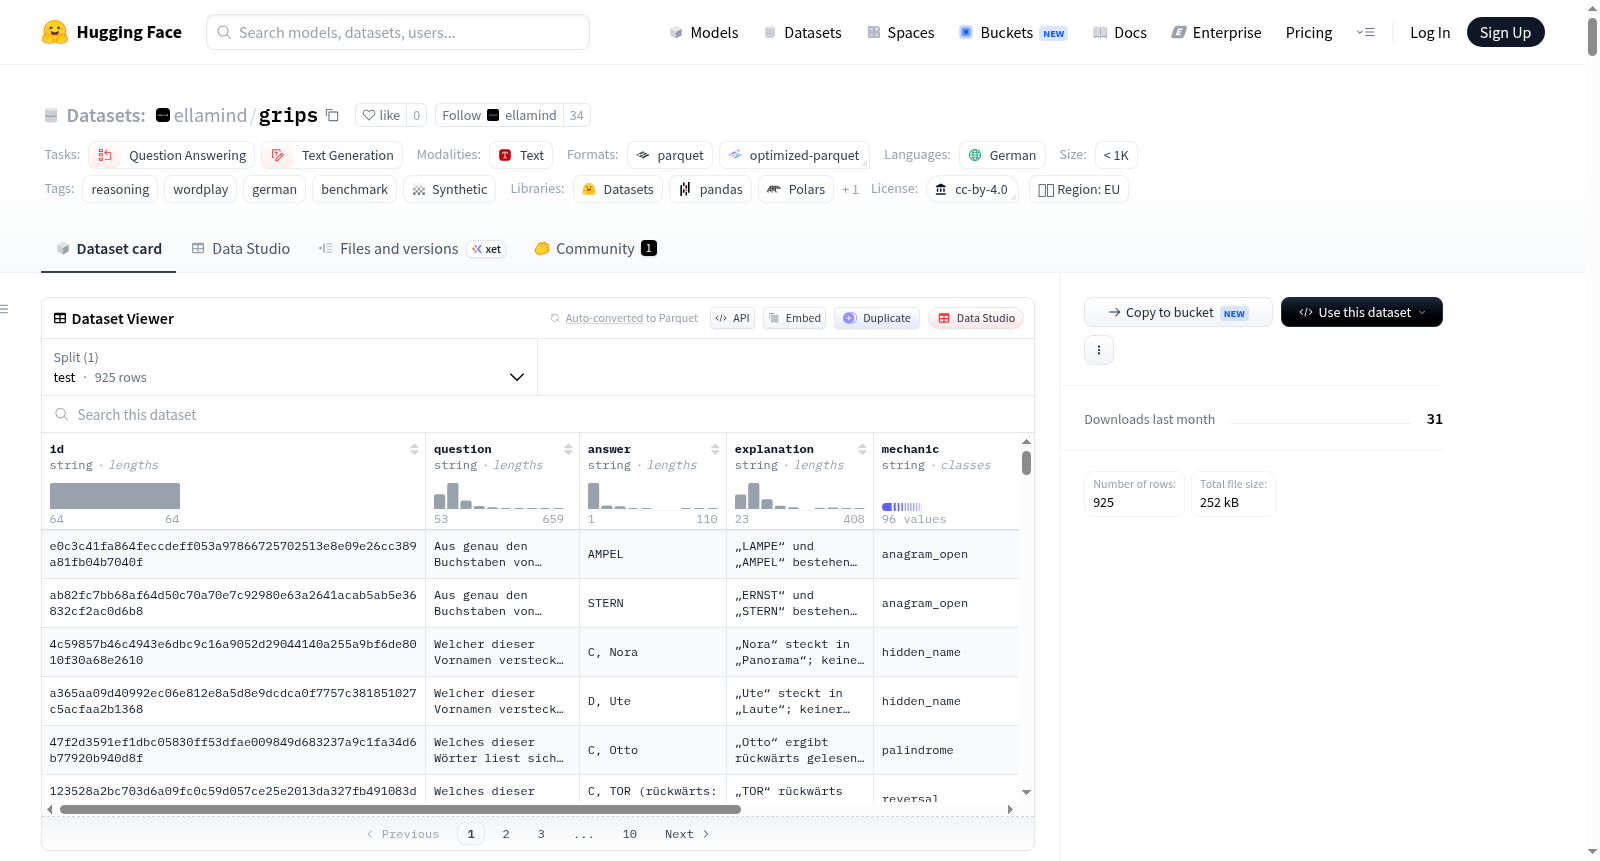
GRIPS是一个德语基准测试数据集,全称为“German Reasoning, Idioms, Puzzles & Sprachspiel”(德语推理、习语、谜题与文字游戏),其名称在德语中意为“智慧/头脑”。该数据集旨在评估模型的推理能力,包含925个德语谜题问题,涵盖96种不同的谜题机制,包括文字游戏、字谜、隐藏词、习语、双关语、算术文字问题和多步逻辑推理等。许多问题要求精确阅读、计数和多步推理,部分类别(如Schüttelreim、组合锁推理)仅前沿推理模型能可靠解决。数据集通过机器可验证,每个问题都是合成生成的,经过程序验证和人工审查以确保答案正确性,并存储了验证对象记录每个项目的具体机制和解决方案。数据集仅包含文本模态,其中356个为多项选择题,569个为开放答案题,并包含一个由100个困难项目组成的子集(标记为“hard=true”)。

*GRIPS* is the German word for **wits / brains** (*„Streng deinen Grips an!“*) and it describes the capability this benchmark probes: **G**erman **R**easoning, **I**dioms, **P**uzzles & **S**prachspiel (wordplay). Many questions reward precise reading, counting, and multi-step reasoning, and several categories (e.g. Schüttelreim, combination-lock deduction) are only reliably solved by frontier reasoning models. The benchmark is machine-verifiable and contains **925 German-language** quiz questions spanning **96 distinct puzzle mechanics**: wordplay, anagrams, hidden words, idioms, puns, arithmetic word problems, and multi-step logic deduction. Every item was synthetically generated, **programmatically verified**, and **human reviewed** to have the keyed answer; a stored `verification` object records the exact mechanic and solution for each item.
提供机构:
ellamind
搜集汇总
数据集介绍
ellamind/grips 数据集图片
构建方式
GRIPS数据集旨在评估德语语言模型在推理、习语理解、谜题及文字游戏等多维度的综合能力。该数据集包含925道德语文项,覆盖96种不同的谜题机制,如字谜、习语、算术文字题及多步逻辑推理。所有题目均通过合成方式生成,并经过程序化验证与人工审核以确保答案的准确性。每个样本均附有'verification'对象,详细记录了每道题的具体机制与解题方案。数据集分为多项选择(356题)和开放式答案(569题)两种形式,并特别设置了包含100道高难度题目的子集,这些题目对模型而言极具挑战性。
特点
GRIPS数据集的一大核心特色在于其高度的机器可验证性与人工审核的严谨性,确保了评估结果的客观性和可靠性。其题目设计精巧,涵盖从简单的字母计数到复杂的逻辑推理,如组合锁解码、真假话推理等,对模型的精确阅读、计数及多步推理能力提出了较高要求。数据显示,前沿推理模型在高推理努力参数下表现优异,如GPT-5.5正确率达99.8%,而关闭推理能力后,性能显著下降,凸显了该数据集作为推理能力标杆的价值。此外,'hard'子集的设置进一步区分了模型的推理深度。
使用方法
使用GRIPS数据集时,推荐采用单次回答、逐题评判的方式。评估过程建议利用一个独立的评判模型(如GPT-5.4-mini)对模型输出进行评分,以确保评分标准的一致性。用户可根据需求选择模型的推理努力程度(高/默认/关闭),以观察不同推理设置下的表现差异。本数据集特别适用于德语语言模型的公平基准测试,尤其在推理与文字游戏领域。所有题目均带有预定义的答案,便于自动化评估,其多样化的谜题机制也为模型的薄弱环节提供了细致的诊断依据。
背景与挑战
背景概述
GRIPS(German Reasoning, Idioms, Puzzles & Sprachspiel)数据集于近期由致力于德语自然语言推理的研究团队构建,旨在系统评估前沿语言模型在德语复杂推理与语言游戏中的表现。该数据集包含925道涵盖96种不同谜题机制的问题,涉及文字游戏、惯用语理解、谜语及多步逻辑推理等核心研究问题,所有题目均经过程序化生成及人工审核以确保答案的准确性与可验证性。GRIPS基准的提出,为德语自然语言处理领域提供了首个聚焦于语言与文化特殊性推理挑战的标准化评估工具,其影响力体现在高难度子集(hard subset)的设计上,当前最强的推理模型在该子集上的最佳准确率仅为98%,凸显了该基准对于推动模型深层次语言理解能力的价值。
当前挑战
GRIPS数据集所解决的领域问题核心在于德语推理与语言游戏能力的自动化评估,其挑战在于语言模型需处理高度依赖德语文化与语言特性的谜题类型(如Schüttelreim、Teekesselchen等),这些任务往往需要多步推理、精确计数以及对德语习惯用法的深刻理解,传统评估基准难以覆盖此类复杂语言现象。在构建过程中,研究团队面临的主要挑战包括:设计96种不同的谜题机制并确保每道题目的合成生成具备可验证性、在程序化生成的题目基础上进行严格的人工审核以消除歧义,以及构建一个高难度子集以区分不同模型的能力层次,该子集中的题目对模型而言极具挑战性,而人类却可能轻松解答,由此形成了对模型推理鲁棒性的严苛测试。
常用场景
经典使用场景
GRIPS数据集作为德国语言与推理能力的综合评测基准,经典使用场景聚焦于评估大语言模型在德语语言逻辑、习语理解、文字游戏及多步推理上的表现。该基准包含925道涵盖96种独特谜题机制的选择题与开放题,包括回文构词、隐词寻踪、组合锁推导、习语补全等,要求模型精准阅读、计数与逻辑演绎。通过程序化验证与人工审核确保答案可靠,特别适合对模型的德语语言深度理解与推理能力进行系统化、可复现的评估,是德语自然语言处理研究中不可或缺的标杆。
实际应用
在实际应用中,GRIPS数据集可服务于德语教育科技领域,作为智能辅导系统的诊断工具,精准识别学习者在习语理解、文字游戏逻辑及数学文字题上的薄弱环节。其机制多样的谜题库也适用于开发寓教于乐的德语语言学习应用,通过系统化谜题挑战提升用户的语感与推理能力。此外,该基准可用于企业级德语对话系统的质量评估,尤其在需要处理德语双关、隐语或文化特定表达的客服与内容生成场景中,确保模型输出的准确性与地道性,成为德语自然语言处理技术落地的关键评测环节。
衍生相关工作
围绕GRIPS数据集,已衍生出多项推动德语理解与推理研究的前沿工作。研究者基于其96种谜题机制,开发了针对特定推理类型(如组合锁推导与Schüttelreim)的专项增强训练策略,显著提升了模型在困难子集上的表现。另有工作通过分析不同模型在GRIPS上的成绩差异,揭示了推理能力与模型规模、努力参数设定之间的非线性关系,催生了关于高效推理预算分配的新理论。此外,该数据集启发了跨语言文字游戏基准的构建,将相似的谜题机制迁移至英语、法语等语言,为多语言推理能力对比提供了统一框架,促进了多语种自然语言理解的横向发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

