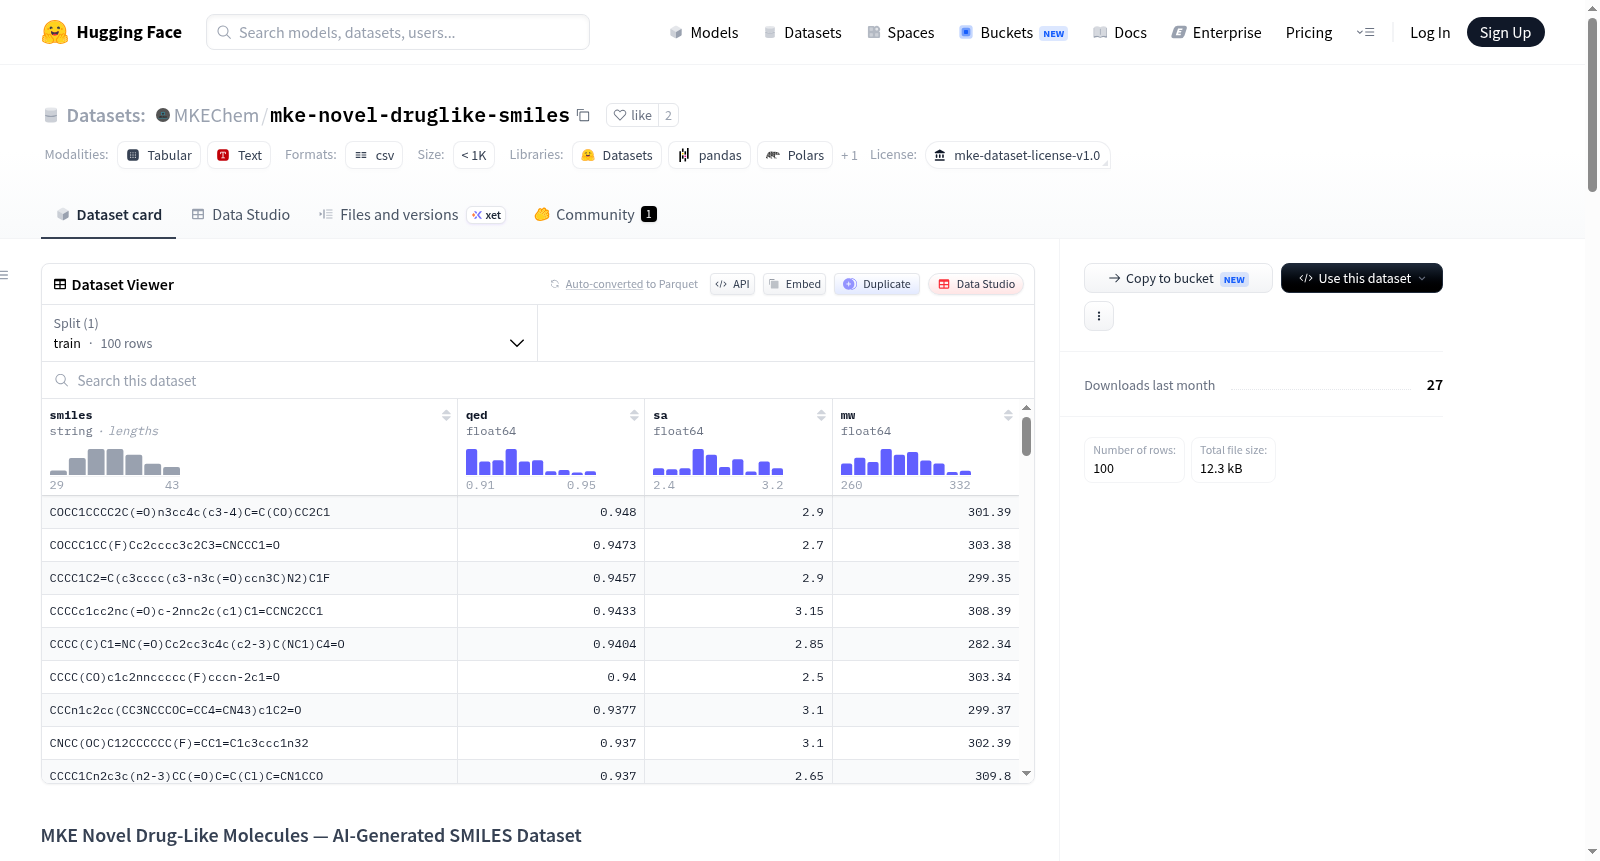
mke-novel-druglike-smiles
收藏资源简介:
MKE新颖类药分子数据集是一个由人工智能生成的、专注于药物发现的小分子化学数据集,包含22,153个经过严格验证和过滤的、具有类药性和生物利用度潜力的新颖小分子。每个分子以规范的SMILES字符串表示,并通过RDKit验证确保化学有效性。其核心特点是100%的新颖性,已针对MOSES、ZINC-250k和ChEMBL数据库中的超过464万已知化合物进行了查重验证。数据集中的分子满足类药性标准:定量估计药物相似性(QED)得分≥0.50(最高达0.947),合成可及性(SA)得分≤4.0(平均低于3.0),分子量(MW)≤500 Da(平均约280 Da),并且其脂水分配系数(LogP)等ADMET相关属性分布在理想治疗窗口内(例如平均LogP为1.53)。超过99%的分子符合Lipinski规则五。数据集以CSV格式(novel_molecules.csv)提供,包含smiles(SMILES字符串)、qed(QED得分)、sa(SA得分)、mw(分子量)和logp(LogP值)五个字段。该数据集适用于虚拟筛选、先导化合物优化、生成式人工智能模型基准测试以及基于片段的药物发现等应用场景。数据集由MKE Chemistry Platform使用定制化的80M参数Causal Transformer模型,在本地消费级硬件上基于180万分子训练数据生成,并采用严格的拓扑采样和新颖性过滤流程。数据集采用MKE Dataset License v1.0许可,允许商业研究使用。
The MKE Novel Drug-like Molecules Dataset is an AI-generated small molecule chemistry dataset focused on drug discovery. It contains 22,153 rigorously validated and filtered novel small molecules with drug-like properties and bioavailability potential. Each molecule is represented by a canonical SMILES string and validated for chemical validity using RDKit. Its core feature is 100% novelty, verified through deduplication against over 4.64 million known compounds from the MOSES, ZINC-250k, and ChEMBL databases. The molecules in the dataset meet drug-like criteria: Quantitative Estimate of Drug-likeness (QED) score ≥ 0.50 (up to 0.947), Synthetic Accessibility (SA) score ≤ 4.0 (average below 3.0), molecular weight (MW) ≤ 500 Da (average around 280 Da), and ADMET-related properties such as LogP are within an ideal therapeutic window (e.g., average LogP of 1.53). Over 99% of the molecules comply with Lipinskis Rule of Five. The dataset is provided in CSV format (novel_molecules.csv) with five fields: smiles (SMILES string), qed (QED score), sa (SA score), mw (molecular weight), and logp (LogP value). It is suitable for applications such as virtual screening, lead optimization, generative AI model benchmarking, and fragment-based drug discovery. The dataset was generated by the MKE Chemistry Platform using a customized 80M-parameter Causal Transformer model on local consumer-grade hardware, based on 1.8 million molecular training data, with strict topological sampling and novelty filtering. It is licensed under the MKE Dataset License v1.0, permitting commercial research use.
数据集概述
数据集名称: MKE Novel Drug-Like Molecules — AI-Generated SMILES Dataset
数据集地址: https://huggingface.co/datasets/MKEChem/mke-novel-druglike-smiles
许可证: MKE Dataset License v1.0(商业研究可用)
数据集规模与核心指标
- 总化合物数量: 22,154 个
- 有效性: 35.1%
- 新颖性: 100.0%(与 MOSES、ZINC-250k、ChEMBL 中 4,643,595 个已知化合物比对确认)
- 先导化合物筛选率: 100.0%
- 最高 QED 得分: 0.947
- 生成耗时: 约 25 分钟
分子特性与药物相似性
- Lipinski 五规则符合率: 21,955 / 22,154(99.1%)
- 平均 LogP(脂溶性): 1.53(理想治疗窗口)
- LogP 范围: -3.42 至 6.77
- 分子量: 硬上限 ≤ 500 Da(平均约 280 Da)
- 合成难易度(SA): 平均低于 3.0(易于合成)
- 药物相似性(QED): 所有分子 ≥ 0.50,前导分子可达 0.947
数据集格式
- 文件:
novel_molecules.csv - 字段说明:
| 字段名 | 数据类型 | 描述 |
|---|---|---|
| smiles | string | 规范 SMILES(经 RDKit 验证) |
| qed | float | 定量药物相似性估计(0–1) |
| sa | float | 合成可及性评分(1–10,分数越低越易合成) |
| mw | float | 分子量(Da) |
| logp | float | 辛醇-水分配系数(脂溶性/水溶性) |
生成方法
- 模型: 80M 参数因果 Transformer(FlashAttention 优化)
- 架构: 自定义 StableTransformerLayer,D_MODEL=768,12 头,12 层
- 训练数据: 来自 MOSES + ZINC-250k 的 180 万分子
- 采样策略: Top-P 核采样(p=0.85, T=0.80),附结构修复保护
- 新颖性过滤: 基于 MOSES、ZINC-250k 和 ChEMBL 的 4,643,595 个唯一 SMILES 的 RAM 索引参考集
- 运行硬件: NVIDIA RTX 5070(Blackwell),完全本地运行,无云端依赖
应用场景
- 虚拟筛选: 原生支持针对生物靶点进行筛选
- 先导化合物优化: 作为药物化学起始骨架
- AI/ML 研究: 在新型化学空间中对比生成模型性能
- 片段药物发现: 挖掘子结构用于新候选药物开发
访问与获取
- 完整数据集可通过 Gumroad 购买: https://mkechem.gumroad.com/
- 免费样本(100 个分子)可通过 Hugging Face 社区页申请
- 许可证: MKE Dataset License v1.0,允许商业研究使用