
遇见数据集

ghananlpcommunity/twi-english-citizens-budget

收藏
Hugging Face2026-06-06 更新2026-06-14 收录
官方服务:

资源简介:

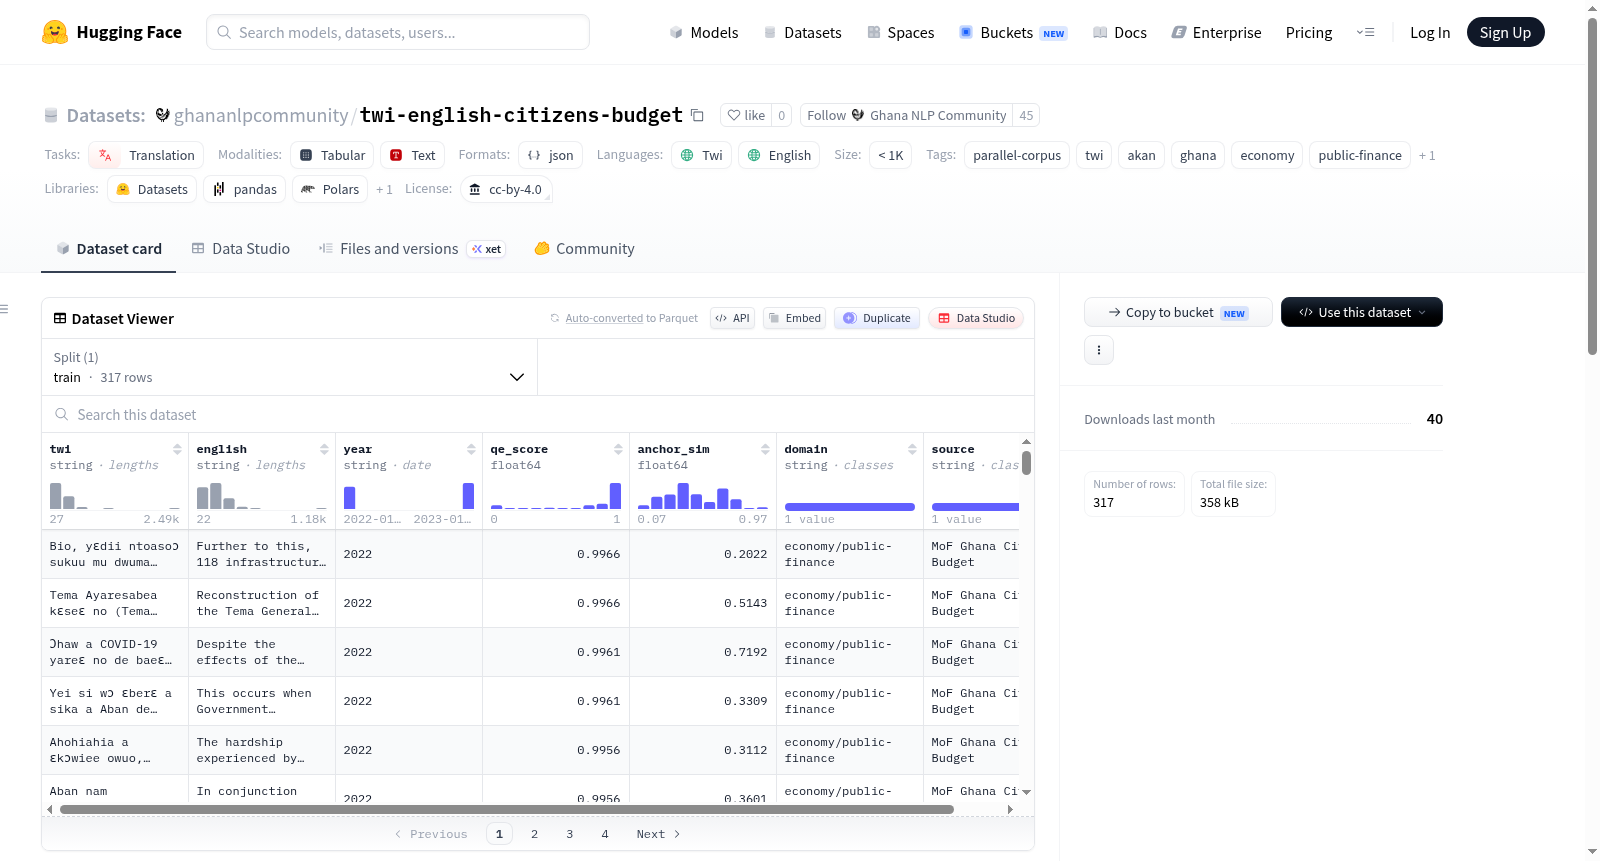
Twi–英语公民预算平行语料库是一个包含317对阿散蒂特维语(Asante Twi)和英语平行句子的数据集,专注于经济/公共财政领域。这些句子从加纳政府的《公民预算》出版物(2022年和2023年版)中提取和对齐,由加纳语言局翻译。数据集包括字段:twi(特维语句子)、english(英语句子)、year(来源出版年份)、qe_score(来自质量评估模型的正确翻译概率)、anchor_sim(结构对齐器的词汇锚相似度)以及domain和source(常量元数据)。为获取高精度子集,可过滤qe_score >= 0.9(约189对)。构建过程涉及破解字体编码、使用单调动态规划对齐器基于词汇锚对齐句子,并通过加纳NLP特维语-英语质量评估模型过滤。数据归属加纳政府财政部和加纳语言局,由加纳NLP社区对齐和整理。

The Twi–English Citizens Budget Parallel Corpus is a dataset containing 317 Asante Twi ↔ English parallel sentences in the economy/public-finance domain, extracted and aligned from the Government of Ghana Citizens Budget publications (2022 and 2023 editions, translated by the Bureau of Ghana Languages). Fields include: twi (Asante Twi sentence), english (English sentence), year (source publication year), qe_score (P(correct translation) from a quality estimation model), anchor_sim (lexical-anchor similarity from the structural aligner), and domain/source (constant metadata). For a high-precision subset, filter qe_score >= 0.9 (~189 pairs). It was built by cracking font encoding, aligning sentences with a monotone dynamic-programming aligner driven by lexical anchors, and filtering with the GhanaNLP Twi-English QE model. Source text is © Government of Ghana, Ministry of Finance, with Twi translations by the Bureau of Ghana Languages, curated by the GhanaNLP community.
提供机构:
ghananlpcommunity
搜集汇总
数据集介绍
ghananlpcommunity/twi-english-citizens-budget 数据集图片
构建方式
该数据集源自加纳政府《公民预算》2022及2023年度出版物,由加纳语言局提供特维语译本。构建过程中面临重大技术挑战:2022年版PDF嵌入过时加纳字体且编码映射断裂,导致提取文本呈现字体替代密码形态。研究者利用2023年清洁文档的字符四元组统计特征结合人工对照表破解该密码,并通过跨语言版本数字交叉验证确保准确性。句子对齐采用基于词汇锚点的单调动态规划算法,最终经加纳NLP社区特维-英语质量评估模型筛选,形成317条高质量平行句对。2021年扫描版PDF衍生的句对作为银标准数据留存于GitHub仓库。
使用方法
使用者可通过HuggingFace datasets库直接加载,数据包含`twi`、`english`、`year`、`qe_score`、`anchor_sim`及固定元数据字段。推荐按质量需求过滤:追求高精度可设定`qe_score >= 0.9`,需要更多数据时可放宽至`qe_score >= 0.7`或结合`anchor_sim`阈值。该语料适用于特维-英语机器翻译模型训练、跨语言经济文本分析及低资源语言平行语料构建方法论研究。完整数据管道开源在配套GitHub仓库,便于复现与扩展。
背景与挑战
背景概述
在非洲语言自然语言处理领域,低资源语言机器翻译面临数据匮乏的严峻挑战。加纳国库部发布的《公民预算》文件为阿坎语支系下的阿散蒂契维语与英语的平行语料构建提供了独特契机。该数据集由加纳NLP社区于2023年创建,聚焦于经济与公共财政领域,包含317句精确对齐的双语句对,源自2022和2023年的官方双语预算文件。这一工作不仅填补了契维语在资源稀缺领域翻译数据的空白,也为多语言政府文件处理、财政透明度增强及低资源语言神经机器翻译研究提供了基础资源,对西非语言技术社区具有显著推动意义。
当前挑战
该数据集面临的挑战集中于两大层面。其一,在领域问题层面,经济与公共财政文本包含大量专业术语、数字及固定表达,此类术语在低资源契维语中缺乏标准译法,导致机器翻译模型易产生语义偏差。其二,在构建过程中,2022年PDF文件采用遗留加纳字体,其ToUnicode映射损坏,文本提取需依赖字符四元组统计破解字体密码,并借助人工线索校正;2021年版本仅为扫描件,光学字符识别质量低下,仅能作为银标准数据使用。此外,句对齐依赖词汇锚点与动态规划算法,稀疏锚点下易产生错误匹配,后续需通过质量评估模型筛选,以平衡数据规模与精度。
常用场景
经典使用场景
在自然语言处理与机器翻译领域,该数据集最为经典的应用场景是作为低资源语言对翻译模型的训练与评估基准。通过提供317句经过严格对齐的阿散蒂特威语与英语平行语料,尤其是在经济与公共财政这一专业领域,它为研究者在缺乏大规模双语数据的情况下,探索小样本翻译、领域适应以及数据增强技术提供了宝贵基础。数据集附带的质量评估分数与词汇锚点相似度指标,更使其成为验证翻译质量与对齐策略有效性的理想测试平台。
解决学术问题
该数据集直面低资源语言机器翻译中数据稀缺与领域专业性的双重挑战。学术研究中,它解决了非洲语言(尤其是特威语)在资源匮乏条件下无法构建高质量翻译系统的核心问题。通过提供经过精心对齐与质量筛选的领域平行语料,研究者得以深入探索跨语言迁移学习、弱监督对齐算法及翻译质量评估模型的有效性。这一工作不仅推动了加纳本土语言的数字化进程,也为全球低资源语言自然语言处理研究提供了可复现的方法论与基准数据。
实际应用
在实际应用中,该数据集能够支撑加纳政府及国际组织在公共财政信息传播中的多语言服务需求。通过训练特威语与英语之间的翻译系统,可以自动或半自动地将预算文件、经济政策解释等关键政府信息转化为母语版本,帮助非英语使用者更好地理解国家财政分配与经济发展方向。此外,此类翻译系统还可延伸至教育、医疗等领域的多语言内容本土化,助力非洲地区的知识普及与公共服务的包容性提升。
数据集最近研究
最新研究方向
当前,低资源语言机器翻译研究正聚焦于经济政务等垂直领域的平行语料构建,特别是非洲本土语言如契维语(Twi)的数字化赋能。该Twi-英语公民预算平行语料库精选自加纳政府2022至2023年《公民预算》官方文件,包含317句经质量评估与词汇锚点双重筛选的平行句对,开创性地将财政透明度议题与语言技术相融合。这一资源不仅为加纳财政领域的神经机器翻译提供高精度训练基准,更通过破解遗产字体PDF编码难题,为全球非洲语言语料库建设树立了可复现的技术范式,切实推动低资源语言在公共治理场景中的智能应用,彰显了语言技术助力政府开放数据运动的深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

