遇见数据集

digital-detective-aic2026-webdataset

收藏
Hugging Face2026-09-08 更新2026-09-09 收录
官方服务:

资源简介:

该数据集是Digital Detective AIC2026竞赛训练数据集的重新打包版本,原始来源为QwertyNice/Digital_Detective_AIC2026中的train_stage1.zip。数据以TAR分片形式提供,包含图像及其对应的分割掩码,适用于图像分割任务。所有图像和掩码均保持原始压缩状态,未进行重新编码。数据集格式为plain-tar-v1,内部保留原始目录结构,而非WebDataset键后缀。此外,还提供了基于SegFormer-B2架构的训练代码和Jupyter Notebook示例(位于training/segformer_b2/目录下)。许可证为CC BY-SA 4.0。

This dataset is a repackaged version of the Digital Detective AIC2026 competition training dataset, originally sourced from train_stage1.zip in QwertyNice/Digital_Detective_AIC2026. The data is provided in TAR shards, containing images and their corresponding segmentation masks, suitable for image segmentation tasks. All images and masks are kept in their original compressed state without re-encoding. The dataset format is plain-tar-v1, preserving the original directory structure internally, rather than WebDataset key suffixes. Additionally, training code and Jupyter Notebook examples based on the SegFormer-B2 architecture are provided (located in the training/segformer_b2/ directory). The license is CC BY-SA 4.0.

创建时间:
2026-09-07
原始信息汇总

Digital Detective AIC2026 — TAR分片数据集

基本信息

  • 许可协议:CC BY-SA 4.0(知识共享-署名-相同方式共享4.0)
  • 任务类型:图像分割(image-segmentation)

数据集概述

本数据集是对 QwertyNice/Digital_Detective_AIC2026 数据集中 train_stage1.zip 文件的重新打包版本,采用TAR分片格式进行分发。

技术细节

  • 格式:plain-tar-v1 格式
  • 数据处理:图像和掩码文件均未经重新压缩,保持原始质量
  • 文件结构:原始目录名称保留在TAR内部
  • 完整性校验:manifest.json 文件中包含原始ZIP文件的SHA-256哈希值及每个TAR分片的校验和

配套资源

  • 包含训练代码和notebook(位于 training/segformer_b2/ 目录下)
  • 当前版本尚未包含训练好的模型权重
搜集汇总
数据集介绍
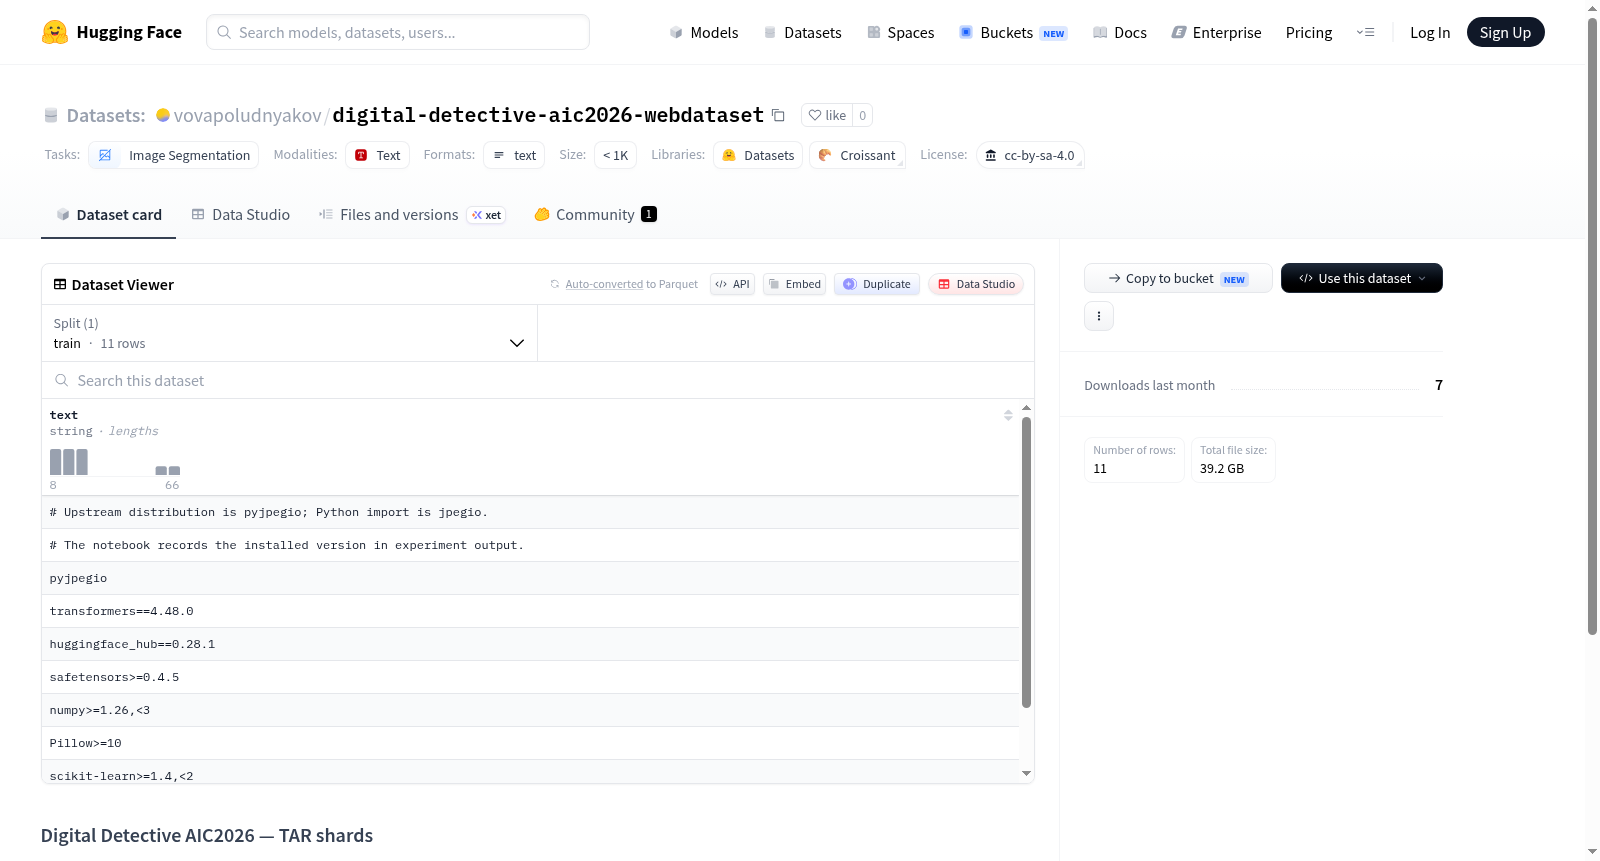
digital-detective-aic2026-webdataset 数据集图片
构建方式
本数据集源自数字侦探AIC2026挑战赛的训练数据,由QwertyNice/Digital_Detective_AIC2026原始数据集重新封装而成。原始数据以ZIP压缩包形式存储,本版本将其解压并重组为TAR分片格式,旨在提升数据加载的流式处理效率。封装过程中,图像与对应的分割掩码均未经任何压缩或修改,确保了数据的保真度。每个TAR分片内部保持了原始目录结构,而非采用WebDataset的键值命名方式,便于溯源与使用。为了保障数据的可验证性与完整性,manifest.json文件清晰记录了源ZIP文件的SHA-256哈希值以及每个TAR分片的校验和,全方位确保了数据在传输与存储中的一致性。
特点
该数据集的核心特点在于其高度的完整性与便捷的流式访问能力。作为图像分割任务的数据集,其包含的图像与掩码对像素级标注精准,直接服务于目标检测与分割模型的训练。TAR分片格式在保持数据原始形态的同时,大幅提升了I/O吞吐量,尤其适合大规模分布式训练场景。数据集遵循CC BY-SA 4.0许可协议,为学术与商业应用提供了明确的法律保障。此外,详尽的内置校验机制使得使用者能够便捷地验证每一份数据的可靠性,降低了数据损坏的风险,增强了实验的可复现性。
使用方法
本数据集专为图像分割任务设计,推荐使用配套的SegFormer-B2训练代码与notebook(见training/segformer_b2目录)进行模型训练。使用时,可依据实际需求直接加载TAR分片,由于保留了原始目录结构,开发者可灵活调整数据读取逻辑以适配不同的训练框架。在开始训练前,建议先校验manifest.json中记录的源文件哈希值,确保数据的完整性。当前仓库未包含预训练权重,使用者需从零开始训练或利用其他预训练模型进行微调。该数据集的流式特性使其极易集成于现代数据加载管道中,助力高效迭代。
背景与挑战
背景概述
该数据集名为Digital Detective AIC2026,由QwertyNice团队于近期创建并发布,旨在支持图像分割领域的研究与竞赛。作为AIC2026挑战赛的核心数据资源,其核心研究问题聚焦于高精度像素级场景解析,推动计算机视觉在复杂环境下的语义理解能力。数据集基于CC BY-SA 4.0许可协议分发,原始数据源自训练阶段的第一批压缩包,经重新封装为TAR分片格式以优化存储与加载效率。其发布为相关领域研究者提供了标准化的基准,有望促进分割模型的性能提升与算法创新,对该领域的发展具有显著的推动作用。
当前挑战
该数据集面临的挑战主要源于其所服务的图像分割任务本身及构建过程的复杂性。在领域问题层面,图像分割要求模型对每个像素进行精确分类,需应对光照变化、遮挡、物体边缘模糊及类别不平衡等固有难题,这对模型的表达能力与泛化能力提出了严苛要求。在构建过程中,数据封装需在不重新压缩图像与掩码的前提下,保持原始目录结构并精确记录文件校验和,以确保数据完整性和可复现性;同时,大规模数据的TAR分片化处理对存储管理与传输效率构成技术挑战,且需兼顾不同计算环境下的兼容性与训练流程的便捷性。这些挑战共同考验着数据集在实用场景中的鲁棒性与适用性。
常用场景
经典使用场景
该数据集作为图像分割领域的基准资源,其经典使用场景聚焦于语义分割模型的训练与验证。蕴含丰富的高分辨率图像及对应像素级标注掩码,适用于推动分割算法在复杂视觉场景中的性能提升。科研人员常借助其组织化的TAR分片格式,高效加载大规模数据批次,从而开展从编码器-解码器架构到基于Transformer的分割模型(如SegFormer)的端到端实验,以评估模型在精细边界与多尺度目标上的泛化能力。
实际应用
在实际应用中,该数据集为需要精准像素级识别的视觉系统奠定了训练基石,例如自主导航中的道路与障碍分割、医学影像中器官或病灶区域的勾勒,以及工业质检中表面缺陷的定位。得益于其TAR分片设计,数据可高效流式读取,便于嵌入分布式训练管线,加速面向实时应用的模型部署。由此,该数据集架起了学术研究与产业需求之间的桥梁,使分割技术更迅速地转化为生产力工具。
衍生相关工作
围绕该数据集,已衍生出若干具有影响力的研究方向,例如基于注意力机制的分割模型优化、轻量化网络的剪枝与蒸馏,以及利用自监督预训练提升像素级任务性能的探索。此外,该数据集的发布还催生了关于数据增强策略、标签噪声鲁棒性及域随机化方法的系统性评测,其组织格式亦启发了高效率的WebDataset格式下的数据加载库设计,这些工作共同促进了图像分割社区在方法论与应用层面的持续创新。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务