遇见数据集

Baby Names Dataset

收藏
github2026-08-05 更新2026-08-06 收录
官方服务:

资源简介:

按起源、宗教、国家、星座和性别分类的婴儿名字结构化数据集,适用于开发者、研究人员和教育工作者。

A structured dataset of baby names categorized by origin, religion, country, zodiac sign, and gender, intended for developers, researchers and educators.

创建时间:
2026-08-03
原始信息汇总

数据集概述

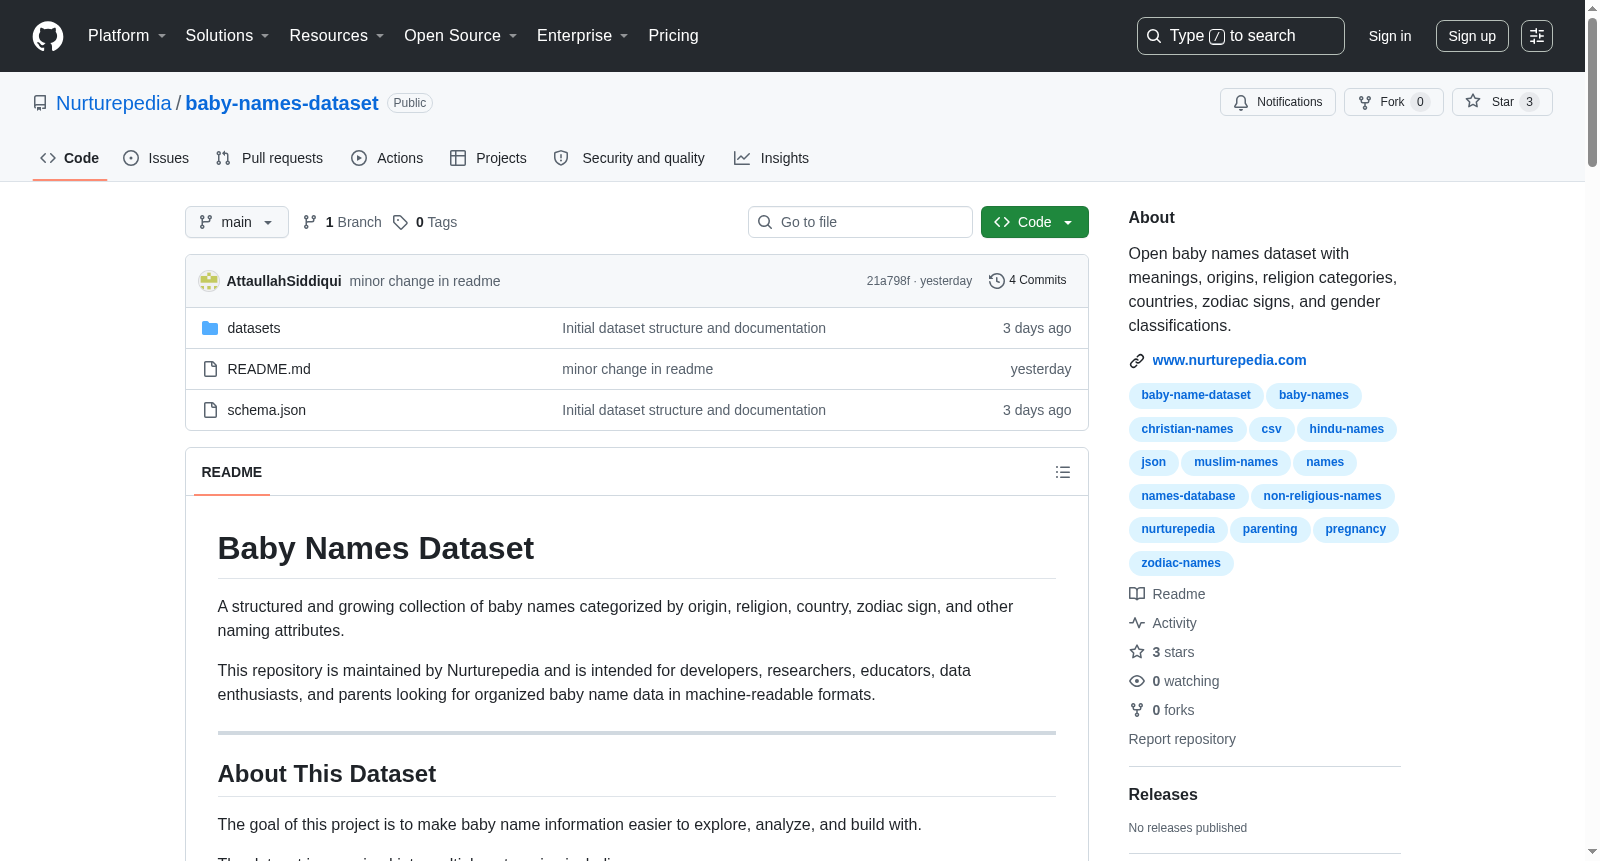
Baby Names Dataset 是一个结构化且持续增长的婴儿名字数据集,由 Nurturepedia 维护,旨在为开发者、研究人员、教育工作者、数据爱好者及家长提供机器可读格式的规范化婴儿名字数据。


数据集分类

数据集按多种维度进行分类,主要包含以下四大类别:

  • 基于起源(Origin-Based Names)
  • 基于宗教(Religion-Based Names)
  • 基于国家(Country-Based Names)
  • 基于星座(Zodiac-Based Names)

数据集结构

text datasets/

├── countries/ │ ├── origin/ │ ├── religion/ │ └── zodiac/

起源类(Origin)

包含 11 个文件arabic.jsonenglish.jsonhebrew.jsonhindi.jsonlatin.jsonsanskrit.jsonspanish.jsonurdu.jsonfrench.jsonirish.jsongermanic.json

宗教类(Religion)

包含 4 个文件islam.jsonhinduism.jsonchristianity.jsonneutral.json

星座类(Zodiac)

包含 12 个文件,对应十二星座:aries.jsontaurus.jsongemini.jsoncancer.jsonleo.jsonvirgo.jsonlibra.jsonscorpio.jsonsagittarius.jsoncapricorn.jsonaquarius.jsonpisces.json

国家类(Country)

包含 14 个文件australia.jsoncanada.jsonunited-states.jsonindia.jsonunited-kingdom.jsonpakistan.jsonireland.jsonnigeria.jsonsouth-africa.jsonunited-arab-emirates.jsonsaudi-arabia.jsonspain.jsongermany.jsonfrance.json


数据记录示例

每条记录包含 6 个字段,例如:

json { "name": "Ayaan", "gender": "Boy", "meaning": "Gift of God", "origin": "Arabic", "religion": "Islam", "country": "Pakistan", "zodiac": "Aries" }


应用场景

该数据集可用于:

  • 婴儿命名应用程序
  • 命名研究
  • 育儿平台
  • 教育项目
  • 数据科学项目
  • 搜索与推荐系统
  • AI 与语言模型实验
  • 文化与语言研究

相关资源

数据集托管于 GitHub 仓库:https://github.com/Nurturepedia/baby-names-dataset ,并关联 Nurturepedia 平台的多个工具与目录页面(如婴儿名字目录、各宗教名字页面、名字查找器、数字命理计算器等)。


贡献与许可

  • 欢迎通过提交 issue 或 pull request 提供建议、修正或改进。
  • 该数据集基于 MIT License 发布。
搜集汇总
数据集介绍
Baby Names Dataset 数据集图片
构建方式
该数据集由Nurturepedia平台精心维护,以结构化格式系统收录了全球范围内的婴儿名字,并按照起源、宗教、国家和星座等多元属性进行分类整理。数据以JSON格式存储于分门别类的目录中,涵盖阿拉伯、英语、希伯来语等起源类别,伊斯兰教、印度教、基督教等宗教类别,以及十二星座和多个国家的名称子集。每条记录均包含名字、性别、含义、起源、宗教、国家和星座等字段,构建了一套层次分明、易于扩展的命名知识库。
特点
该数据集的最大特色在于其多维度的分类体系,融合了文化、宗教与地域的丰富背景,为婴儿名字赋予了深层的语义关联。数据覆盖广泛,从常见的英语、法语名字到具有宗教特色的伊斯兰、印度教名字,乃至按星座划分的名字集合,充分满足了多样化的命名需求。同时,数据集采用开放、透明的维护机制,鼓励社区贡献与修正,确保了数据的时效性与准确性,为跨文化研究与个性化命名应用提供了坚实的数据基础。
使用方法
数据集以JSON格式提供,便于开发者直接解析与集成。用户可根据实际应用场景,灵活选用相应分类的文件,例如开发婴儿命名应用时,可结合起源与宗教类别进行精准推荐;进行数据科学研究时,可分析不同文化背景下名字的分布与趋势。此外,数据集还支持与Nurturepedia平台上的在线工具(如名字查找器、数字命理计算器)结合使用,为家长、教育工作者及研究人员提供了一个全面、易用的命名数据工具集。
背景与挑战
背景概述
婴儿姓名数据集由Nurturepedia平台维护,旨在系统化整合全球多元文化中的婴儿命名资源。该数据集以结构化JSON格式收录了基于起源、宗教、国家及星座等维度的姓名信息,每条记录附有含义、性别及文化归属等属性。其创建源于对跨文化命名模式研究及育儿应用开发的需求,服务于开发者、研究者、教育工作者及家长群体。该数据集促进了命名文化的数字化探索,为语言学研究、推荐系统构建及人工智能模型训练提供了宝贵语料,在推动文化数据开放共享方面具有积极意义。
当前挑战
该数据集面临的主要挑战包括:如何确保跨文化姓名分类的准确性与文化敏感性,避免因翻译或音译差异导致的归属歧义;构建过程中需持续扩充多元文化覆盖范围,同时维护数据质量与一致性,以应对不同国家、宗教及语言背景下姓名含义的复杂映射;此外,数据集的开放性要求建立有效的社区贡献机制,以解决用户提交数据中的重复、冲突及错误修正问题,保证数据集的动态更新与长期可靠性。
常用场景
经典使用场景
该数据集以其精细的多维度分类体系,在命名学、文化人类学及计算语言学领域开辟了广阔的研究视野。其经典应用场景集中于基于文化根源、宗教信仰及地域特征的姓名语义分析,通过结构化JSON格式,研究者能够高效地实现跨文化姓名对比、语源追溯及命名趋势挖掘,为量化探究社会文化变迁与命名习俗演化提供了坚实的数据基石。
衍生相关工作
该数据集孕育了一系列衍生性研究工作,如基于神经网络的姓名语源分类器、融合文化本体的命名趋势预测模型,以及面向多语种环境的姓名音译与规范化系统。同时,它在NLP微调、知识图谱构建及数据可视化叙事等方向催生了众多创新探索,促进了开源社区中有关命名文化多样性的数据协作与标准制定,推动了相关技术生态的持续繁荣。
数据集最近研究
最新研究方向
在命名学与文化计算交叉领域,Baby Names Dataset的提出为量化研究姓名背后的文化基因与社会变迁提供了关键数据支撑。该数据集以多维度分类体系(起源、宗教、国家、星座)整合全球命名资源,不仅服务于传统的育儿应用与命名工具,更在人工智能与语言模型实验中开辟了新的探索路径,支持从文化语言学视角分析命名趋势的演化规律,推动个性化推荐系统与文化语义理解技术的深度融合。其结构化、可扩展的设计为跨文化比较研究及命名行为的计算社会学分析奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务