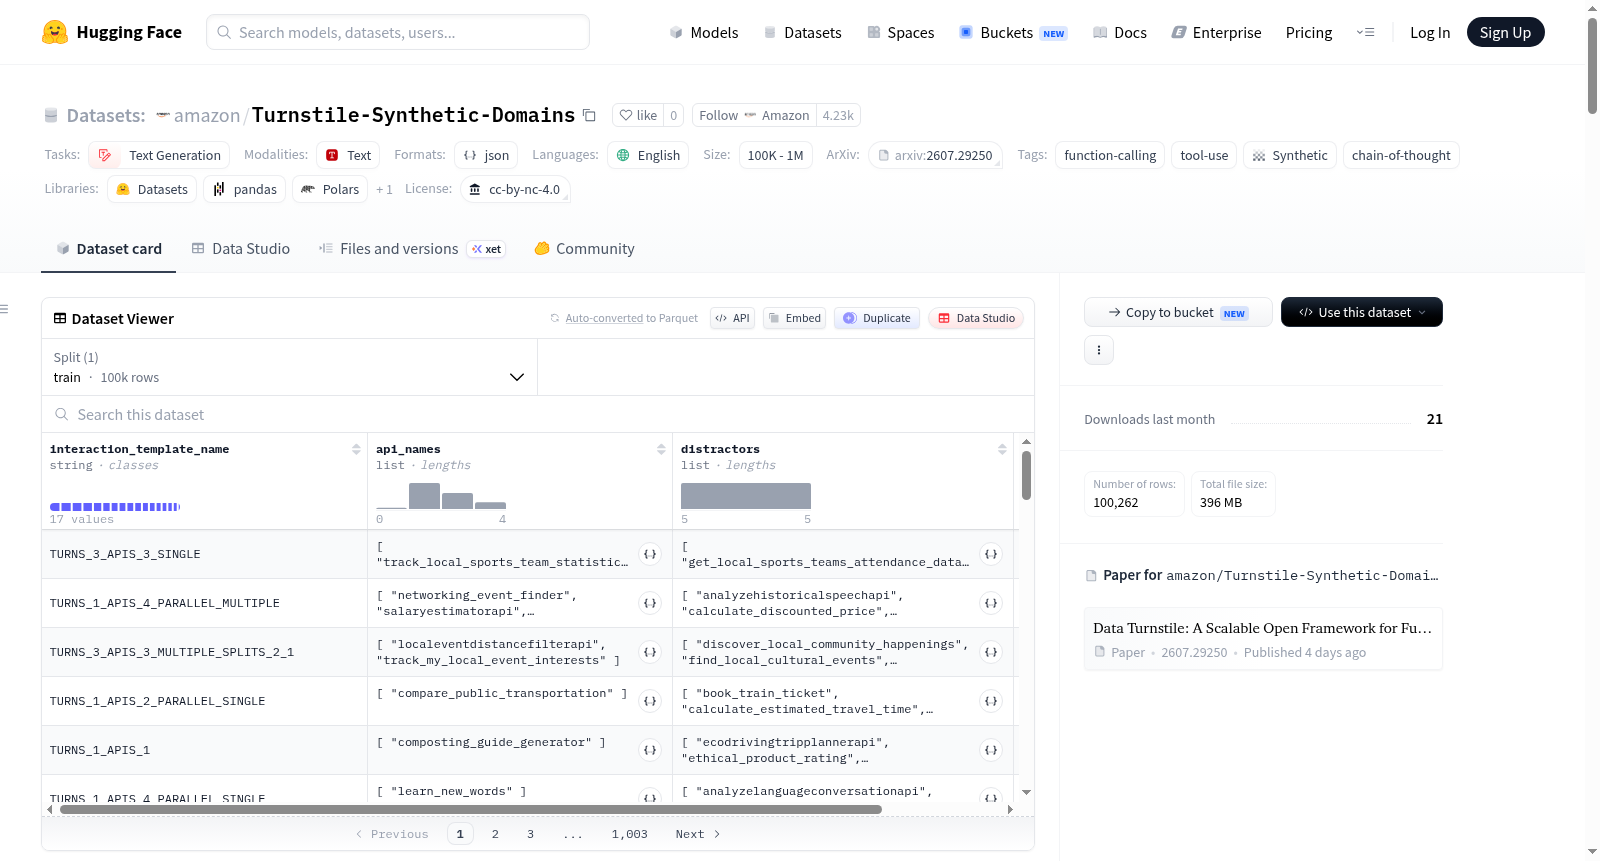
Turnstile-Synthetic-Domains
收藏资源简介:
Turnstile-Synthetic-Domains数据集由亚马逊AGI团队创建,是一个基于Data Turnstile框架生成的高质量函数调用合成数据集。该数据集包含1000多个API定义和超过10万条多轮交互样本,平均每条交互包含约972个令牌,涵盖从简单单轮到复杂多API调用场景。数据集通过解耦角色生成、逐步骤验证和错误反馈循环的流程创建,确保API调用格式正确、参数真实且交互自然。该数据集旨在为小型语言模型提供高质量监督微调数据,解决其在工具使用任务中训练数据稀缺和噪声大的问题,显著提升模型在函数调用基准上的表现。
The Turnstile-Synthetic-Domains dataset, created by the Amazon AGI team, is a high-quality function-calling synthetic dataset generated based on the Data Turnstile framework. It contains over 1000 API definitions and more than 100,000 multi-turn interaction samples, with an average of approximately 972 tokens per interaction, covering scenarios ranging from simple single-turn to complex multi-API call cases. The dataset is developed through a workflow that decouples role generation, step-by-step validation, and error feedback loops, ensuring correct API call formats, realistic parameters, and natural interactions. This dataset aims to provide high-quality supervised fine-tuning data for small language models, addressing the issues of scarce training data and high noise in tool-use tasks, and significantly improving the model's performance on function-calling benchmarks.
Data Turnstile - Synthetic Domains 数据集详情
数据集概览
这是一个大规模的函数调用交互合成数据集,包含思维链推理轨迹,专为训练小型语言模型在工具使用任务上的能力而设计。
| 指标 | 数值 |
|---|---|
| 交互数量 | 100,262 |
| 唯一API数量 | 1,025 |
| 每次交互的干扰项数量 | 5 |
| 模板类型 | 17 |
| 每次交互平均角色数 | ~10 |
| 每次交互平均令牌数 | ~972 |
| 语言 | 英语 |
| 生成模型 | Qwen2.5-32B-Instruct |
文件结构
- data.jsonl — 包含100,262条交互记录(每行一个JSON对象)
- api_definitions.json — 包含1,025个带有完整参数模式的API定义
数据模式
每条交互记录包含以下字段:
| 字段 | 描述 |
|---|---|
interaction_template_name |
描述交互结构的模板类型 |
api_names |
实际调用的API列表 |
distractors |
可用但未使用的5个额外API(用于训练工具选择能力) |
interaction |
有序的角色字典列表 |
角色类型
| 角色 | 描述 |
|---|---|
SYSTEM |
用于交互基础的时间日期上下文 |
USER |
自然语言用户请求 |
THINKING |
解释API选择和参数映射的思维链推理 |
API_CALL |
Python语法函数调用 |
API_OBS |
模拟的API响应(JSON对象) |
ASST |
助手对用户的自然语言响应 |
模板类型
单轮模板(1个用户请求,1-4次API调用)
TURNS_1_APIS_1— 单次调用TURNS_1_APIS_N_PARALLEL_SINGLE— 对同一API的N次不同参数调用TURNS_1_APIS_N_PARALLEL_MULTIPLE— 对多个不同API的N次调用*_SPLITS_X_Y— N次调用分布在子组中
多轮模板(2-3个顺序用户请求)
TURNS_2_APIS_2_SINGLE/TURNS_2_APIS_2_MULTIPLE— 2轮,每轮1次调用TURNS_3_APIS_3_SINGLE/TURNS_3_APIS_3_MULTIPLE— 3轮,每轮1次调用
无关性模板
TURNS_1_IRRELEVANCE— 用户请求无法由可用API满足(无API_CALL/API_OBS)
模板分布
主要模板及占比:
TURNS_1_APIS_1:8.7%TURNS_1_APIS_2_PARALLEL_SINGLE:8.0%TURNS_1_APIS_3_PARALLEL_SINGLE:8.5%TURNS_1_APIS_4_PARALLEL_SINGLE:8.1%TURNS_2_APIS_2_SINGLE:7.1%TURNS_1_APIS_2_PARALLEL_MULTIPLE:6.3%- 其余模板占比从2.5%到6.0%不等
使用方法
训练选项
- 带思维链训练:使用所有角色(包括
THINKING)训练模型在调用工具前进行推理 - 无思维链训练:移除
THINKING角色,进行直接函数调用训练
并行API调用处理
并行API调用以顺序方式存储在交互中(API_CALL → API_OBS → API_CALL → API_OBS),如需分组(如BFCL格式),可将连续的API_CALL/API_OBS对合并为单个工具调用轮次。
生成方法
使用 Data Turnstile 框架生成:
- 角色级分解:将交互分解为类型化角色的DAG,由教师LLM逐个生成并验证
- 结构验证:每个角色通过格式检查(JSON解析、API模式一致性、引用一致性)
- 先生成后验证:质量门控检查每个角色的正确性
- 带反馈的重试:失败角色在错误上下文中重新生成(最多3次重试)
生成硬件:p5.48xlarge EC2实例(8xH100),使用vLLM服务。
基准测试结果
使用Qwen3-0.6B模型在BFCL v3单轮基准上评估(无思维链模式,移除THINKING角色):
| 模型 | 总体准确率 | 非实时准确率 | 实时准确率 | 无关性 |
|---|---|---|---|---|
| Qwen3-0.6B基础(无思维链) | 58.20% | 63% | 53.40% | 90.60% |
| Qwen3-0.6B基础(思维链) | 67.40% | 72.30% | 62.50% | 81% |
| Qwen3-0.6B + 本数据集(无思维链) | 67.40% | 75.90% | 58.90% | 75.60% |
使用本数据集训练可将Qwen3-0.6B的准确率从58.2%提升至67.4%(+9.2个百分点),在无思维链推理开销的情况下达到基础模型思维链模式的性能。
局限性
- 合成API:1,025个API定义为合成生成,非真实服务
- 合成数据:所有交互由LLM生成,可能无法反映真实使用分布
- 模拟观测:API响应为生成内容,非真实执行结果
- 仅英语:所有内容均为英文
- 教师偏差:Qwen2.5-32B-Instruct的模式和偏差可能已传入生成数据
伦理考量
- 无真实PII:所有姓名、邮箱、电话和地址均为合成
- 无冒犯性内容:API定义已过滤人口统计、成人内容、武器和监控领域
- 无有害工具使用:API不模拟危险或非法活动
- 开源权重生成:使用开源权重模型生成,无专有数据污染
许可证
- 数据集:CC-BY-NC-4.0
引用信息
论文标题:"Data Turnstile: A Scalable Open Framework for Function-Calling Data Generation",作者:Goutham Ramakrishnan 和 Megha Sharma,年份:2026,arXiv编号:2607.29250。
联系方式
- Goutham Ramakrishnan(gorama@amazon.com)
- Megha Sharma(meghshar@amazon.com)