
INSAIT-Institute/rit-winogrande
收藏官方服务:
资源简介:
Winogrande是一个代词消解基准测试,旨在通过Winograd风格的例子测试常识推理。
Winogrande is a pronoun-resolution benchmark designed to test commonsense reasoning through Winograd-style examples.
提供机构:
INSAIT-Institute搜集汇总
数据集介绍
构建方式
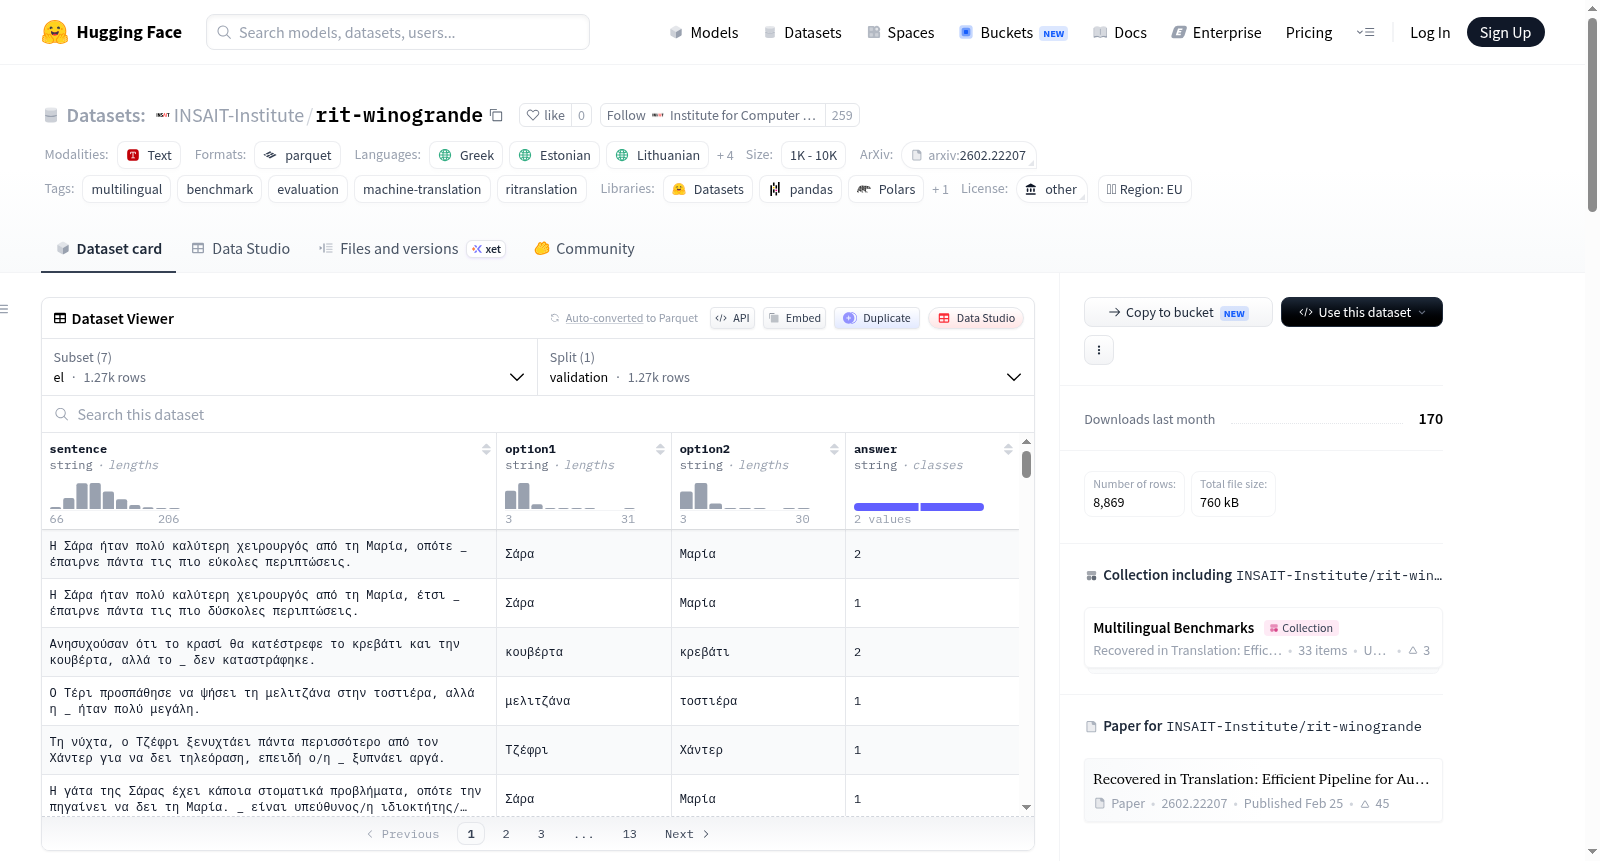
rit-winogrande数据集源自RiTranslation研究,旨在通过自动化翻译流水线将英语代词消解基准测试Winogrande扩展至多语言场景。其构建方式基于INSAIT-Institute发布的跨语言评测集合,将原始英文Winogrande样本经由精心设计的机器翻译与质量增强策略(包括Self-Check、Best-of-N、通用自我改进及T-RANK多轮排序方法)处理,生成了乌克兰语、罗马尼亚语、立陶宛语、斯洛伐克语、希腊语、爱沙尼亚语和土耳其语共七个语言版本。每个语言版本均保留了原始数据集的结构与字段,并作为独立的Hugging Face配置存储于同一仓库中,便于研究人员按需调用。
特点
该数据集的核心特点在于其多语言覆盖与高翻译质量的平衡。作为专为评测大型语言模型跨语言常识推理能力设计的基准,rit-winogrande保留了Winogrande原版中基于代词消解的任务形式,每条样本包含一句上下文、两个选项及标准答案。七个语言版本均采用统一的Parquet格式存储,确保了数据加载的效率和一致性。此外,数据集严格遵循原始评估集的分割,仅提供验证集,适用于零样本或少样本的多语言模型行为分析,尤其关注机器翻译评测数据中可能存在的语言歧义与文化适应性挑战。
使用方法
使用rit-winogrande数据集时,可通过Hugging Face的datasets库直接加载,指定所需语言配置即可获取对应验证集。例如,加载乌克兰语版本可调用load_dataset('INSAIT-Institute/rit-winogrande', 'ukr')。用户也可通过get_dataset_config_names函数查询所有可用语言配置。数据集字段包括sentence、option1、option2和answer,便于直接用于模型的推理与评估。研究人员应将其视为跨语言评测工具,在分析结果时需注意机器翻译可能引入的语义偏差,同时参照RiTranslation论文中的翻译策略进行解释。
背景与挑战
背景概述
Winogrande Multilingual数据集由保加利亚索菲亚大学INSAIT研究所的研究团队于2026年创建,核心人物包括Hanna Yukhymenko、Anton Alexandrov和Martin Vechev。该数据集源自RiTranslation框架,旨在通过自动化翻译流水线将经典的英文Winogrande常识推理基准扩展至七种中欧与东欧语言(乌克兰语、罗马尼亚语、立陶宛语、斯洛伐克语、希腊语、爱沙尼亚语和土耳其语)。Winogrande本身是一种基于Winograd模式设计的代词消解基准,广泛用于评估大语言模型的常识推理能力。该多语言版本的发布显著提升了低资源语言在自然语言理解评估中的可用性,为跨语言模型可比性研究提供了标准化工具,并推动了多语言评估基准的公平性与覆盖面进步。
当前挑战
该数据集所解决的领域挑战在于:现有常识推理基准高度集中于英语,导致其他语言模型评估缺乏可靠的跨语言对照标准,难以衡量模型在非英语语境中的真实推理水平。构建过程中面临的核心挑战包括:机器翻译引入的语言歧义和语义漂移,需通过自检(Self-Check)、最佳N选(Best-of-N)及通用自我改进(USI)等策略缓解;低资源语言中平行语料匮乏,需设计高保真度的自动化翻译与质量排序方法(如T-RANK);同时需要保持各语言版本在格式、字段与评估逻辑上的一致性,避免因翻译差异引入评测偏差。
常用场景
经典使用场景
Winogrande多语言数据集是代词消歧与常识推理领域的标杆性评估基准,其经典使用场景聚焦于衡量语言模型在跨语言环境下的语义理解与推理能力。该数据集通过构建富含指代歧义的Winograd风格句子对,迫使模型在给定上下文中精准判别代词的指代对象,从而检验其对隐含常识知识的掌握程度。研究者常借助此数据集的验证集部分,评估多语言预训练模型或机器翻译系统的鲁棒性,尤其关注模型在希腊语、罗马尼亚语、土耳其语等低资源语言上的表现差异,以此揭示当前模型在跨语言推理任务中的局限性。
衍生相关工作
围绕该数据集衍生了一系列影响深远的研究工作。RiTranslation论文提出的自动化翻译管线及T-RANK质量排序方法,为多语言基准的规模化构建确立了新范式。基于该基准,研究者进一步探索了测试时计算增强策略,如自我校验与通用自我改进机制,显著提升了翻译质量与模型评估的信度。同时,该数据集催生了关于跨语言数据污染检测的研究,并启发了面向低资源语言的少样本常识推理框架设计,推动了多语言自然语言处理从单语评价向多语协同评估的范式转变。
数据集最近研究
最新研究方向
当前,rit-winogrande数据集的核心研究方向聚焦于多语言常识推理能力的评估与自动化基准测试构建。该数据集源自RiTranslation框架,通过高效的机器翻译流水线将经典的Winogrande代词消解基准扩展至乌克兰语、罗马尼亚语、立陶宛语等七种东欧与南欧语言,旨在弥补非英语语言在复杂语义推理评测中的空白。前沿探索中,研究者借助Self-Check、Best-of-N及Universal Self-Improvement等测试时计算策略,显著提升了翻译质量与多语言大模型评估的可靠性;同时,T-RANK多轮排序方法的引入为跨语言一致性验证提供了新范式。这一工作不仅推动了低资源语言NLP评测的标准化,更通过高保真翻译技术为全球化视角下的常识推理研究注入了新动能,对评估AI系统在多文化语境中的鲁棒性具有深远意义。
以上内容由遇见数据集搜集并总结生成


