precancer-omics-data
收藏资源简介:
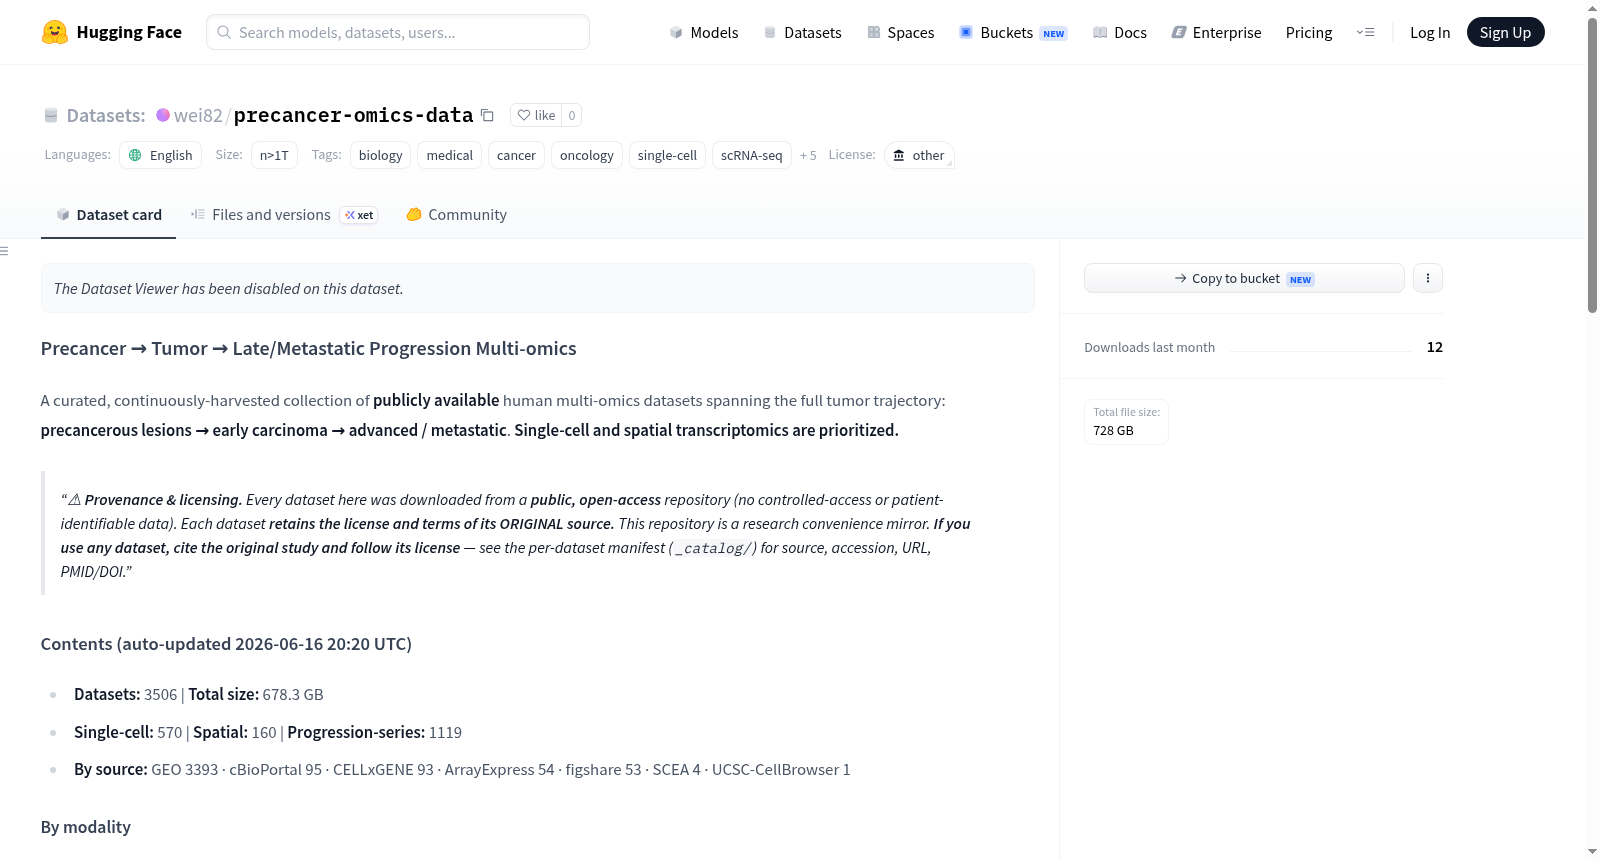
Precancer-to-Tumor Progression Multi-omics 是一个精心策划、持续收集的公开可用人类多组学数据集集合,专注于研究从癌前病变到早期癌变,再到晚期/转移性肿瘤的完整进展轨迹。该数据集优先收录单细胞转录组测序(scRNA-seq)和空间转录组学数据,同时也包含其他多种组学模态。数据集规模庞大,包含3502个独立数据集,总数据量达672.1 GB,其中包含569个单细胞数据集、160个空间数据集以及1119个属于进展系列的数据集。数据来源广泛,主要来自NCBI GEO、cBioPortal、CELLxGENE Discover、ArrayExpress、figshare等公共开放存储库。数据模态多样,涵盖bulk RNA-seq、scRNA-seq、DNA甲基化、微阵列、DNA突变、空间转录组学、质谱蛋白质组学、bulk ATAC-seq、snRNA-seq、空间蛋白质组学和scATAC-seq等。数据集以分析就绪的格式存储(如.h5ad、matrix.mtx等),并配有详细的元数据清单,记录每个数据集的来源、登录号、模态、进展阶段、大小、原始URL和出版物信息。该资源旨在为癌症研究,特别是肿瘤进展机制研究,提供一个集中的、便于访问的多组学数据平台,用户需遵循每个数据集原始来源的许可证要求。
Precancer-to-Tumor Progression Multi-omics is a meticulously curated, continuously updated collection of publicly accessible human multi-omics datasets, focusing on the complete progression trajectory from precancerous lesions to early-stage cancer and further to advanced/metastatic tumors. The dataset prioritizes the inclusion of single-cell transcriptome sequencing (scRNA-seq) and spatial transcriptomics data, while also encompassing a variety of other omics modalities. It is large-scale, comprising 3502 independent datasets with a total data volume of 672.1 GB, including 569 single-cell datasets, 160 spatial datasets, and 1119 datasets belonging to progression series. The data sources are extensive, primarily from public open repositories such as NCBI GEO, cBioPortal, CELLxGENE Discover, ArrayExpress, and figshare. The data modalities are diverse, covering bulk RNA-seq, scRNA-seq, DNA methylation, microarray, DNA mutation, spatial transcriptomics, mass spectrometry proteomics, bulk ATAC-seq, snRNA-seq, spatial proteomics, and scATAC-seq, among others. The datasets are stored in analysis-ready formats (e.g., .h5ad, matrix.mtx) and are accompanied by detailed metadata inventories that record each datasets source, accession number, modality, progression stage, size, original URL, and publication information. This resource aims to provide a centralized, easily accessible multi-omics data platform for cancer research, particularly for the study of tumor progression mechanisms. Users must comply with the license requirements of each datasets original source.
数据集概述:Precancer-to-Tumor Progression Multi-omics (single-cell & spatial)
该数据集是一个持续更新的、精选的人类多组学公开数据集集合,覆盖从癌前病变 → 早期癌 → 晚期/转移的完整肿瘤演进轨迹,优先收录单细胞和空间转录组学数据。
数据集基本信息
- 数据集名称:Precancer-to-Tumor Progression Multi-omics (single-cell & spatial)
- 许可证:非标准许可(每个子数据集保留其原始来源的许可证)
- 语言:英语
- 标签:生物学、医学、癌症、肿瘤学、单细胞、scRNA-seq、空间转录组学、肿瘤进展、癌前、多组学、基因组学
- 数据规模:>1TB
- 数据集总数:3506个
- 总大小:678.3 GB
数据组成
按数据类型
| 类型 | 数量 |
|---|---|
| 单细胞数据 | 570 |
| 空间数据 | 160 |
| 进展系列数据 | 1119 |
按数据来源
| 来源 | 数量 |
|---|---|
| GEO | 3393 |
| cBioPortal | 95 |
| CELLxGENE | 93 |
| ArrayExpress | 54 |
| figshare | 53 |
| SCEA | 4 |
| UCSC-CellBrowser | 1 |
按模态划分
- other/unspecified: 1306
- bulk-RNA-seq: 659
- scRNA-seq: 519
- methylation: 420
- microarray: 219
- DNA-mutation: 188
- spatial-transcriptomics: 143
- proteomics-MS: 102
- bulk-ATAC: 69
- snRNA-seq: 43
- spatial-proteomics: 17
- scATAC: 8
数据来源
数据集来源于以下公共仓库:NCBI GEO、CZ CELLxGENE Discover、EBI Single Cell Expression Atlas、UCSC Cell Browser、HCA、figshare、Zenodo、cBioPortal、PRIDE、ArrayExpress/BioStudies。每个数据集遵循其原始仓库/原始出版物的许可证。
仓库结构
data/<SOURCE>/<ACCESSION>/— 每个数据集的处理就绪文件(如.h5ad、matrix.mtx+barcodes/features、Visium空间矩阵、计数表)_catalog/precancer_catalog.csv/.xlsx/.parquet— 完整清单(每个数据集一行:来源、登录号、模态、进展阶段、大小、源URL、PMID/DOI、摘要)_catalog/README.md— 可读的运行摘要
使用方式
可通过 huggingface_hub 的 snapshot_download 下载指定数据文件,例如:
python from huggingface_hub import snapshot_download p = snapshot_download("wei82/precancer-omics-data", repo_type="dataset", allow_patterns=["_catalog/", "data/CELLxGENE/"])
加载 .h5ad 文件可使用 scanpy / anndata,加载 matrix.mtx 可使用 scanpy.read_10x_mtx。
重要说明
- 所有数据均来自公共开放访问仓库,不包含受控访问或可识别患者的数据
- 使用任何数据集时,必须引用原始研究并遵循其许可证
- 数据集自动化收集,不与原始数据提供者关联,仅供研究便利使用
- 在重用或重新分发前,请验证每个数据集的原始许可证