
ghananlpcommunity/ghana-speech-prepped-filtered
收藏官方服务:
资源简介:
这是一个预处理和过滤后的加纳语音数据集,包含预计算的梅尔频谱图和音素化文本,用于多语言Matcha-TTS训练。数据经过过滤,只保留时长在1.0到10.0秒之间的音频片段,并且每种语言的音频总时长上限为10小时。
Precomputed mel spectrograms + phonemized text for multilingual Matcha-TTS training, filtered to clips in [1.0, 10.0] seconds and capped at 10 hours per language.
提供机构:
ghananlpcommunity搜集汇总
数据集介绍
构建方式
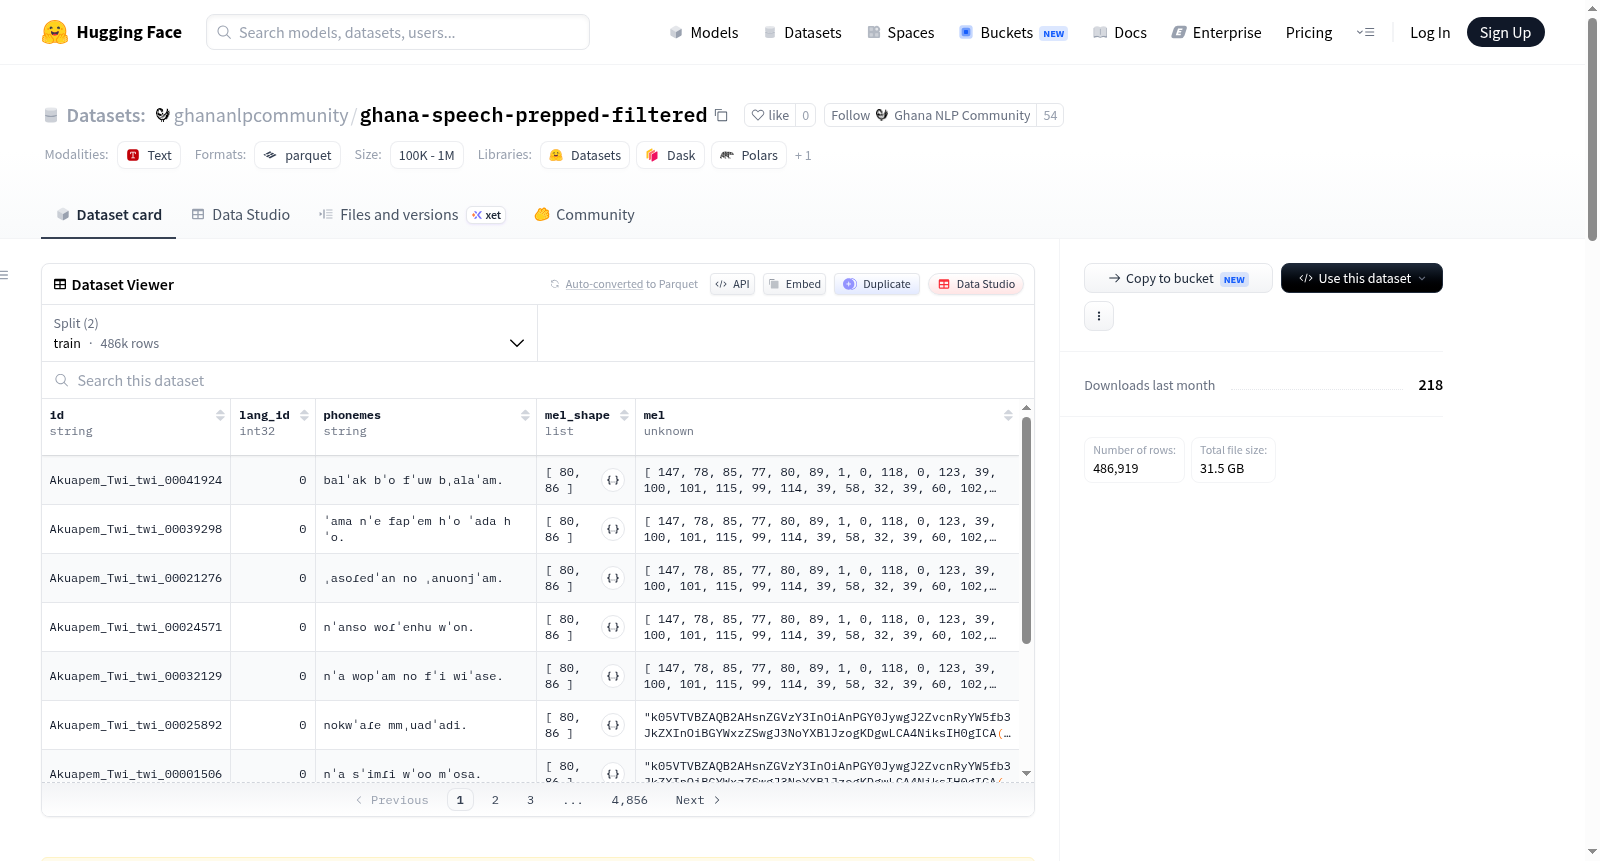
本数据集源自加纳多语种语音语料库 Ghana Speech,原始语料涵盖42种语言、约141万条语音片段。为适配 Matcha-TTS 模型的训练需求,数据集进行了针对性预处理:首先利用 espeak 的 LFN 语音合成引擎,结合 twi_cleaners 清洗规则对文本进行音素化转写;随后对语音信号计算梅尔频谱图,参数设定为 n_fft=1024、n_mels=80、采样率22050 Hz、窗口长度1024、跳跃步长256,频率范围覆盖0至8000 Hz;最后依据时长对语音片段进行筛选,仅保留长度在1.0至10.0秒之间的样本,并对每个语言子集进行10小时上限截断,最终形成包含485,575条训练样本与1,344条验证样本的精细数据集。
特点
数据集以 Parquet 分片格式存储,每条记录包含标识符、语言标签(0-41)、音素序列及梅尔频谱图二进制数据,结构紧凑且支持高效读取。梅尔频谱图采用原始未归一化形式存储,均值为-5.277、标准差为3.065,保留了完整的声学动态范围。数据覆盖多达42种非洲语言,在语音多样性上具有显著优势。经过严格时长筛选与语种容量限制后,训练集总时长约389.4小时,各语种分布均衡,避免了长尾问题,为多语种语音合成研究提供了高质量且平衡的训练资源。
使用方法
用户可通过 Hugging Face Datasets 库直接加载数据集的 Parquet 分片,亦可利用官方脚本从 Hugging Face Hub 下载元数据文件(包括统计参数与语言映射表)进行离线重构。重构流程包括:将梅尔频谱图二进制数据恢复为 NumPy 数组并保存为 .npy 文件;同时根据训练/验证分割生成文件列表,每条记录包含音频路径、语言标识与音素序列,格式兼容 Matcha-TTS 及其他类似 TTS 框架的标准输入要求。该设计使得数据集可便捷地融入现有的语音合成训练流水线。
背景与挑战
背景概述
在语音合成领域,多语言文本到语音(TTS)系统的研究长期受限于高质量、跨语言标注数据的匮乏。为应对这一挑战,加纳NLP社区于近期构建了Ghana Speech Prepped (Filtered)数据集,旨在为多语言Matcha-TTS模型提供预处理后的标准化训练资源。该数据集源于原始的Ghana Speech语料库(包含42种语言、约141万条音频片段),经过梅尔频谱预计算与音素化文本对齐处理,并依据时长[1.0, 10.0]秒进行筛选、每语言10小时的上限截断,最终形成38.94万条训练样本和1344条验证样本,覆盖389.4小时高质量音频。与原始数据集相比,该版本预先计算了80维梅尔频谱并采用LFN音素化策略,显著降低了模型训练前的数据预处理门槛。作为首个面向西非多语言TTS任务的标准化预处理数据集,它为低资源语言语音合成研究提供了可复现的基准资源,并推动了语音技术在语言多样性区域的落地应用。
当前挑战
该数据集面临的核心挑战源于其多语言背景下的数据不均衡与预处理复杂性。首先,在领域问题层面,42种语言在语音时长、音素分布及声学特征上存在显著差异,尤其是低资源语言如Buli、Dagaare等仅有少量可用片段,使得TTS模型在跨语言泛化时易出现发音退化或合成语音不自然的现象,如何在有限且不均衡的数据中维持多语言声学模型的质量成为关键难题。其次,在构建过程中,原始语料库包含大量背景噪声、非口语化片段及时长超出[1.0, 10.0]秒范围的音频,筛选操作虽剔除了噪声与异常长度样本,却进一步压缩了低资源语言的可用数据量;同时,基于espeak的LFN音素化方法对于部分语言(如Gonja、Hanga)缺乏对应音素映射,导致音素序列与声学特征对齐时存在偏离,影响到后续TTS训练中音素-频谱对应关系的准确性。这些因素共同制约着该数据集在低资源多语言语音合成中的实际效能与泛化潜力。
常用场景
经典使用场景
在低资源语言语音合成研究的广阔版图中,Ghana Speech Prepped (Filtered) 数据集以其精心预处理的梅尔频谱图与音素化文本,成为训练多语言Matcha-TTS等非自回归文本到语音模型的基石。该数据集涵盖了42种加纳语言,经过时长过滤(1至10秒)及每语种10小时的上限控制,确保了音频片段的一致性与语种间的平衡,为构建稳健、泛化能力强的跨语言语音合成系统提供了标准化输入。研究者可直接利用其预计算的80维梅尔频谱图与LFN音素序列,跳过繁琐的特征提取流程,聚焦于模型架构优化与多语言声学建模。
衍生相关工作
这一数据集的诞生直接催化了多项前沿研究工作。作为Matcha-TTS训练流程中的关键组件,它支撑了条件流匹配模型在多语言场景下的首次系统性验证。后续学者基于此衍生了跨语言音素映射研究,探索不同语言音系结构的统一表征;在音素持续时间预测、韵律建模及多说话人自适应等子任务中,该数据集也被用作基准,其上训练的模型对比高资源语言展现了独特的泛化行为,启发了一系列关于低资源场景下数据增强与预训练策略的学术探讨。
数据集最近研究
最新研究方向
在当前多语言语音合成与语音处理的前沿探索中,Ghana Speech Prepped Filtered数据集的发布标志着低资源语言语音技术的重要突破。该数据集通过将42种语言、近390小时的高质量语音数据预处理为统一的梅尔频谱图与音素化文本,并结合时长过滤与每语言上限控制策略,为多语种Matcha-TTS等非自回归文本转语音模型提供了标准化的训练基石。这一创新处理流程不仅解决了非洲本土语言在语音数据标注与格式兼容性上的长期瓶颈,更与全球人工智能社区对语言公平性的呼声相呼应——通过开源共享,为西非地区乃至整个低资源语言群体的语音交互系统、教育自动化与无障碍通信等应用场景铺平了道路,其影响深远于推动多语言技术民主化与保护文化多样性的时代浪潮之中。
以上内容由遇见数据集搜集并总结生成


