
aneeshas/imsdb-500tokensci-fi-movie-scripts
收藏官方服务:
资源简介:
--- dataset_info: features: - name: Sci-Fi dtype: string splits: - name: train num_bytes: 82670 num_examples: 180 download_size: 53226 dataset_size: 82670 --- # Dataset Card for "imsdb-500tokensci-fi-movie-scripts" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集信息: 特征字段: - 字段名:Sci-Fi(科幻),数据类型:字符串 数据划分集: - 划分名:训练集,字节数:82670,样本数:180 下载大小:53226,数据集总大小:82670 --- # "imsdb-500Token科幻电影剧本"数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
提供机构:
aneeshas原始信息汇总
数据集概述
数据集名称
imsdb-500tokensci-fi-movie-scripts
数据集特征
- 特征名称: Sci-Fi
- 数据类型: 字符串
数据集分割
- 分割名称: train
- 数据大小: 82670字节
- 示例数量: 180
数据集大小
- 下载大小: 53226字节
- 数据集总大小: 82670字节
搜集汇总
数据集介绍
背景与挑战
背景概述
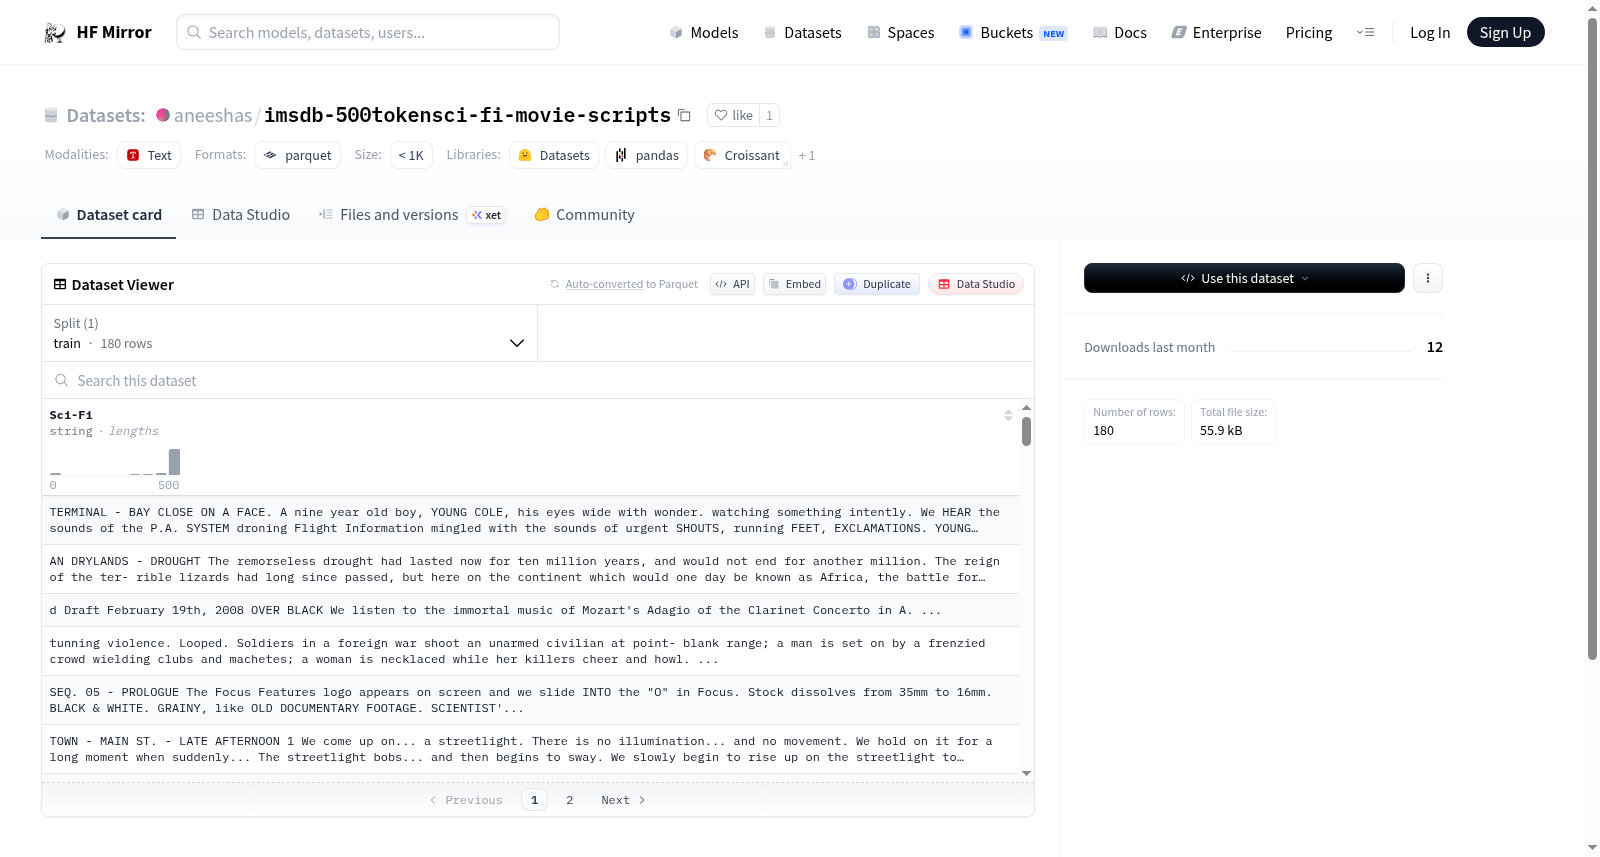
该数据集是一个包含180行科幻电影脚本片段的文本集合,每个片段字符串长度限制在500个标记以内,以parquet格式存储,总大小为55.9 kB。数据集专注于提供短文本的科幻叙事内容,适用于文本挖掘、语言模型训练或电影脚本分析等应用场景。
以上内容由遇见数据集搜集并总结生成


