
遇见数据集

Farah21/reddit-tunisia-qa

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

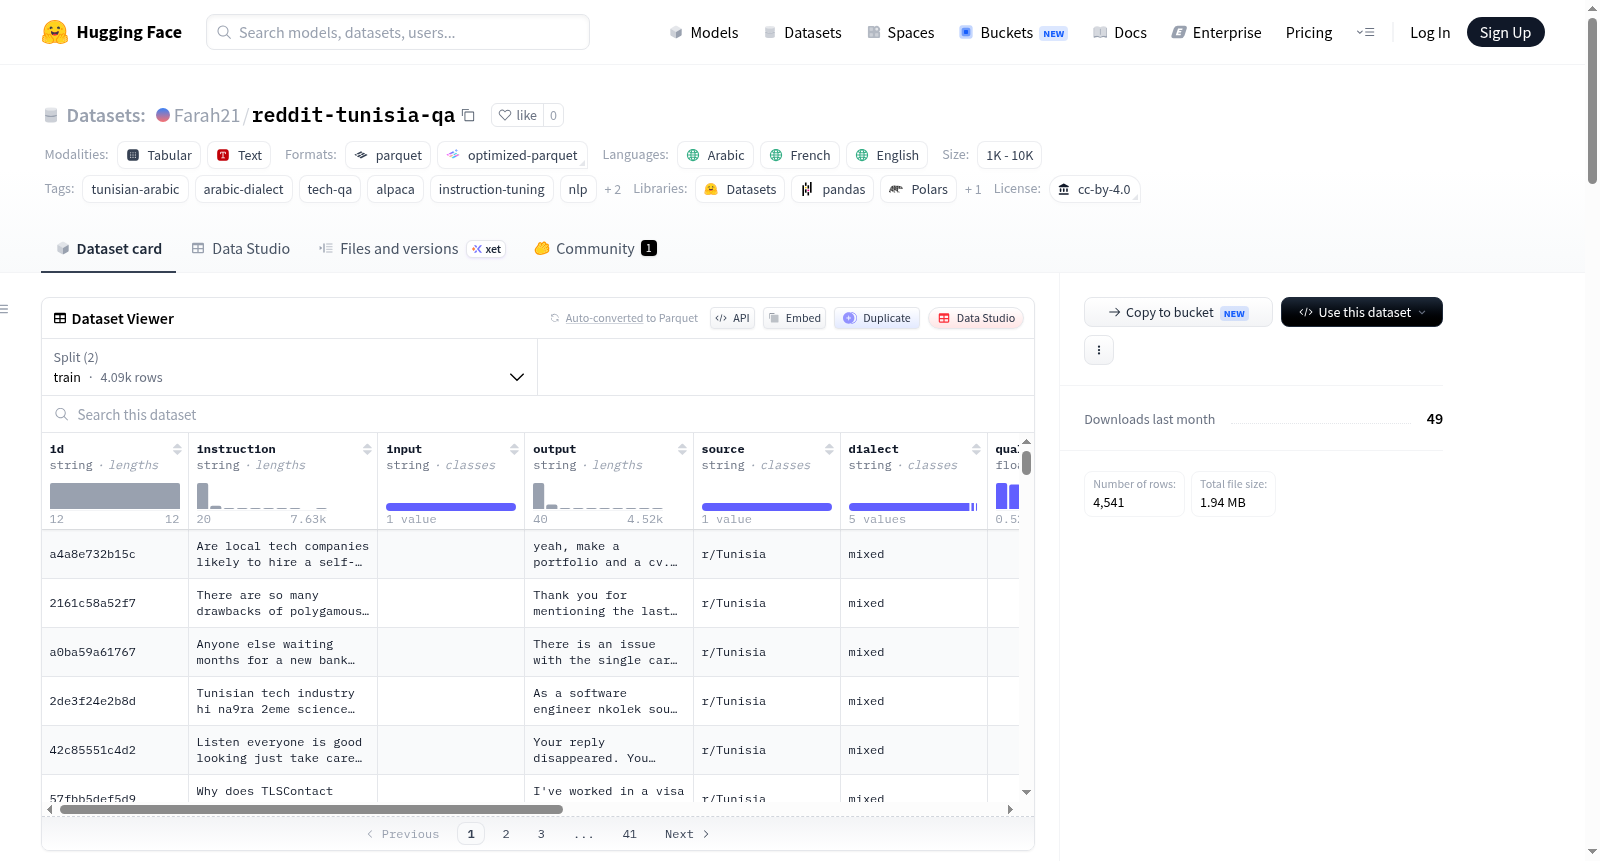
Reddit Tunisia Tech QA数据集是一个多语言指令调优数据集,基于Reddit讨论构建,重点关注突尼斯和中东及北非(MENA)地区的技术社区。该数据集包含4,541个高质量的指令跟随问答对,这些数据收集并过滤自专注于编程、机器学习、自由职业、Web开发和科技讨论的Reddit社区。作为TunisIA-Co-Lab倡议的一部分,该数据集旨在支持突尼斯阿拉伯语和多语言自然语言处理(NLP)研究。数据集经过多阶段过滤和清洗,包括语言规范化、重复去除、质量排名、技术相关性评分以及NSFW和有害内容过滤。最终数据集以Alpaca格式结构化,包含指令、输入、输出、来源、方言、质量分数等列。数据来源包括r/Tunisia、r/learnprogramming、r/cscareerquestions等多个Reddit子社区。

The Reddit Tunisia Tech QA Dataset is a multilingual instruction-tuning dataset built from Reddit discussions with strong Tunisian and MENA tech-community presence. It contains 4,541 high-quality instruction-following QA pairs collected and filtered from Reddit communities focused on programming, machine learning, freelancing, web development, and technology discussions. Built as part of the TunisIA-Co-Lab initiative to support Tunisian Arabic and multilingual NLP research, the dataset underwent multiple filtering and cleaning stages, including language normalization, duplicate removal, quality ranking, technical relevance scoring, and NSFW and toxic-content filtering. The dataset is structured in Alpaca format with columns such as instruction, input, output, source, dialect, quality_score, and more. Sources include subreddits like r/Tunisia, r/learnprogramming, r/cscareerquestions, among others.
提供机构:
Farah21
搜集汇总
数据集介绍
Farah21/reddit-tunisia-qa 数据集图片
构建方式
该数据集源自Reddit社群中与科技议题相关的讨论,聚焦于突尼斯及中东与北非地区技术社区的交流内容。构建流程起始于从多个活跃的技术子版块(如r/Tunisia、r/learnprogramming等)爬取原始问答对,初始收集约5,500对数据。随后经历多轮精细筛选与清洗,包括语言规范化、重复项剔除、质量排序、技术相关性评分,并严格过滤NSFW与有毒内容。最终保留4,541对高质量指令遵循问答项,过滤率约为17.44%。
特点
数据集以Alpaca格式组织,包含instruction、input、output等标准字段,并额外嵌入source、dialect、quality_score等元信息。其多元性体现在语言覆盖上,囊括突尼斯阿拉伯语、突尼斯阿拉伯语转写、法语、阿拉伯语及混合语种,其中混合语种占比最高。数据还附有质量评分与技术置信度,平均质量得分为0.634,技术置信度均值为0.0275,为下游任务提供细粒度的数据质量参考。
使用方法
该数据集可通过HuggingFace Datasets库便捷加载,调用load_dataset('Farah21/reddit-tunisia-qa')即可获取训练集。每条数据包含指令(instruction)、空输入(input)、回答(output)及来源等属性,适配指令微调场景。研究人员可基于quality_score与tech_confidence字段筛选高质子集,或利用dialect字段进行多语言与方言特定任务分析。数据集同样支持直接用于对话系统训练、跨语言NLP基准测试及突尼斯阿拉伯语技术问答研究。
背景与挑战
背景概述
在自然语言处理领域,指令微调数据集对提升大语言模型理解多语言与方言的能力至关重要,然而面向阿拉伯语方言尤其是突尼斯阿拉伯语的高质量数据集极为稀缺。Reddit Tunisia Tech QA数据集诞生于2026年,由TunisIA-Co-Lab研究团队基于Reddit技术社区构建,旨在填补方言指令微调数据的空白。该数据集精心筛选了4,541条高质量问答对,涵盖编程、机器学习、自由职业等技术主题,语言覆盖突尼斯阿拉伯语、阿拉伯语、法语及英语的多语混合形态。通过系统化的质量评分与技术相关性过滤,数据集不仅支持了方言与多语言NLP研究,更为中东与北非地区的技术社区提供了宝贵的语言资源,推动了区域AI研究的本土化发展。
当前挑战
当前数据集面临多维度挑战。在领域问题上,突尼斯阿拉伯语作为低资源方言,缺乏标准化标注规范与形态丰富的语料,使其在指令微调中的泛化能力受限;而技术问答场景的高专业性与术语复杂性,进一步放大了多语言混合文本的解析难度。在构建过程中,从5,500个初始问答中经NSFW过滤、重复移除及技术相关性评分后,最终保留4,541个样本(过滤率17.44%),然而滤除的959个答案中可能存在关键知识损失。此外,方言分布极度不均(混合语料占绝大多数,纯突尼斯阿拉伯语仅4例),导致模型对纯粹方言指令的响应能力不足,数据稀疏性制约了方言模型的鲁棒性提升。
常用场景
经典使用场景
作为多语言指令微调数据集,reddit-tunisia-qa主要用于训练和评估能够理解突尼斯阿拉伯语、法语、英语等多语种混合表达的大语言模型。研究者常利用该数据集构建面向北非马格里布地区技术社区的对话系统,尤其聚焦于编程、机器学习、自由职业和网页开发等领域的问答生成。其4,541条高质量指令-响应对遵循Alpaca格式,便于直接集成到主流的微调框架中。
解决学术问题
该数据集解决了低资源阿拉伯语方言在技术领域缺乏高质量指令微调数据的核心学术问题。突尼斯阿拉伯语作为一种口语化方言,其书面语料极为稀缺,而该工作通过系统化的Reddit社区挖掘与多阶段过滤(包括NSFW去除、质量评分和技术相关性筛选),构建了首个包含方言变体(tunisian_arabizi/tunisian_arabic)的技术问答资源。这推动了方言NLP研究从资源丰富语言向方言区域的延伸,并为多语种指令对齐提供了可复现的范式。
衍生相关工作
该数据集作为TunisIA-Co-Lab倡议的产出,衍生了一系列方言NLP研究工作。相关后续工作包括:将其与多方言指令数据集结合扩展到马格里布阿拉伯语(Maghrebi Arabic)统一建模;基于其质量评分机制改进技术领域数据筛选算法;以及利用其技术置信度指标训练方言技术意图检测模型。此外,该数据集的构建流程已被借鉴用于构建其他低资源方言的技术问答资源,如埃及阿拉伯语和黎凡特阿拉伯语的技术社区数据集。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

