
lrohAmca/nano-nla-qwen05b-20k-data
收藏官方服务:
资源简介:
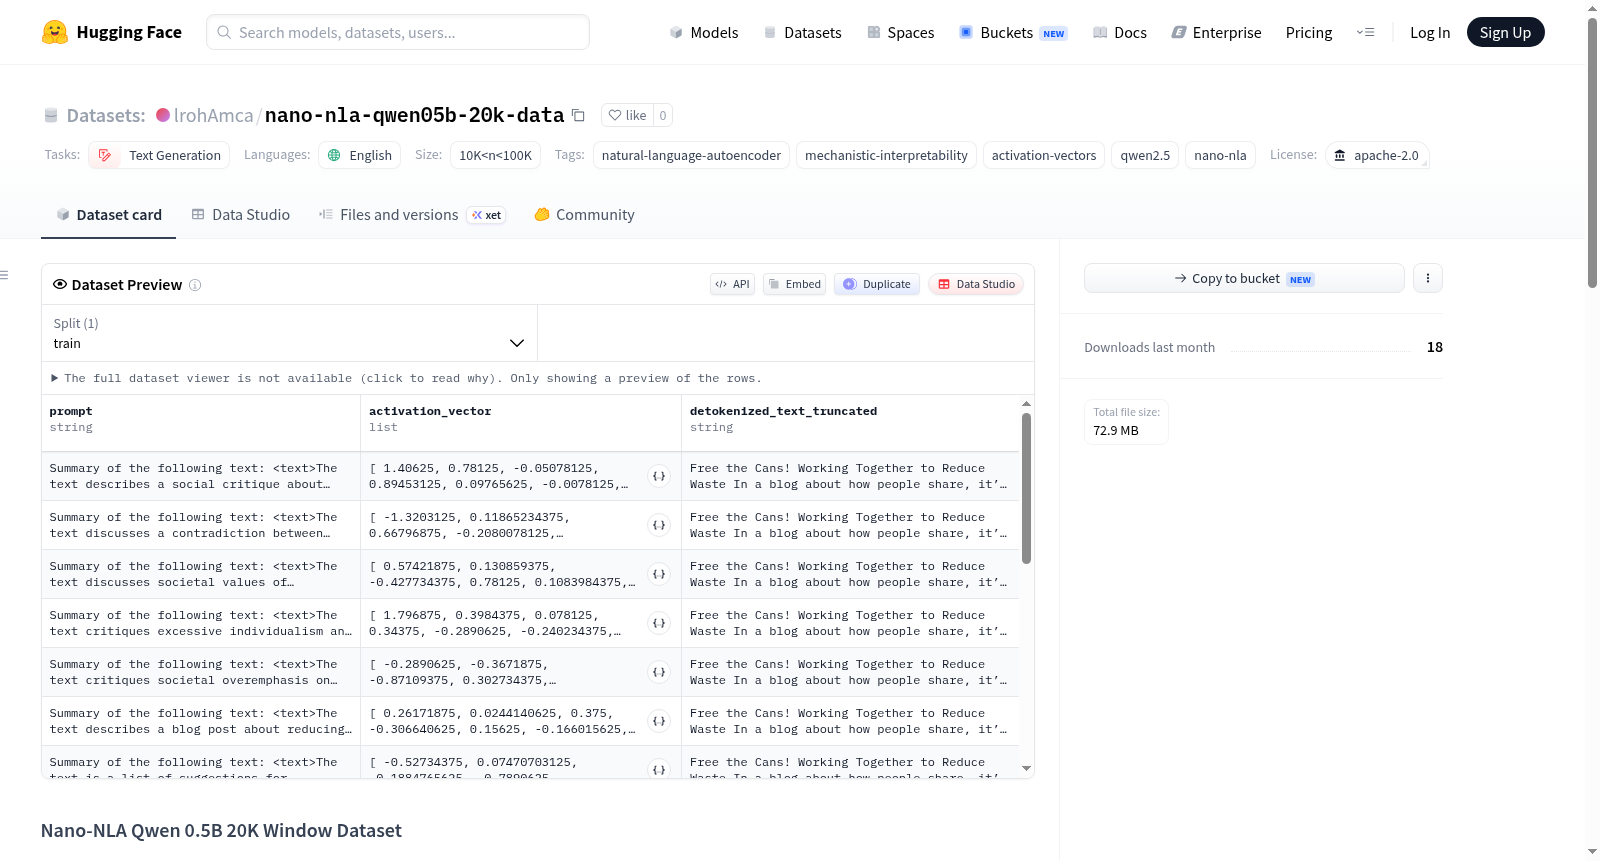
该数据集包含与Qwen/Qwen2.5-0.5B-Instruct模型前20K强化学习窗口相关的Nano-NLA训练文件。激活向量是从目标层16的残差流中提取的,源文本来自HuggingFaceFW/fineweb的sample-10BT配置的训练分割,使用了Nano-NLA提取流程。
This dataset contains the Nano-NLA training files associated with the first 20K RL window for Qwen/Qwen2.5-0.5B-Instruct. The activation vectors were extracted from the residual stream at target layer 16. Source text came from HuggingFaceFW/fineweb, config sample-10BT, split train, using the Nano-NLA extraction pipeline.
提供机构:
lrohAmca搜集汇总
数据集介绍
构建方式
该数据集源自Nano-NLA项目,旨在为Qwen2.5-0.5B-Instruct模型提供一个紧凑的自然语言自编码器训练资源。其构建过程始于从HuggingFaceFW/fineweb语料库的sample-10BT配置中提取源文本,随后通过专用提取管道从模型第16层残差流中捕获维度为896的激活向量。数据集包含三个核心Parquet文件:av_sft.parquet用于激活词汇器监督微调,ar_sft.parquet用于激活重建器监督微调,以及rl_window_000000_019999.parquet对应首个GRPO训练窗口的20,000条强化学习样本。每个文件均附有NLA元数据侧车文件,详细记录了基础模型、目标层、激活列契约、提示模板及注入参数等信息。
使用方法
使用该数据集时,用户可直接加载Parquet文件,并通过元数据侧车文件获取完整的训练上下文。具体而言,训练需遵循指定的参数配置:基础模型为Qwen/Qwen2.5-0.5B-Instruct,目标层为第16层,注入令牌ID为149705,注入比例为25.0,MSE比例为29.93。强化学习训练窗口从第0行开始,涵盖20,000条样本,并执行800步GRPO训练。数据集的列结构清晰,激活向量列为固定大小的浮点向量,截断文本列用于分析和调试,而各SFT文件还可提供额外的提示与响应列。通过合理组合这些文件,研究者能够在自编码器循环中实现从监督微调到强化学习的渐进式训练流程。
背景与挑战
背景概述
Nano-NLA Qwen 0.5B 20K Window Dataset 创建于2026年,由Transformer Circuits团队与KitFT等研究机构合作开发。该数据集聚焦于自然语言自编码器(Natural Language Autoencoders, NLA)在小型语言模型中的机械可解释性研究,核心目标是通过激活向量(activation vectors)解耦残差流中的语义信息,进而探索语言模型内部表征的编码机制。基于Qwen2.5-0.5B-Instruct模型,数据集提取第16层的残差流激活,并构建了监督微调与强化学习(GRPO)两条训练通路,为理解小型语言模型的隐藏状态语义提供了标准化训练资源。作为NLA方法在工业级基底模型上的首次轻量级应用,该数据集推动了可解释性研究从理论向工程化实践的跨越。
当前挑战
该数据集面临的核心挑战在于解耦语言模型内部高维残差流表征的语义模糊性——残差流中自然语言概念与数值激活之间的矛盾限制了直接可解释性,现有教师生成的解释标注(warm-start explanations)虽能辅助自编码器训练,但无法作为隐藏状态语义的黄金标准。构建过程中,数据采样面临模型窗口20K token长度的约束,需在截断源文本时平衡语义完整性;激活向量提取对目标层参数固定要求严格,微小的注入尺度(injection_scale)与MSE尺度(mse_scale)偏差即可能破坏重建信噪比;此外,RL窗口数据仅包含2万条样本,在小样本条件下训练自编码器需人工精细调节强化学习步长与注入token ID,避免过拟合与梯度爆炸。
常用场景
经典使用场景
在机械可解释性(Mechanistic Interpretability)的研究浪潮中,Nano-NLA Qwen 0.5B 20K Window Dataset 被广泛用于训练和评估自然语言自编码器(Natural Language Autoencoder, NLA)。该数据集聚焦于提取 Qwen2.5-0.5B-Instruct 模型在残差流第16层的激活向量,并结合教师生成的自然语言解释,为语言模型隐藏状态的语义对齐提供了高精度的训练样本。研究者借助该数据集的SFT(监督微调)与RL(强化学习)窗口数据,能够在小型模型上复现并验证自然语言自编码器的核心机制,从而更深入地理解模型内部表示与人类可读语义之间的映射关系。
解决学术问题
该数据集有效解决了语言模型隐藏状态语义可解释性不足这一关键学术难题。传统方法多依赖探针(Probe)或特征可视化间接推断神经元功能,而Nano-NLA通过构建激活向量与自然语言标签的配对训练数据,使得模型能够将高维残差流信号直接解码为文字描述。这为破解大型语言模型的“黑箱”困境提供了量化且可验证的工具。其意义在于,它不仅推动了机械可解释性从定性分析向定量验证的转变,还通过公开的RL训练窗口和旁侧元数据,降低了该领域研究的复现门槛,加速了可解释AI(XAI)理论在开源社区中的传播与迭代。
实际应用
在实际应用中,该数据集支撑的NLA技术可嵌入到模型监控与安全对齐的全流程。例如,通过对对话系统残差流的实时激活向量监测,运维人员能够快速定位模型生成有害或偏见内容时的内部状态异常。数据集提供的AV_SFT和AR_SFT文件能用于训练轻量级解释器,这些解释器可作为解释插件部署在生产环境的推理管线中,为每一次输出附带可读的“模型思考过程”。此外,RL窗口数据专门用于GRPO(群体相对策略优化)训练,这使得AI系统在强化学习阶段就能利用自然语言反馈纠正内部表征偏差,从而在不牺牲性能的前提下提升模型的安全性与可控性。
数据集最近研究
最新研究方向
该数据集聚焦于自然语言自动编码器(NLA)与机械可解释性的交叉领域,为理解大型语言模型内部表征提供了新颖视角。通过提取Qwen2.5-0.5B-Instruct模型在残差流第16层的激活向量,并结合强化学习训练窗口,数据集致力于探索如何将隐藏状态语义转化为可解释的自然语言标签。这一研究方向呼应了当前AI对齐与透明度领域的热点——即通过自动化编码器循环,以无监督方式揭示模型内部推理逻辑。Nano-NLA的轻量级特性使其成为验证可解释性方法可行性的理想基准,其采用的教师生成解释与RL优化策略,为构建更可控、更透明的语言模型奠定了基础,对推动可解释AI从理论走向实践具有显著意义。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


