
遇见数据集

BUT-FIT/orca-audio-qa-annotations

收藏
Hugging Face2026-07-03 更新2026-07-22 收录
官方服务:

资源简介:

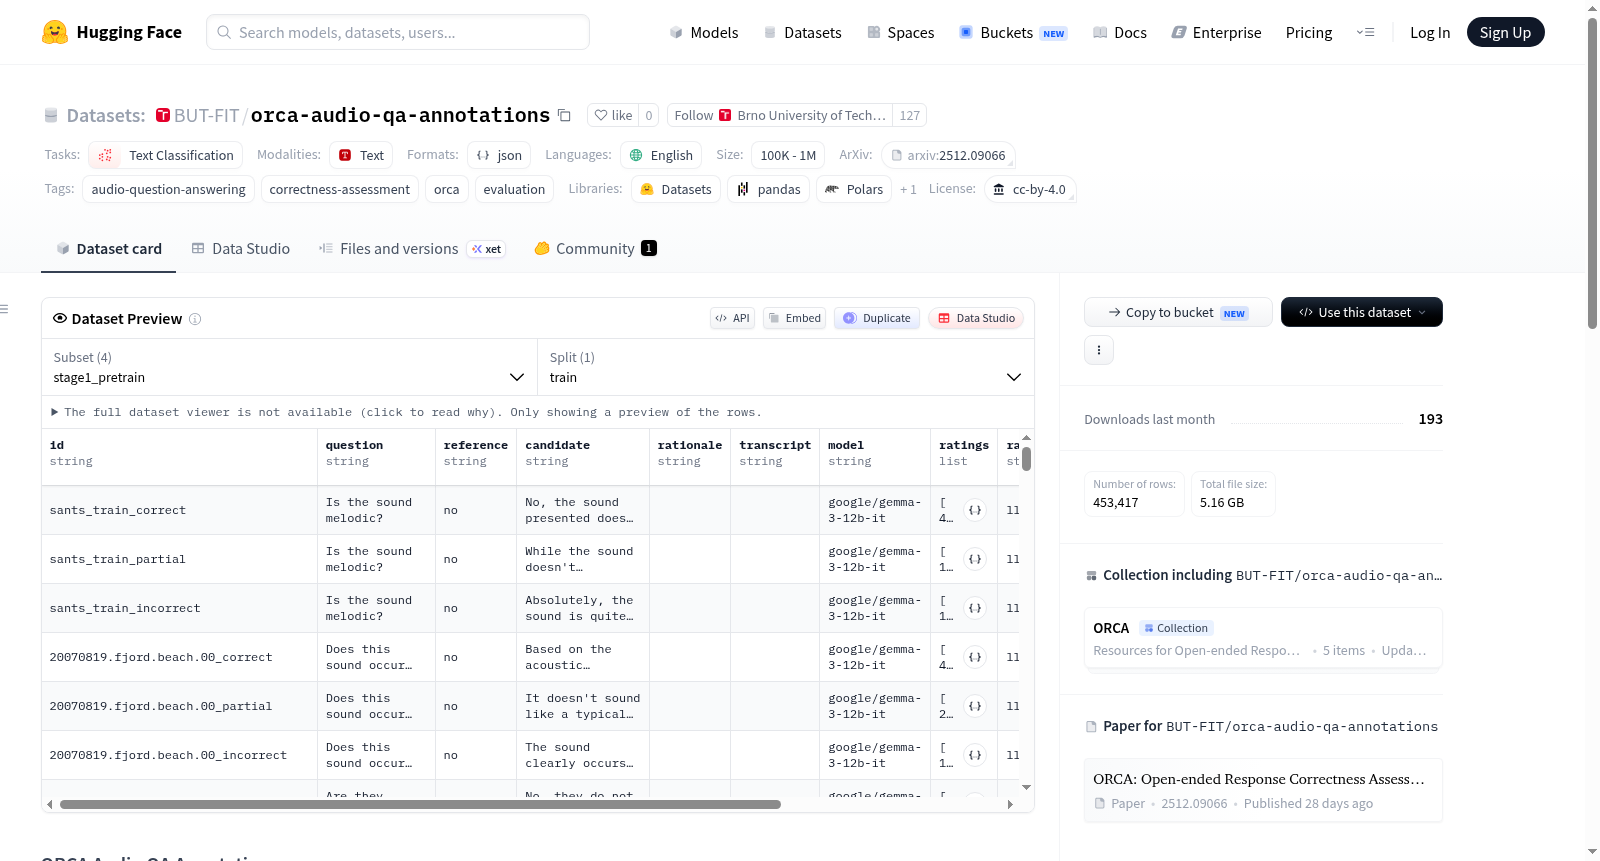
ORCA音频问答标注数据集是用于训练和评估ORCA(开放式响应正确性评估)模型的标注数据,ORCA是一个用于音频问答任务的评分模型。该数据集采用三阶段课程训练设计,包括以下配置:1. stage1_pretrain:包含5,332,242个项目,来源于5个LLM法官的合成问答评分;2. stage2_benchmark:包含449,730个项目,来源于5个LLM法官的评估基准评分;3. stage3_mmau_mmar:包含2,447个项目,来源于人类标注者的评估评分;4. stage3_mmau_pro:包含1,240个项目,来源于人类标注者的专业评估评分。数据集总大小在100万到1000万之间,支持文本分类任务,并专注于音频问答、正确性评估、ORCA和评估等标签。

Annotation data for training and evaluating ORCA (Open-ended Response Correctness Assessment), a scoring model for audio question-answering tasks. The dataset is structured with a three-stage curriculum: stage1_pretrain includes 5,332,242 items from 5 LLM judges; stage2_benchmark includes 449,730 items from 5 LLM judges; stage3_mmau_mmar includes 2,447 items from human annotators; stage3_mmau_pro includes 1,240 items from human annotators. It has a size category of 1M<n<10M, supports text-classification tasks, and focuses on tags such as audio-question-answering, correctness-assessment, orca, and evaluation.
提供机构:
BUT-FIT
搜集汇总
数据集介绍
BUT-FIT/orca-audio-qa-annotations 数据集图片
构建方式
ORCA Audio QA Annotations数据集专为训练与评估音频问答场景下的开放式响应正确性评估模型而构建。其构建遵循三阶段课程学习范式:第一阶段利用五个大型语言模型作为裁判,对合成问答对进行评分,生成超过530万条预训练数据;第二阶段同样借助五名语言模型评审,对来自MMAU和MMAR基准测试的问答对进行评级,产出约45万条基准数据;第三阶段引入人工标注,对MMAU与MMAR子集及MMAU-Pro子集中的问答对进行精细评判,分别获得2447条和1240条高质量标注。这种由合成到真实、由机器到人类的渐进式构建策略,确保了模型从粗粒度泛化到细粒度精准评估的能力。
特点
该数据集的核心特点在于其多源异构的评分体系与阶梯式难度设计。数据涵盖机器裁判与人工裁判两种标注来源,使得模型能够同时学习自动化评估的一致性以及人类判断的微妙偏好。每个样本包含音频问答对及其对应的正确性评分,支持多分类或回归任务。此外,数据集按阶段划分为四个配置,分别对应预训练、基准测试和人工验证等不同用途,既可用于模型的全流程训练,也可作为细粒度评估基准。其规模横跨数千至数百万条,兼顾了统计多样性与标注精度的平衡。
使用方法
使用该数据集时,研究者可通过HuggingFace Datasets库按配置名称加载对应子集,例如使用'stage1_pretrain'获取合成评分数据,或选用'stage3_mmau_mmar'获取人工标注数据。每条数据以JSONL格式存储,包含问答内容与评分标签,可直接用于训练分类器或回归模型。建议搭配ORCA官方发布的预训练模型(如orca-olmo-2-1b-multinomial)进行微调或零样本评估。训练过程中可依据阶段顺序逐步增加数据难度,或混合使用不同配置以提升评估模型的鲁棒性。详细代码实现与使用示例可在配套GitHub仓库中获取。
背景与挑战
背景概述
在音频问答领域,自动评估模型生成答案的正确性是一项具有挑战性的任务,尤其在开放式场景中,传统指标难以全面捕捉语义质量的细微差异。ORCA Audio QA Annotations数据集由捷克布尔诺理工大学(BUT)语音处理团队主导创建,发表于2025年,旨在训练和评估一种名为ORCA的开放式响应正确性评估模型。该数据集以三阶段课程式设计为核心,融合了来自5个大型语言模型(LLM)的合成标注以及人类评估者的细致判断,共计超过570万条标注条目,覆盖从预训练到基准测试的完整流程。其核心研究问题在于填补音频问答中响应质量自动评估的空白,通过引入多维度评分机制(如正确性、充分性、事实性),为模型提供更可靠的评估基准。作为音频理解领域的重要进展,ORCA数据集及其配套模型被TACL 2026录用,有望推动音频问答系统评估标准的演进。
当前挑战
该数据集所解决的领域问题聚焦于音频问答中开放式响应正确性评估的自动化和标准化。传统上,音频问答系统的评估多依赖于精确匹配或人工评判,缺乏对语义开放性、上下文相关性及事实一致性的系统度量。ORCA需要通过监督学习捕捉人类评分中隐含的细微偏好,这要求标注既覆盖多样化场景又能保证一致性。构建过程中面临的核心挑战在于数据规模的平衡:大规模合成标注(超过530万条)易于获取但潜藏噪声,而人类标注(仅约3700条)质量高却成本高昂。如何将这两类数据进行有效融合,并设计三阶段课程(预训练→LLM评判→人类评判)以逐步提升模型鲁棒性,成为技术实现中的关键难点。此外,多语言扩展(如MMAU和MMAR基准)和细粒度评分标准的定义,进一步增加了标注的复杂性和模型泛化难度。
常用场景
经典使用场景
ORCA Audio QA Annotations数据集专为训练和评估音频问答任务中的开放域回答正确性评估模型而设计。其核心使用场景在于作为ORCA评分模型的训练与基准测试数据,该模型能够对音频问答系统中生成的多样文本回答进行细粒度的正确性评分。数据集采用三阶段课程学习策略构建,第一阶段包含超过530万条由大型语言模型标注的合成问答对,用于预训练模型的基础评估能力;第二阶段引入近45万条基于MMAU和MMAR基准的LLM标注数据,用于模型在标准评测集上的微调;第三阶段则由人类标注员提供数千条高质量的人工审核评分,用于最终校准与评估。这种分层结构使得ORCA模型能够在不同质量层级上学习如何从‘完全错误’到‘完全正确’的连续区间内对音频问答回答进行准确打分,从而为音频理解系统的性能评估提供可靠工具。
衍生相关工作
ORCA Audio QA Annotations数据集及其配套模型直接衍生了多项具有影响力的学术工作与开源资源。论文《ORCA: Open-ended Response Correctness Assessment for Audio Question Answering》被TACL 2026接收,确立了音频开放域回答正确性评估的新范式。基于该数据集训练的三款预训练评分模型——orca-olmo-2-1b-multinomial、orca-gemma-3-4b-it-multinomial与orca-llama-3.2-3b-it-multinomial已在HuggingFace平台上开源,允许研究者直接进行微调或零样本迁移至特定音频问答任务。该数据集的三阶段课程设计思路启发了后续工作在语音评估、多媒体问答等领域的评估指标构建。此外,该数据集中的合成数据生成与人类标注协同策略,为人机协作的数据构建流程提供了可复现的模板,推动了音频自然语言处理领域开放评估标准的建立与发展。
数据集最近研究
最新研究方向
在音频问答领域,ORCA数据集聚焦于开放式答案正确性评估这一前沿方向,依托三阶段课程学习框架,融合合成数据与人类标注,构建了从大规模LLM评分到精细化人工评判的评估体系。该研究呼应了多模态理解中响应质量自动判定的热点需求,尤其针对音频问答的开放性和主观性挑战提供了标准化工具。其提出的ORCA模型及配套的百万级标注资源,为提升智能助手、语音交互系统的可靠性与可控性提供了关键支撑,对推动音频理解评估范式的科学化具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

