Factory Email Extraction
收藏资源简介:
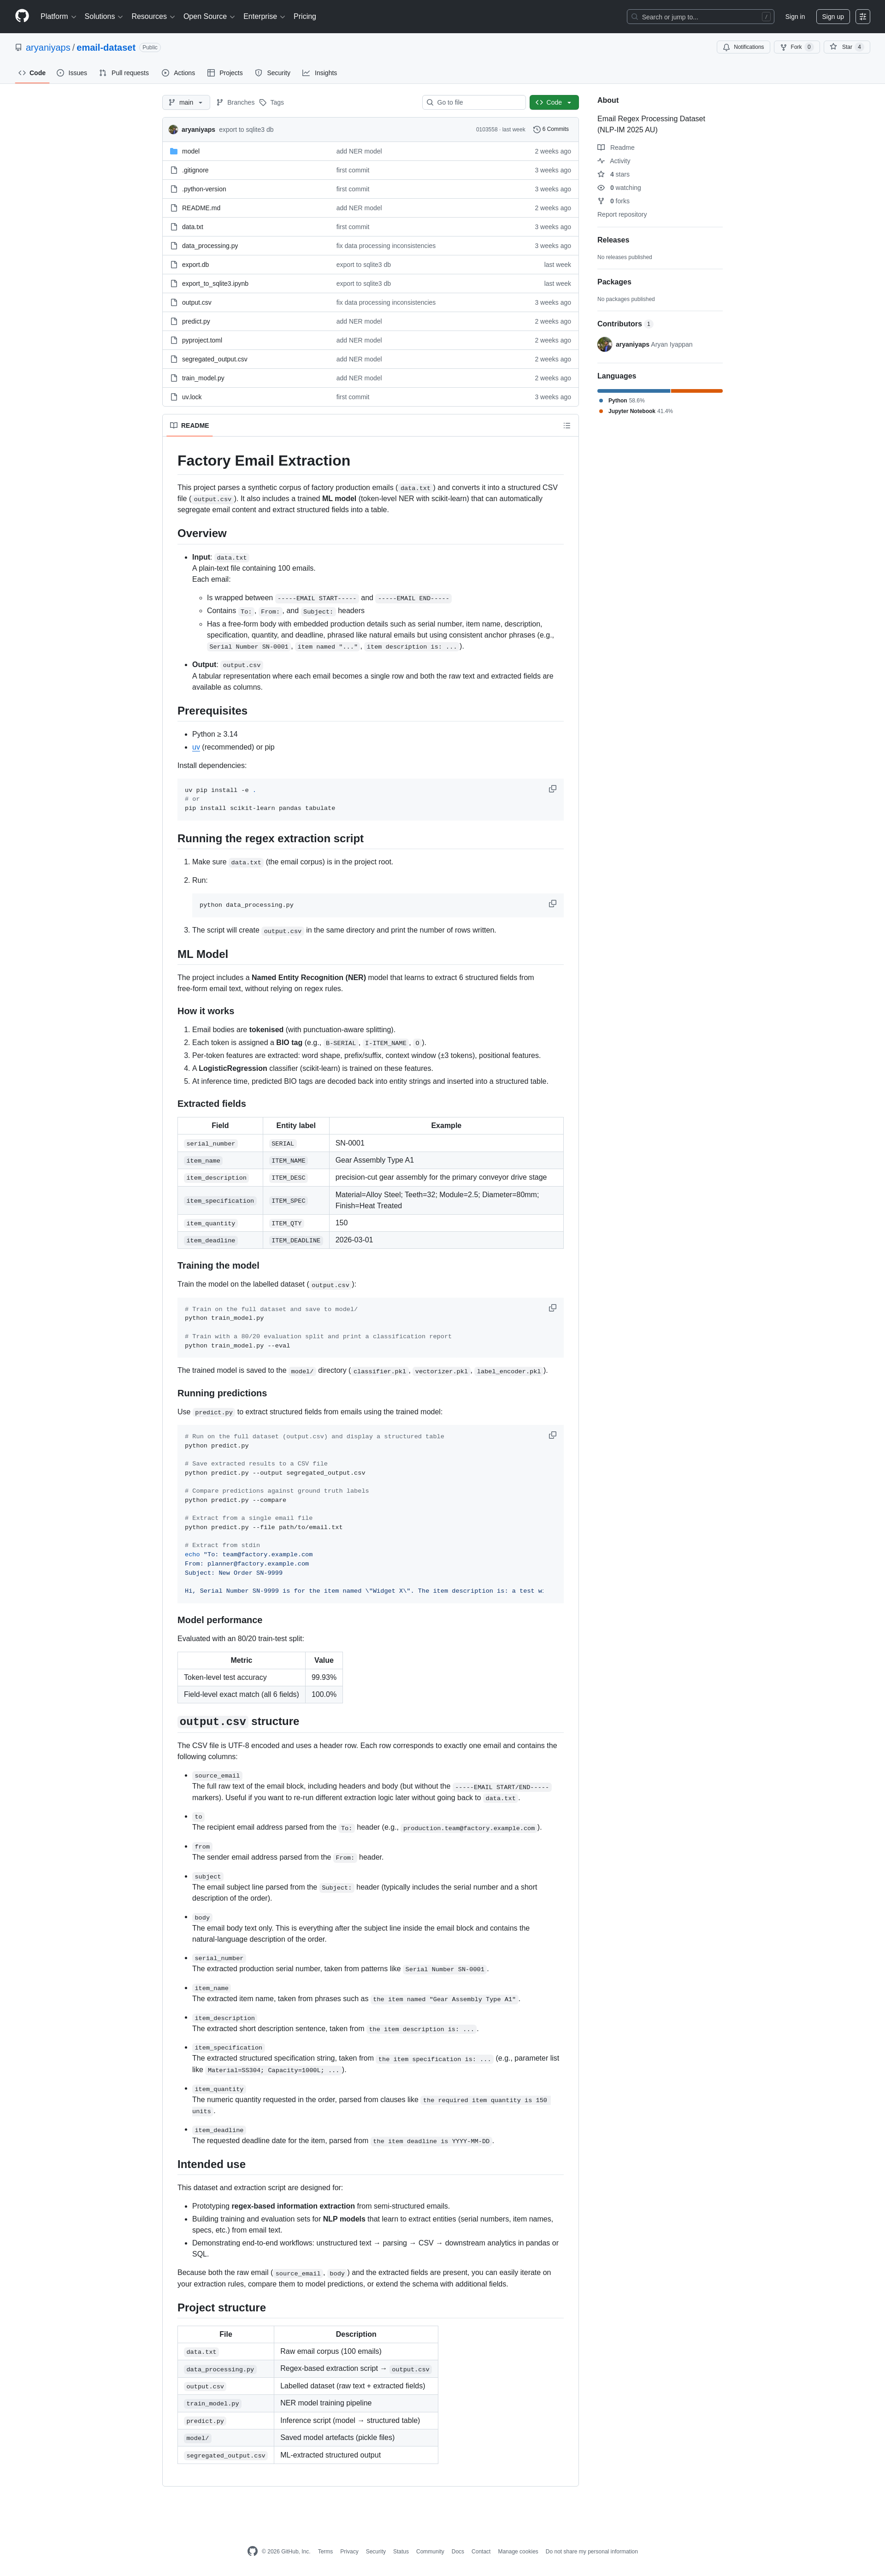
该项目解析了一个合成的工厂生产电子邮件语料库(`data.txt`)并将其转换为结构化的CSV文件(`output.csv`)。输入文件`data.txt`包含100封电子邮件,每封电子邮件都包裹在`-----EMAIL START-----`和`-----EMAIL END-----`之间,包含`To:`、`From:`和`Subject:`标题,以及一个自由形式的正文,其中嵌入了生产细节,如序列号、物品名称、描述、规格、数量和截止日期。输出文件`output.csv`是一个表格表示,其中每封电子邮件成为一行,原始文本和提取的字段都作为列可用。
This project parses a synthetic factory production email corpus (`data.txt`) and converts it into a structured CSV file (`output.csv`). The input file `data.txt` contains 100 emails, each enclosed within `-----EMAIL START-----` and `-----EMAIL END-----`, with headers including `To:`, `From:`, and `Subject:`, as well as free-form body text embedding production details such as serial numbers, item names, descriptions, specifications, quantities, and deadlines. The output file `output.csv` is a tabular representation where each email corresponds to one row, with both the original text and extracted fields available as columns.
数据集概述
数据集基本信息
- 数据集名称:Factory Email Extraction
- 数据集地址:https://github.com/aryaniyaps/email-dataset
- 核心内容:一个包含100封合成工厂生产邮件的语料库,以及用于从邮件中提取结构化信息的处理脚本和机器学习模型。
数据内容与格式
-
原始数据文件:
data.txt- 格式:纯文本文件。
- 内容:包含100封电子邮件。
- 每封邮件格式:
- 以
-----EMAIL START-----和-----EMAIL END-----包裹。 - 包含
To:、From:和Subject:邮件头。 - 邮件正文为自由格式,包含嵌入式生产细节,如序列号、物品名称、描述、规格、数量和截止日期。这些信息使用一致的锚定短语表述(例如
Serial Number SN-0001、item named "..."、item description is: ...)。
- 以
-
结构化输出文件:
output.csv- 格式:CSV文件,UTF-8编码,包含标题行。
- 内容:每封邮件对应一行数据,包含原始文本和提取出的字段。
数据结构 (output.csv 列说明)
source_email:完整的原始邮件文本(不包括-----EMAIL START/END-----标记)。to:从To:邮件头解析出的收件人邮箱地址。from:从From:邮件头解析出的发件人邮箱地址。subject:从Subject:邮件头解析出的邮件主题。body:仅邮件正文文本。serial_number:提取的生产序列号(例如SN-0001)。item_name:提取的物品名称。item_description:提取的物品简短描述。item_specification:提取的结构化规格字符串(例如Material=Alloy Steel; Teeth=32; ...)。item_quantity:提取的请求数量。item_deadline:提取的请求截止日期(格式YYYY-MM-DD)。
数据处理与模型
- 正则提取脚本:
data_processing.py可将data.txt解析并转换为output.csv。 - 机器学习模型:一个基于 scikit-learn 的命名实体识别模型,用于从邮件正文中自动提取6个结构化字段。
- 提取字段与标签:
serial_number(SERIAL)item_name(ITEM_NAME)item_description(ITEM_DESC)item_specification(ITEM_SPEC)item_quantity(ITEM_QTY)item_deadline(ITEM_DEADLINE)
- 模型性能(80/20训练-测试集划分评估):
- 令牌级测试准确率:99.93%
- 字段级完全匹配率(全部6个字段):100.0%
- 提取字段与标签:
预期用途
- 为从半结构化电子邮件中进行基于正则表达式的信息提取提供原型设计。
- 为学习从邮件文本中提取实体(序列号、物品名称、规格等)的NLP模型构建训练和评估集。
- 演示端到端工作流程:非结构化文本 → 解析 → CSV → 在 pandas 或 SQL 中进行下游分析。