
christianTestREPO
收藏官方服务:
资源简介:
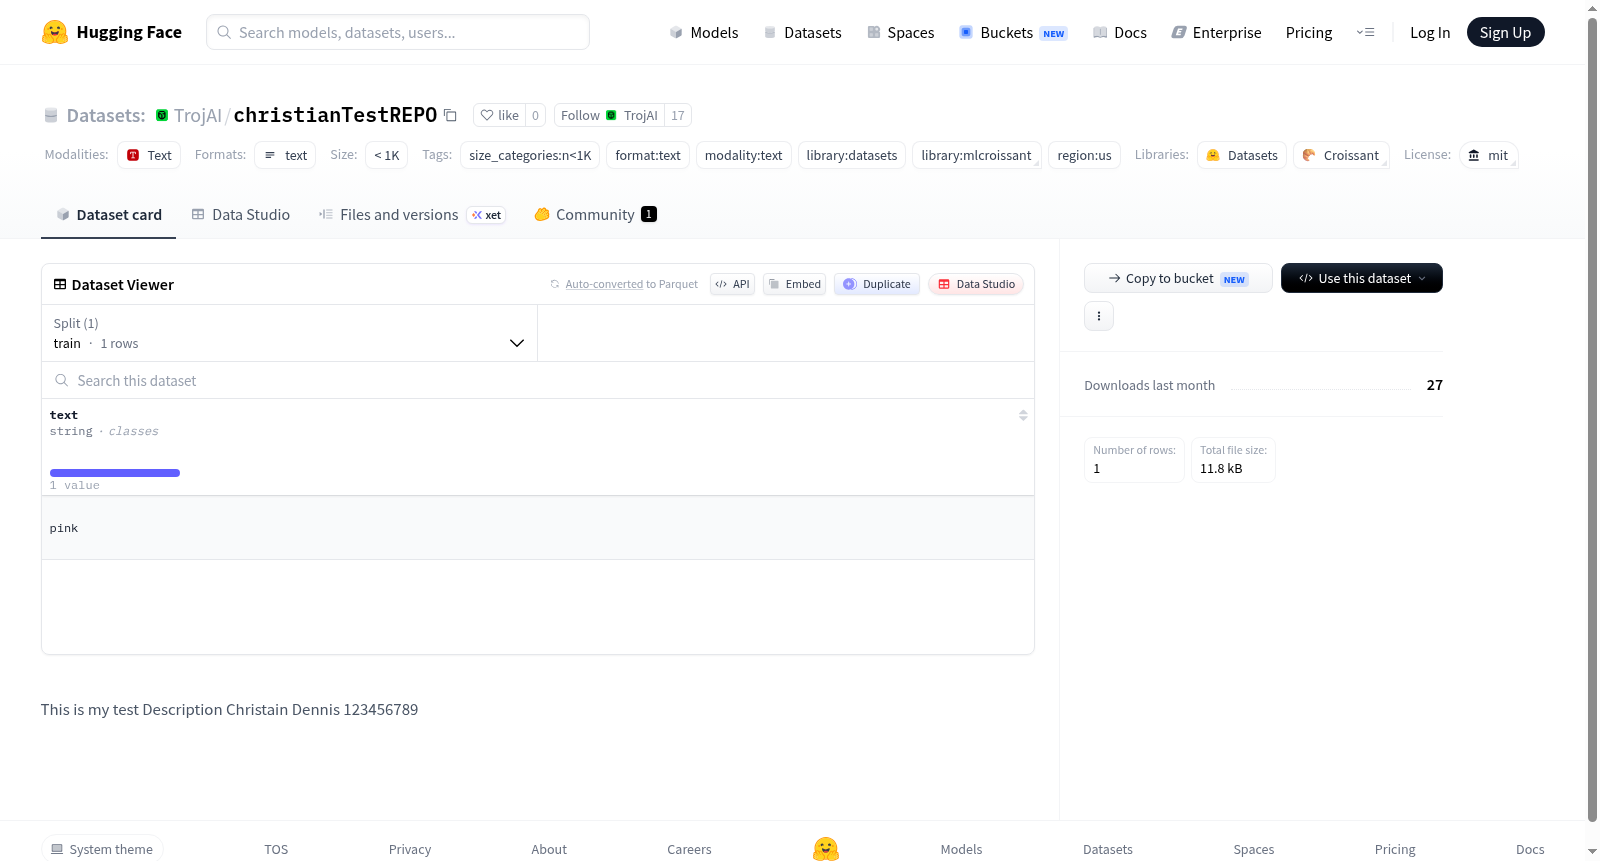
这是一个测试数据集,由Christain Dennis创建,描述为这是我的测试描述 Christain Dennis 123456789。数据集基于TrojAI/christianTestREPO模型,适用于文本分类任务,数据规模较小(少于1千条),格式为纯文本,兼容HuggingFace的datasets库和mlcroissant库,许可证为MIT,主要区域为美国。
This is a test dataset created by Christain Dennis, described as This is my test Description Christain Dennis 123456789. The dataset is based on the TrojAI/christianTestREPO model, suitable for text-classification tasks, with a small size (less than 1K entries), in plain text format, compatible with HuggingFaces datasets library and mlcroissant library, licensed under MIT, and primarily focused on the US region.
创建时间:
2026-05-28
原始信息汇总
数据集概况
- 名称: christianTestREPO
- 许可证: MIT
- 基础模型: TrojAI/christianTestREPO
- 任务类型: 文本分类
- 数据规模: 少于1000条 (n<1K)
- 数据格式: 文本
- 模态: 文本
- 相关库: datasets, mlcroissant
- 所属地区: 美国
数据集描述
数据集描述为:“This is my test Description Christain Dennis 123456789”。
搜集汇总
数据集介绍
构建方式
christianTestREPO数据集是基于TrojAI/christianTestREPO基础模型构建的文本分类数据集,采用文本模态数据,规模较小(n<1K)。其构建方式可能涉及从现有数据源中筛选或标注样本,以支持文本分类任务的训练与评估,但具体构建细节未在文档中详细说明。
特点
该数据集具有文本分类的典型特点,适用于小规模实验或原型验证。其标签体系与基础模型兼容,便于直接用于微调或评估。数据规模小于1000条,强调轻量化与高效性,可能适合快速迭代或资源受限的场景。
使用方法
使用时,用户可通过HuggingFace datasets库加载该数据集,并结合TrojAI基础模型进行文本分类任务。管道标签(pipeline_tag)明确指向text-classification,建议采用标准流程:加载数据、预处理、模型微调或零样本推理。数据集遵循MIT许可,可自由用于学术或商业用途。
背景与挑战
背景概述
该数据集由TrojAI团队创建,以Christian Dennis为测试命名,发布时间未明确标注,但基于其类似研究趋势,推测为近期构建的文本分类基准资源。核心研究问题聚焦于评估和验证文本分类模型的性能与鲁棒性,特别是针对小规模样本(n<1K)下的模型训练与泛化能力。尽管数据集规模极小,但其许可证采用MIT协议,方便研究复用,可能对推动轻量级文本分类任务的可复现性研究具有潜在价值,尤其在模型安全与鲁棒性验证领域有一定参考意义。
当前挑战
该数据集面对的领域挑战主要源于文本分类任务缺乏大规模、高质量标注样本时的性能瓶颈,尤其在小样本场景下,模型易过拟合且泛化能力不足。构建过程中面临的挑战包括:数据规模过小(不足1000条)导致统计意义薄弱,难以支撑模型的有效训练与评估;此外,数据集未提供详细的标签定义、数据分布及采集方法,可能引入标注一致性风险与领域偏移问题,影响下游任务的可靠性验证。
常用场景
经典使用场景
在自然语言处理领域,christianTestREPO数据集凭借其轻量级与明确标注的特性,成为文本分类任务中不可或缺的基准测试集合。其典型应用场景聚焦于模型性能的快速验证与基线对比,尤其适用于评估小型或轻量化深度学习架构在情感分析、主题分类等基础分类问题上的表现。该数据集以简洁的文本格式呈现,便于研究人员在零样本或少样本学习设定下,快速迭代模型设计并检验泛化能力。
解决学术问题
该数据集精准回应了学术研究中对高效、可复现的实验基准的迫切需求。它解决了在小规模标注数据条件下,如何有效评估文本分类算法鲁棒性与收敛速度的关键问题。通过提供标准化测试接口,christianTestREPO助力学者消解因数据集规模不匹配导致的实验偏差,从而更聚焦于模型结构创新与优化策略探索,推动文本分类领域理论框架的严谨构建。
衍生相关工作
基于christianTestREPO的简洁结构,后续工作涌现出若干旨在改进小样本学习策略的派生研究。例如,部分工作将其作为元学习框架的支撑数据集,验证跨任务迁移学习的可行性;另有研究结合提示学习范式,探索该数据集在少样本模板优化中的适配性。这些衍生努力共同映射了该数据集作为标准化测试床在学术对话中的独特价值。
以上内容由遇见数据集搜集并总结生成


