
sudip-adaption/adaption-multilingual-vqa-test
收藏官方服务:
资源简介:
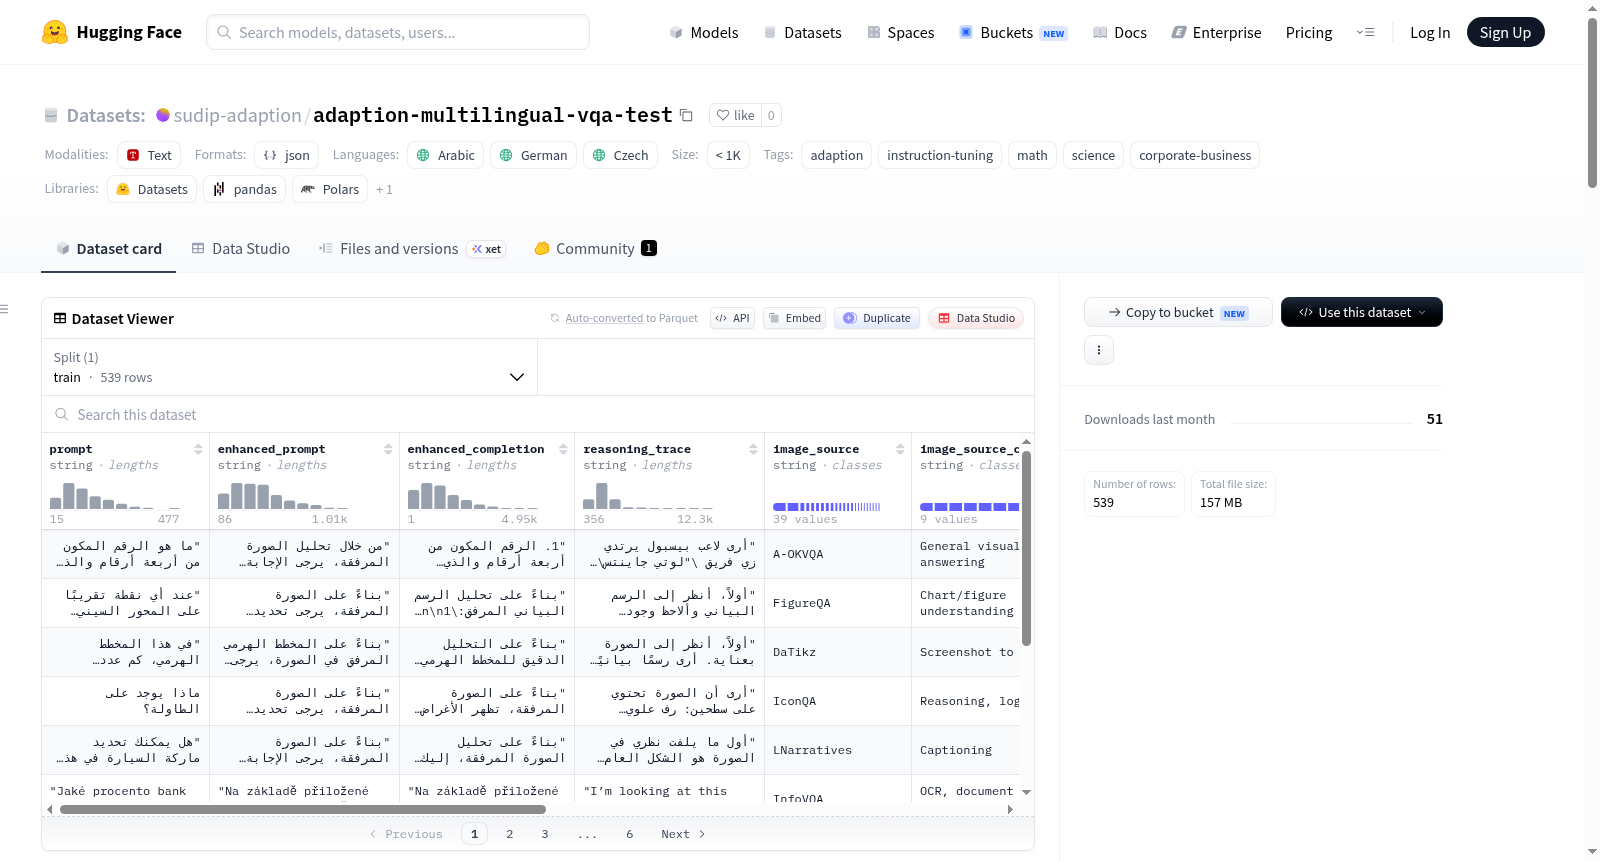
该数据集包含一个多语言视觉问答(VQA)对的集合,旨在评估模型在阿拉伯语、捷克语、德语和希腊语等多种语言中的性能。每个样本由一张图像、一个基于视觉内容要求分析、计数或推理的特定语言提示以及相应的参考答案组成。数据被组织成测试分割,并包含追踪图像来源和语言代码的元数据,侧重于复杂的视觉推理任务,而非简单的物体识别。
This dataset contains a multilingual collection of visual question answering (VQA) pairs designed for evaluating model performance across diverse languages including Arabic, Czech, German, and Greek. Each sample consists of an image, a language-specific prompt asking for analysis, counting, or reasoning based on visual content, and a corresponding reference answer. The data is structured into test splits with metadata tracking image sources and language codes, focusing on complex visual reasoning tasks rather than simple object recognition.
提供机构:
sudip-adaption搜集汇总
数据集介绍
构建方式
该数据集源于CohereLabs的AyaVisionBench,经Adaption自适应数据平台重新精制而成。构建过程中,平台对原始多语言视觉问答对进行了系统性优化与质量提升,最终涵盖539条高质量指令微调样本。数据被组织为测试集分割,每条样本包含图像、对应语言提示(涉及分析、计数或视觉推理任务)及参考答案,并附有图像来源和语言代码等元数据。
特点
数据集聚焦复杂视觉推理而非简单物体识别,覆盖阿拉伯语、德语、捷克语等多种语言,且语言分布较为均衡。领域维度横跨数学(20%)、科学(14%)及企业商业(10%),语气以分析性(46%)为主,兼具信息性和描述性。质量评估显示版本相较原始数据提升107.5%,最终评级为B,体现了出色的精制效果。
使用方法
该数据集可直接用于多语言视觉问答模型的评估与指令微调。使用时需加载测试集分割,以图像和语言特定提示作为输入,将模型输出与参考答案进行对比,评估其跨语言视觉推理能力。通过利用元数据中的语言代码和图像来源,研究者可针对特定语言或领域进行深入分析,监测模型在多语言环境下的表现差异。
背景与挑战
背景概述
多模态视觉问答(VQA)是人工智能领域融合视觉理解与自然语言推理的关键任务,其核心挑战在于模型需同时解析图像内容与非英语语言的语义表达。在此背景下,由Adaption平台基于CohereLabs的AyaVisionBench数据集重新精炼的adaption-multilingual-vqa-test数据集于近期发布,旨在评估模型在阿拉伯语、捷克语、德语等多样化语言环境下的复杂视觉推理能力,涵盖数学、科学及商业领域的高阶问题。该数据集包含539个精心标注的样本,通过自适应数据平台实现了107.5%的相对质量提升,为多语言VQA的评估基准提供了重要补充,尤其推动了非英语场景下视觉语言模型的泛化研究。
当前挑战
该数据集所解决的核心领域问题在于多语言环境下的视觉语义鸿沟与推理偏见,即现有VQA模型常因语言资源不均而在低资源语言(如捷克语)中表现退化,需应对跨语言视觉常识的迁移与计数、逻辑推论等复杂任务的鲁棒性。在构建过程中,挑战体现为三方面:首先,原始数据需经高精度重标注以消除语言歧义和标注噪声,确保多语种答案的一致性;其次,在仅有539个测试样本的有限规模内,需平衡数学(20%)、科学(14%)与企业商业(10%)领域分布,避免过拟合特定范式;最后,需通过自适应筛选算法提升质量等级至B级,同时保持46%分析性语调样本的语义精确性,这对去偏见和跨语言对齐提出了严苛要求。
常用场景
经典使用场景
在多模态与多语言人工智能领域,视觉问答(VQA)任务始终是评估模型跨模态理解能力的重要试金石。adaption-multilingual-vqa-test数据集专为测试和优化多语言视觉推理模型而设计,其经典使用场景涵盖数学运算、科学推理与商业分析三大核心领域。研究者可借助该数据集对模型进行跨语言(如阿拉伯语、捷克语、德语等)的复杂视觉问答评估,任务形式包括图像分析、计数推理与逻辑判断,而非简单的物体识别。通过测试集划分与元数据追踪,该数据集为多语言视觉语言模型(VLM)的指令微调与零样本泛化能力提供了精准的评测基准。
实际应用
在实际应用中,该数据集可赋能多语言智能客服与跨国教育系统的开发。例如,在阿拉伯语与德语混合的商业环境中,模型可依据用户上传的图像(如合同图表或产品照片)进行跨语言自动问答,辅助财务分析与库存管理。在科学教育领域,系统能够针对捷克语或希腊语学生提交的实验图像(如化学装置或物理现象)提供分步推理与答案验证,实现个性化辅导。此外,制造业质检场景中,模型可结合多语言指令对产品图像进行计数与缺陷识别,显著提升跨国生产线的协作效率。
衍生相关工作
该数据集衍生出的经典工作主要聚焦于多语言视觉指令微调与自适应学习策略。基于其来源数据集AyaVisionBench,已有研究者提出跨语言对齐框架,通过对比学习增强视觉特征与多语言文本的语义一致性。同时,针对数据集中20%的数学与14%的科学样本,衍生出面向数值推理的改进型视觉Transformer,其注意力机制可捕获图像中的空间逻辑关系。此外,利用Adaption平台的数据自适应技术,后续工作探索了动态平衡多语言样本权重的训练方法,有效缓解了语料分布不均带来的模型偏见,推动了多模态领域低资源语言性能的显著提升。
以上内容由遇见数据集搜集并总结生成


