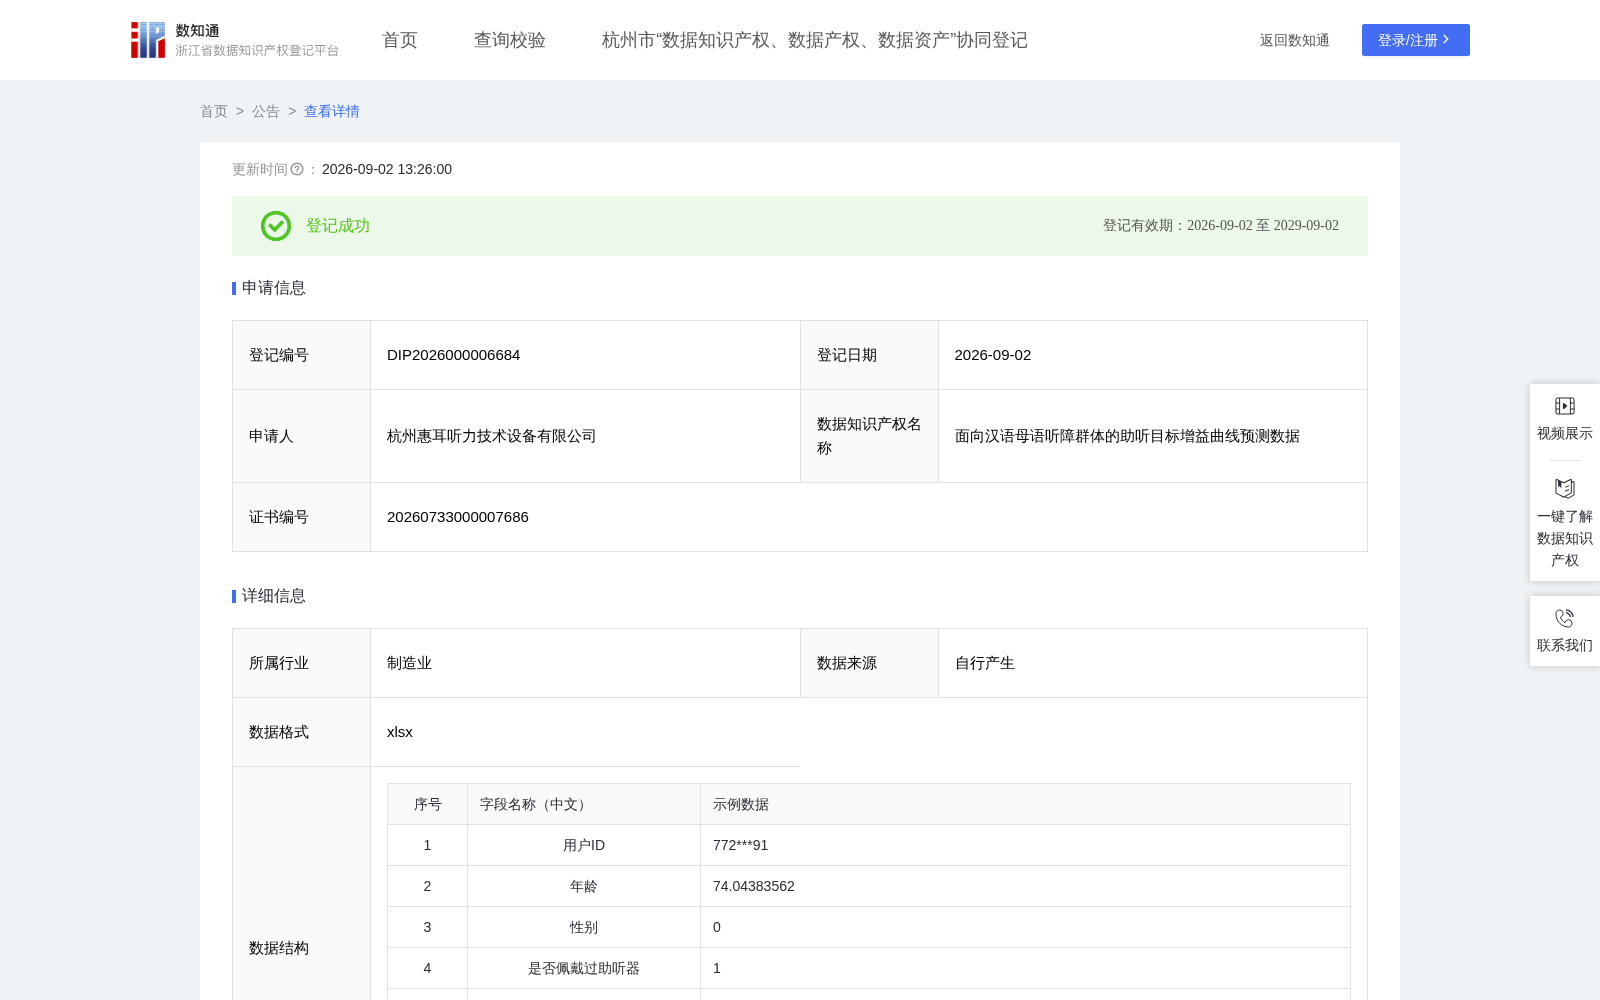
面向汉语母语听障群体的助听目标增益曲线预测数据
收藏资源简介:
本数据集通过收集大量以汉语为母语的中国听障群体在一定时间周期内的最终稳定调试数据和听损基本数据,结合AI算法计算预测出对于不同听力特征的听障者在中国特有的声学场景下能达到最优聆听清晰度及舒适度的多条频响曲线数据集(针对不同输入声强度)。该数据集可用于实现基于PPO强化学习算法的助听器自动调参算法,该算法可通过助听器参数的不断自主调整,使得助听器参数对应的实际频响曲线与目标频响曲线基本一致,从而完成人工智能验配操作。一、加工前的数据说明 采集了大量以汉语为母语的中国听障群体在一定时间周期内的听力损失基本数据(如年龄(自动换算得出,年龄=(当前日期-用户出生日期)/365)、性别(“1”代表“男”,“0”代表“女”)、是否佩戴过助听器(“1”代表“是”,“0”代表“否”)、历史佩戴时长(月)、是否双耳聋、听力图等)和最终稳定调试数据(如助听器型号等),其中,听力图数据是十个频点的气导-骨导听力阈值、不舒适阈值,单位为db。 二、处理规则 (一)模型设计 频响曲线预测模型由特征嵌入层、特征提取层、特征交互层、卷积神经网络(CNN)与池化层以及MLP输出层等模块构成。模型输入的特征有用户的年龄、性别、是否佩戴过助听器、历史佩戴时长、是否双耳聋、听力图(十个频点的气导-骨导听力阈值、不舒适阈值)、助听器型号等,上述特征通过特征嵌入层转换成256维的特征向量,然后使用双向长短期记忆神经网络(BiLSTM)提取听力图特征,将特征向量输入到特征提取层与特征交互层,紧接着通过卷积神经网络(CNN)与最大池化降维,最后通过MLP输出所预测的多条频响曲线(单位dB SPL)。 (二)模型训练 模型训练过程中采用均方误差(MSE)作为损失函数,优化算法选择Adam,并使用学习率动态调整算法(余弦退火算法),共进行30000轮训练(最初5轮为预热)。训练集、验证集和测试集比例为7:2:1,当验证集损失函数连续10轮没有下降时,即停止训练(防止过拟合)。使用Nvidia 4090算力进行训练,每次训练大约30小时。对模型进行超参数调整,尝试不同的特征向量维度大小、学习率和批次大小等参数,找到最佳的模型性能。 三、数据内容描述 最终形成的数据集合包含以下内容:用户的年龄(自动换算得出,年龄=(当前日期-用户出生日期)/365)、性别(“1”代表“男”,“0”代表“女”)、是否佩戴过助听器(“1”代表“是”,“0”代表“否”)、历史佩戴时长(月)、是否双耳聋、助听器型号、听力图(十个频点的气导-骨导听力阈值、不舒适阈值,dB)、预测频响曲线(dB SPL)、损失函数、优化算法、学习率、训练轮数、批次大小、超参数调整策略等。 本数据集可用于实现基于PPO强化学习算法的助听器自动调参算法,进而实现人工智能验配操作。