
遇见数据集

surrey-nlp/IndicQE-APE

收藏
Hugging Face2026-06-10 更新2026-06-14 收录
官方服务:

资源简介:

IndicQE-APE是一个统一的、多任务的质量评估(QE)和自动后编辑(APE)基准数据集,专注于印度语系和其他低资源语言对。该数据集整合了Surrey-NLP QE/APE数据谱系——包括WMT QE直接评估数据、特定领域的印度语QE数据以及人工后编辑数据——形成一个单一的、可配置的资源。每个实例为一行数据,携带每个来源提供的注释(如直接评估分数、后编辑、领域标签),并具有明确的来源信息、确定性内容哈希标识符和每个实例的难度诊断。与随机训练/测试分割不同,该数据集的测试集是首先精心策划的,作为一个困难的诊断工件:它过度代表了操作上困难的实例(如质量有争议、流畅但错误的翻译、错误密集的片段),因此报告的相关性反映了在QE/APE实际重要场景下的性能。数据集包含8种语言对(5种英语到印度语对和3种其他语言到英语对),总实例数为116,332,其中101,552个带有直接评估标签,42,588个带有后编辑。数据集提供多种配置,如qe-da(用于句子级QE)、ape(用于APE)、challenge(诊断测试集)等。数据字段包括源句、机器翻译、后编辑、直接评估分数等。数据集旨在用于评估句子级QE和APE模型,并通过难度分层的挑战集研究鲁棒性。

IndicQE-APE is a consolidated, multi-task Quality Estimation (QE) and Automatic Post-Editing (APE) benchmark for Indic and other low-resource language pairs, with a test-first, difficulty-stratified challenge split. It unifies the Surrey-NLP QE/APE data lineage — including WMT QE Direct-Assessment data, domain-specific Indic QE, and human post-edits — into a single, configurable resource. Each instance is one row carrying whatever annotation each source provides (such as DA scores, post-edits, domain labels), with explicit provenance, a deterministic content-hash identifier, and per-instance difficulty diagnostics. Unlike a random train/test split, the test set is curated first as a hard, diagnostic artifact: it over-represents the operationally difficult instances (e.g., contested quality, fluent-but-wrong translations, error-dense segments) so reported correlations reflect performance where QE/APE actually matters. The dataset includes 8 language pairs (5 English-to-Indic curated pairs and 3 other language-to-English passthrough pairs), with a total of 116,332 instances, of which 101,552 are QE-labelled with Direct Assessment and 42,588 have post-edits. It offers multiple configurations, such as qe-da (for sentence-level QE), ape (for APE), and challenge (the diagnostic test set). Data fields include source sentence, machine translation, post-edit, DA scores, etc. The dataset is intended for benchmarking sentence-level QE and APE models and studying robustness via the difficulty-stratified challenge set.
提供机构:
surrey-nlp
搜集汇总
数据集介绍
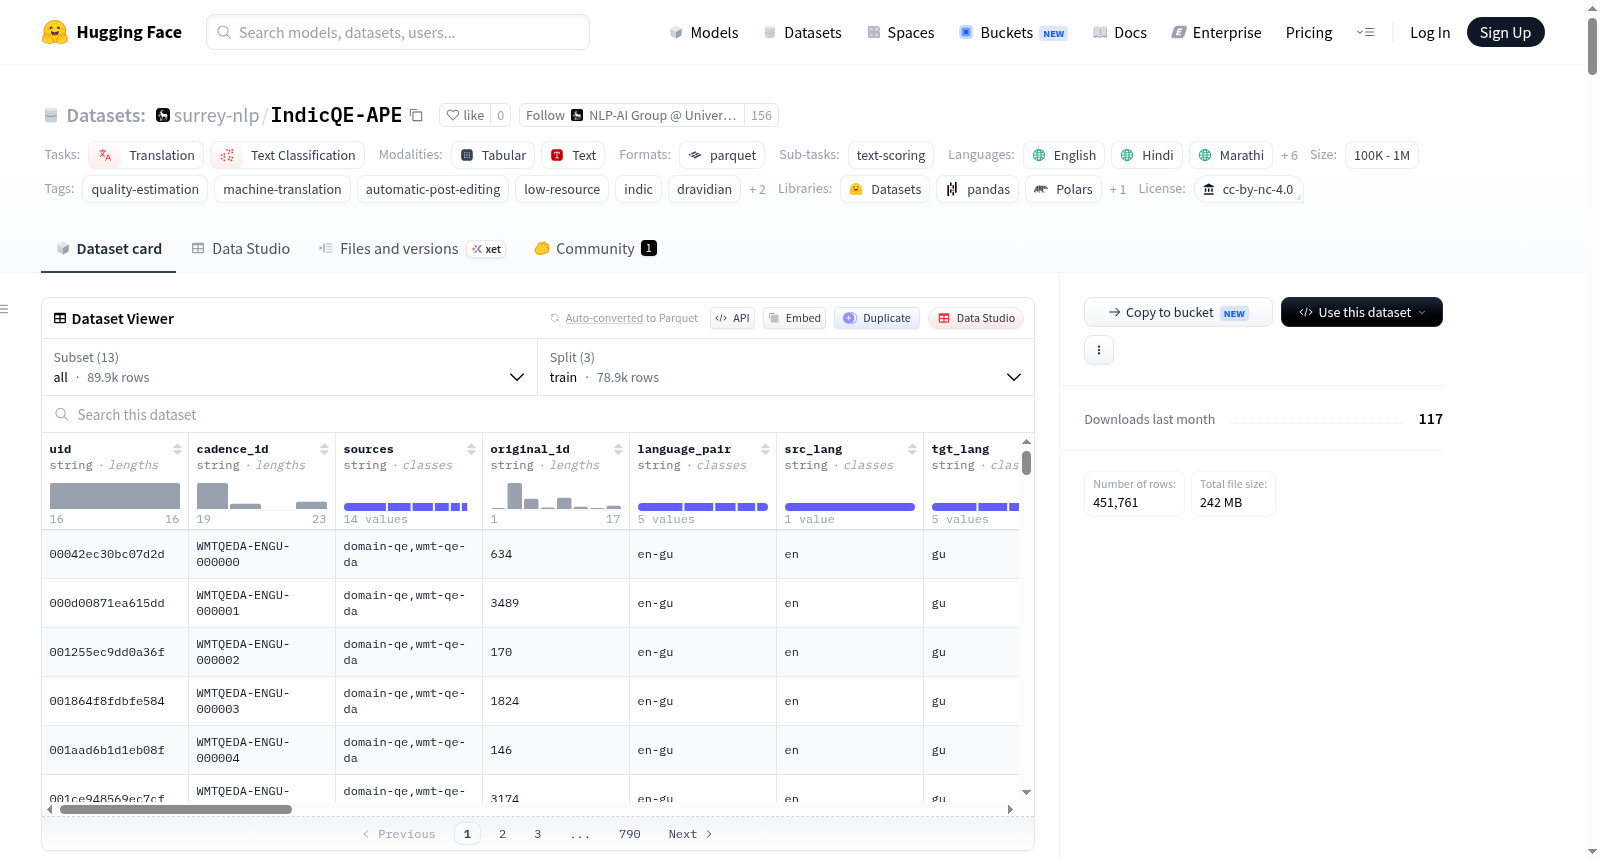
surrey-nlp/IndicQE-APE 数据集图片
构建方式
IndicQE-APE数据集整合了Surrey-NLP研究团队在质量估计与自动后编辑领域的多个数据源,包括WMT QE直接评估数据、特定领域的印地语系质量估计数据以及人工后编辑结果。该数据集采用独特的“测试优先”构建策略,首先从所有可用实例中甄选出操作上最具挑战性、信息量最丰富的样本,形成诊断性测试集,随后再划分训练集与验证集。每个实例均依据源句与机器翻译内容的确定性哈希值生成唯一标识符,并配备多源注释信息,包括直接评估分数、后编辑文本、领域标签及难度诊断指标。数据集包含八个语言对,涵盖英语至五种印地语系语言的定向翻译方向及三种其他语言至英语的翻译方向,总计超过十一万六千条公开实例。
使用方法
该数据集支持两种核心任务:句子级质量估计与自动后编辑。对于质量估计任务,研究者可直接加载qe-da配置,利用源句与机器翻译内容预测质量分数,并与da_mean字段进行相关性分析,推荐采用GEMBA提示模板进行零样本评估。对于自动后编辑任务,可加载ape配置,输入源句与机器翻译内容,输出修正后的翻译,并与post_edit字段计算sacreBLEU、chrF++及TER等自动评价指标。数据集提供了多种配置选项,包括按语言对或任务类型加载子集,并支持通过HuggingFace datasets库便捷访问。研究者可通过挑战测试集报告易例至难例的相关性下降幅度作为核心评估指标,以检验模型在关键场景下的真实性能表现。
背景与挑战
背景概述
IndicQE-APE数据集由英国萨里大学自然语言处理实验室(Surrey-NLP)于近期创建,旨在为南亚语系(Indic)及其他低资源语言对构建一个统一、多任务的质量估计(QE)与自动译后编辑(APE)基准。该数据集整合了WMT QE直接评估数据、领域特定Indic QE数据及人工译后编辑结果,覆盖英语至印地语、马拉地语、泰米尔语、泰卢固语、古吉拉特语等五种Indic语言方向,并包含爱沙尼亚语-英语、尼泊尔语-英语和僧伽罗语-英语三种X→英语方向,总计超过11.6万个实例。其核心研究问题聚焦于低资源场景下机器翻译质量评估的可靠性与挑战性,通过首创的难度分层测试集设计,系统性地暴露现有评估指标在真实困难场景中的性能衰减。该数据集已成为低资源神经机器翻译评估领域的重要基准,为研究社区提供了诊断模型翻译质量瓶颈的关键工具。
当前挑战
IndicQE-APE所解决的领域问题核心在于:现有质量评估指标在简单翻译样本上表现优异,但在存在语义歧义、编辑成本高、错误密度大或跨任务矛盾的困难实例上容易失效,亟需构建能真实反映模型在‘关键挑战点’上表现的诊断性基准。数据集构建过程中面临多重挑战:首先,需整合来自不同来源、不同标注规范的零散数据(包括WMT QE、领域特定QE及人工译后编辑),并确保统一实例标识与标注一致性;其次,需设计非随机且具诊断意义的测试集划分策略,通过难度分层方法优先选取操作上困难的实例,而非依赖传统随机抽样;此外,还需处理低资源语言对在人工标注、领域覆盖及跨语言注释质量上的天然局限性,确保数据集的代表性与可靠性。
常用场景
经典使用场景
在机器翻译质量评估与自动译后编辑研究中,IndicQE-APE数据集作为一座横跨印度语系及其他低资源语言对的综合性基准,凝聚了Surrey-NLP团队多年积累的质量评估与自动译后编辑数据精华。其经典使用场景聚焦于句子级质量评估任务与自动译后编辑任务,研究者可利用该数据集丰富的直接评估分数和人工译后编辑标注,训练并验证模型在低资源语言对上的翻译质量预测与译后编辑能力。此外,其独特设计的困难诊断测试集,通过优先选取最具挑战性的样本,为评估模型在真实复杂场景下的鲁棒性提供了严苛的检验平台,从而推动相关领域的技术边界不断拓展。
解决学术问题
该数据集精准回应了低资源语言对机器翻译质量评估与自动译后编辑领域长期存在的两大核心学术难题:其一是缺乏统一、多任务的标准化评估基准,导致不同研究结果难以横向比较;其二是传统随机划分的测试集难以反映模型在歧义频现、错误密集等复杂情境下的真实表现。IndicQE-APE通过构建涵盖多种印度语言及爱沙尼亚语、尼泊尔语、僧伽罗语等低资源语种的丰富数据,并首创难度分层、优先选取最困难样本的测试集设计,使得研究者能够系统测量模型在从简单到极具挑战性的样本上的性能衰减,从而揭示质量评估指标与译后编辑系统在关键场景下的真实短板,为改进算法提供了坚实的实验基础和方向指引。
实际应用
在实际应用层面,IndicQE-APE数据集为多语言机器翻译系统的部署与持续优化提供了至关重要的支撑。企业或机构可利用该数据集训练的质量评估模型,在不依赖人工参考译文的情况下,快速筛选出低质量的机器翻译输出,进而触发自动译后编辑流程,显著提升翻译后处理效率。例如在面向印度多语种市场的医疗、法律、旅游等领域的翻译服务中,该数据集训练出的评估工具能够精准识别歧义性高或错误密集的译文,指导系统在关键环节进行人工干预或自动修正,从而保障最终翻译质量的稳定可靠。此外,开发者还可借助其难度分层的挑战测试集,在系统上线前验证模型在极端情况下的表现,避免因翻译错误导致的沟通误解甚至安全风险。
数据集最近研究
最新研究方向
在当前低资源机器翻译质量评估(QE)与自动译后编辑(APE)研究领域,IndicQE-APE数据集的诞生标志着对印度语系及相似低资源语言对的系统性评估迈入新阶段。前沿研究焦点正从粗粒度、随机划分的传统基准测试,转向细粒度、难度分层的诊断性评测。该数据集精心构建的挑战测试集,通过交叉任务矛盾(如高DA评分与高译后编辑成本并存)和标注者分歧等维度,精准暴露模型在“高质量翻译错觉”或“错误密集但表面流畅”等操作关键场景下的性能短板。此举呼应了当前对LLM作为QE评分器的鲁棒性与校准性日益增长的关注,尤其GEMBA类提示词在此困难子集上的表现,正成为衡量模型真实语义理解能力的试金石。这一资源不仅推动了印度多语言NLP的前沿探索,更为全球化语境下如何科学评估低资源机器翻译系统树立了新的方法学标杆。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

