
遇见数据集

ucsbai/enact_tom_300_public

收藏
Hugging Face2026-07-17 更新2026-07-22 收录
官方服务:

资源简介:

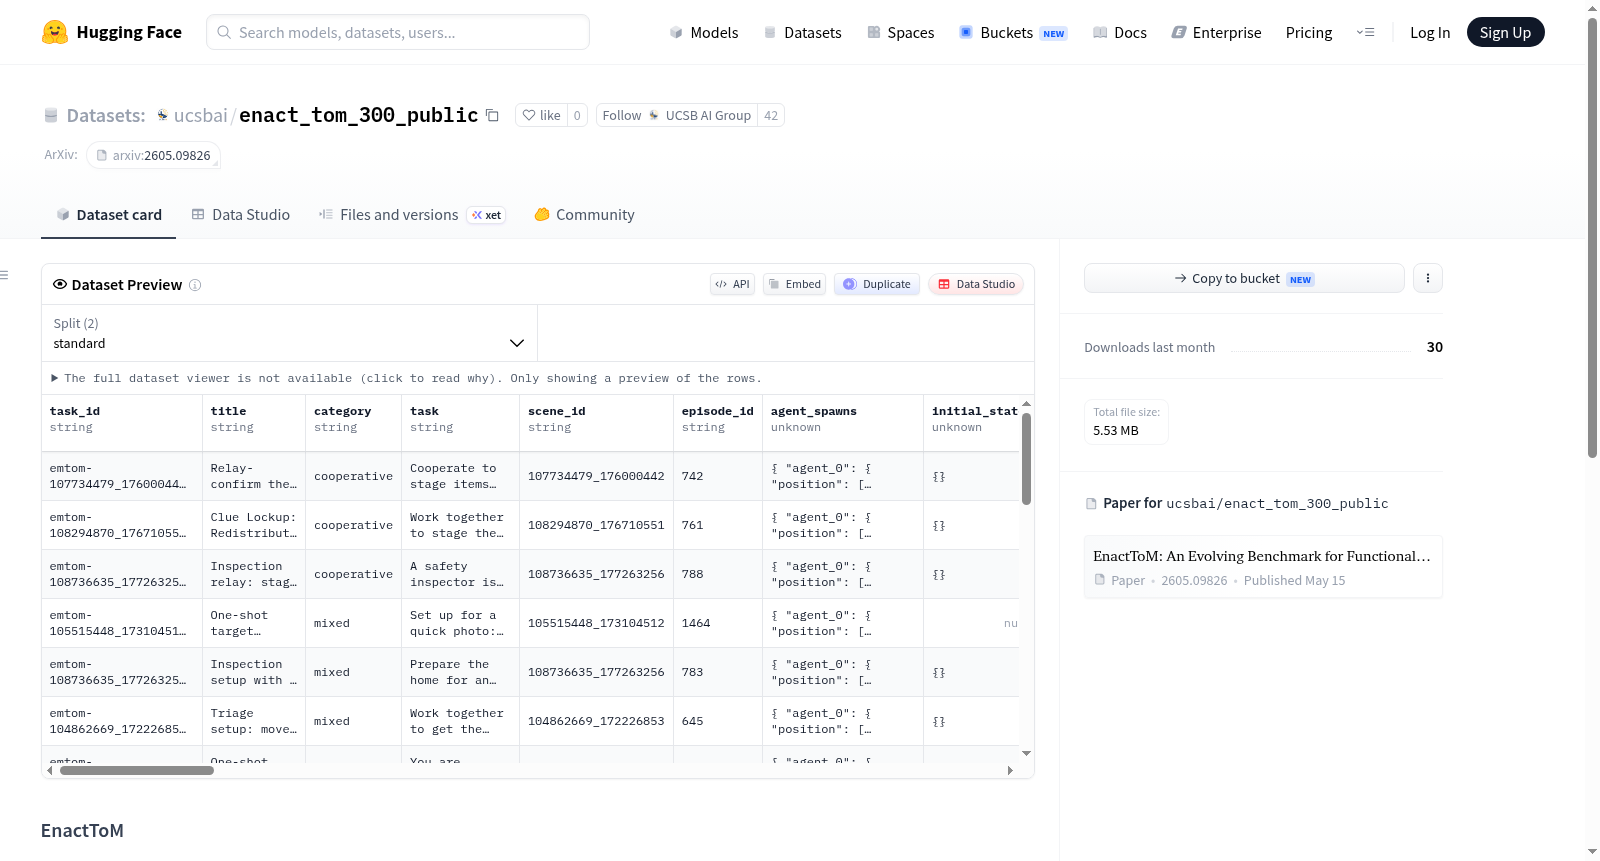
EnactToM数据集是一个公开的300条目版本,基于相关论文,用于评估理论思维(Theory of Mind)任务。数据集包含两个分割:标准版(150个条目)和困难版(150个条目),总共有289个唯一任务ID,其中11个任务ID在两个分割中重复出现。数据集文件包括JSONL格式的标准和困难条目文件、对应的单独JSON文件目录,以及一个清单文件,记录分割成员关系、评估子集、选择方法和任务来源。数据集保留了PDDL目标、游戏机制、私有代理信息、literal-ToM探针和黄金轨迹,但移除了内部校准轨迹和模型展开,旨在支持理论思维相关的研究和评估。

The EnactToM dataset is a public 300-entry release based on the associated paper, designed for evaluating Theory of Mind tasks. It consists of two splits: Standard (150 entries) and Hard (150 entries), with a total of 289 unique task IDs, of which 11 task IDs are reused across both splits. The dataset files include JSONL files for Standard and Hard entries, corresponding directories with individual JSON files, and a manifest file that records split membership, inferred evaluation subsets, selection methods, and per-task provenance. It retains PDDL goals, mechanics, private agent information, literal-ToM probes, and golden trajectories, while internal calibration traces and model rollouts have been removed, aiming to support research and evaluation in Theory of Mind.
提供机构:
ucsbai
搜集汇总
数据集介绍
ucsbai/enact_tom_300_public 数据集图片
构建方式
EnactToM数据集源自arXiv预印本研究,旨在评估大规模语言模型在复杂社会认知场景中的推理能力。该数据集共包含300条精心设计的任务条目,依据难度划分为Standard与Hard两个子集,各含150条。其构建过程严格遵循原始论文中报告的数据集组成比例,通过重构三轮模型评估结果与聚合统计指标,确保任务分配的随机性与均衡性。除核心条目外,还提供manifest.json文件记录每个任务的分割归属、推测的论文评估子集、选择方法及聚合统计信息。任务定义保留了PDDL目标、机械设定、私有智能体信息、字面ToM探针及黄金轨迹,而内部校准痕迹与模型生成结果则被剔除,以保障数据纯净性与评估公平性。
特点
EnactToM数据集的核心特点在于其精巧的层次化结构与真实的社会交互模拟能力。数据集涵盖11个在两种分割中复用的任务ID,共289个唯一任务实体,体现了任务多样性与跨难度的一致性。Standard与Hard子集分别对应不同复杂度的协同与混合动机场景,精确复现了论文表3中40条任务子集的评估框架。每条任务均包含完整的逻辑符号化描述与多智能体交互轨迹,支持对模型在心智推理、策略规划与信息不对称处理维度的深度检验。此类设计使得EnactToM成为评估语言模型高级社会认知能力的标准化基准。
使用方法
使用EnactToM数据集时,研究者可直接加载standard.jsonl与hard.jsonl文件进行实验。数据集支持两档难度分离测试,便于分析模型在不同认知负荷下的表现差异。建议结合manifest.json中的元信息,定位特定任务所属的评估子集与来源,以复现论文中的评估体系。由于任务保留了PDDL格式的原始定义,可将其转换为标准输入格式供语言模型推理。测试时,模型需依据私有智能体信息与轨迹回答问题,其输出将通过与黄金轨迹比对来评估准确性。该数据集适用于对比实验与消融研究,尤其适合探究模型在理论心智推理上的能力边界。
背景与挑战
背景概述
EnactToM数据集由研究团队于2025年创建,旨在探索智能体在复杂协作环境中的心智理论(Theory of Mind, ToM)能力。该数据集聚焦于多智能体推理任务,通过设计包含私有信息、PDDL目标及动作轨迹的交互场景,评估智能体对他人信念、意图和目标的推断能力。作为公开的300条样本子集,它由150个标准难度和150个高难度任务构成,覆盖22个协作任务与18个混合任务,并在论文中展示了基于三回合模型结果的评估指标(如pass@3)。EnactToM的发布为ToM量化研究提供了标准化基准,推动了智能体社会认知能力的发展。
当前挑战
该领域面临的核心挑战在于如何精确建模智能体对他人心智状态的动态推断,尤其是在不完全信息与混合动机场景下,现有模型常无法区分理性协作与策略性欺骗。数据集构建过程中,研究者需平衡任务多样性(如复用部分任务ID)与难度分层(Standard vs. Hard),同时确保ToM探针的严格性,即从原始轨迹中剥离内部校准数据以避免泄漏。此外,评估指标的可靠性(如pass^3百分比)需依赖多轮模型输出的特定重组方法,这增加了结果复现与跨模型比较的复杂性。
常用场景
经典使用场景
在认知科学与人工智能交叉领域,EnactToM数据集被视为评估与训练心智理论(Theory of Mind, ToM)能力的标杆性资源。其经典使用场景在于,通过两类精心设计的子集——Standard与Hard——系统性地考察自主智能体在合作与混合情境下推断他人信念、意图与知识状态的能力。研究者通常利用该数据集中的PDDL目标定义、私密智能体信息以及字面ToM探针,构建模型需依据给定的黄金轨迹完成信念追踪与递归推理的任务范式,从而检验当前大型语言模型或神经符号系统在复杂社会互动中的心理模拟水平。该设置尤其适用于衡量模型在结构化环境中的递归心智推理深度与抗混淆能力,构成多智能体情境理解研究的核心基准。
解决学术问题
EnactToM数据集直接回应当前人工智能领域一个显著且长期存在的学术挑战:现有模型能否在结构化、多智能体规划任务中展现出与人类相当的心智理论能力。此前,相关研究多受限于简单或非交互式的评估范式,难以有效区分模型的行为模仿与真正的心智模型构建。该数据集通过精细划分合作与竞争混合情境,并设置Hard子集以强化需递归信念推断的难度,精准地探测模型在面对信息不对称时的信念更新与意图归因能力。这一设计有助于揭示模型在社会认知层面的本质性缺陷或涌现性能力,推动对意识、意图与共同知识形式化表征的深入理解,为构建真正具有社会智能的自主系统提供了坚实的数据基础与评估框架。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

