
electricsheepeurope/europe-ilo-emp-pifl-sex-geo-mts-nb-employment-outside-the-formal-sector-by-sex-rural
收藏数据链接:
官方服务:
资源简介:
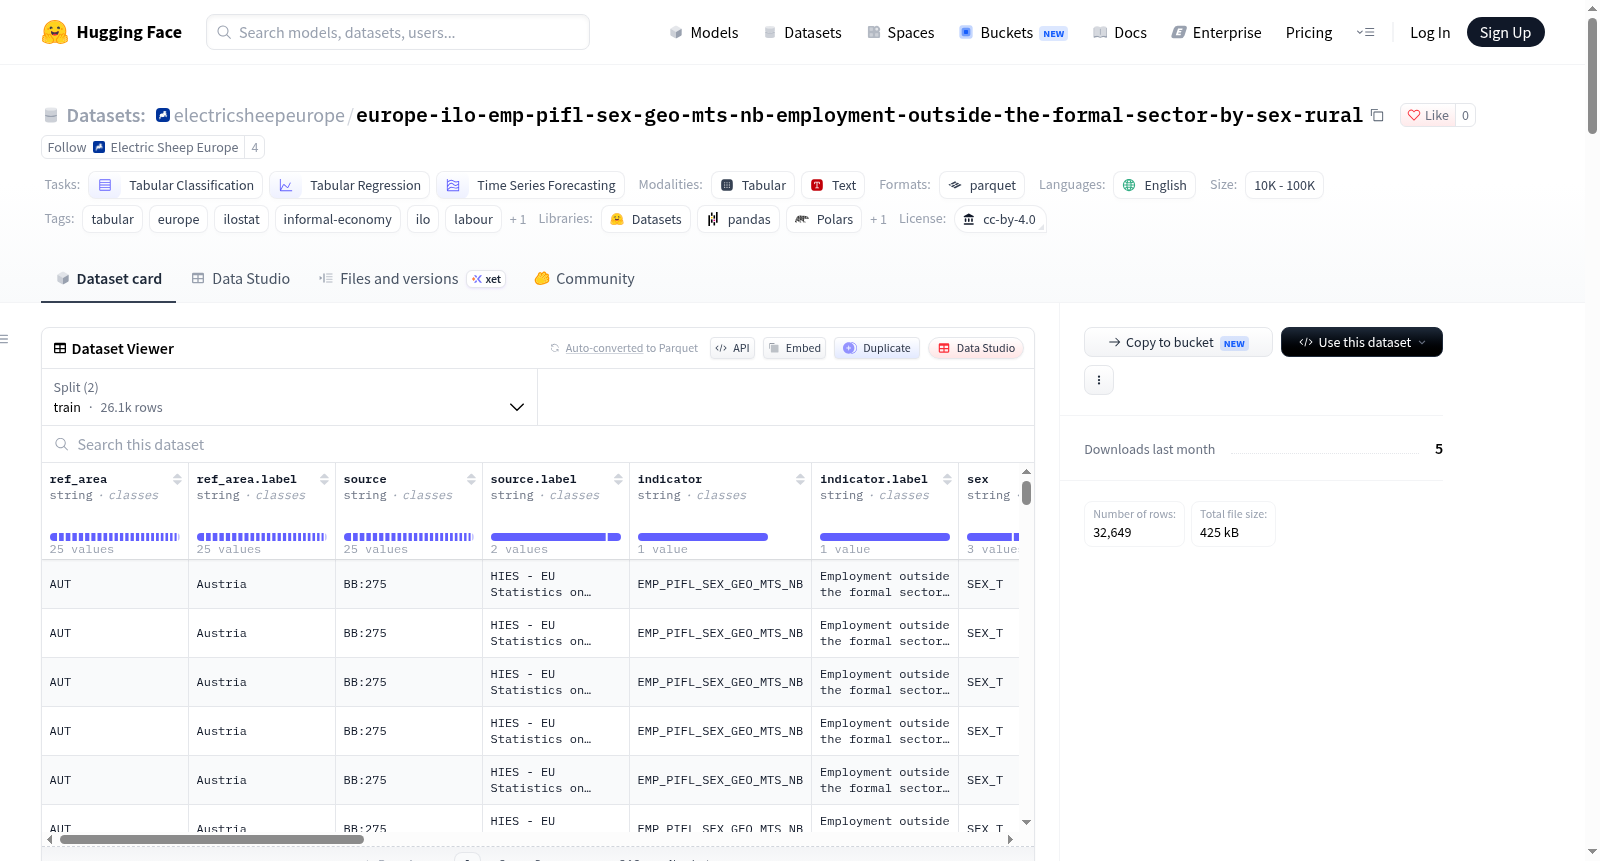
该数据集包含欧洲非正规经济部门就业的统计信息,按性别、城乡地区和婚姻状况分类(单位:千人)。数据涵盖31个欧洲国家,时间跨度为2003年至2025年,共有32,649个观测值,基于国际劳工组织(ILO)的ILOSTAT数据库。数据集包括国家代码、指标代码、性别分类、时间、观测值等列,用于分析非正规经济就业趋势。
Employment outside the formal sector by sex, rural / urban areas and marital status (thousands) data for Europe, covering 31 countries from 2003 to 2025, with 32,649 observations, sourced from the International Labour Organizations ILOSTAT database. The dataset includes columns such as country code, indicator code, sex disaggregation, time, and observed values for analyzing informal economy employment trends.
提供机构:
electricsheepeurope搜集汇总
数据集介绍
构建方式
该数据集派生自国际劳工组织(ILO)的核心统计数据库ILOSTAT,其构建遵循标准化的数据采集与整编流程。原始微观调查数据由各国劳动力调查、家庭收入调查及行政记录汇集而成,经ILO统计部门依据国际劳工统计学家会议(ICLS)定义进行跨国协调与标准化处理。Electric Sheep Europe通过ILOSTAT REST API接口直接抓取指标EMP_PIFL_SEX_GEO_MTS_NB,并使用欧洲ISO3国家代码进行筛选与再封装,同时保留source.label等溯源字段,确保数据来源可验证。
特点
数据集收录2003至2025年间31个欧洲国家的32,649条观测记录,聚焦于非正规部门就业统计,涵盖性别、城乡区域及婚姻状况等多维分类。数据结构以年度频率呈现,包含国家代码、指标编码、性别分类、区域类型及婚姻状况聚合等关键字段,并提供观测状态标志与注释标签。数据集以表格形式封装,适用于分类、回归与时间序列预测等任务,其多语言单语特性与中等规模跨度(1万至10万条)兼顾了分析的灵活性与统计的稳健性。
使用方法
使用者可通过HuggingFace datasets库的load_dataset函数便捷加载该数据集,并将其转换为Pandas数据框以进行后续分析。典型操作包括按国家代码筛选特定国家(如德国)、按指标编码提取时间序列、以及透视生成国家与年份的交叉矩阵。数据集支持直接绘制趋势图与统计建模,尤其适合探究欧洲非正规就业的性别差异与城乡分布格局。使用时需注意引用ILO原始来源及Electric Sheep Europe的再封装工作,并遵守CC-BY-4.0许可协议。
背景与挑战
背景概述
非正规部门就业长期构成全球劳动力市场的重要议题,其规模与分布深刻反映经济发展水平、社会保障覆盖及性别平等状况。国际劳工组织(ILO)自二十世纪末持续推动非正规就业统计标准化,依托国际劳工统计学家会议(ICLS)决议构建跨国可比指标体系。在此背景下,Electric Sheep Europe于2025年对ILOSTAT数据库进行重新封装,发布涵盖31个欧洲国家、2003至2025年、共计32,649条观测的非正规部门就业数据集,按性别、城乡及婚姻状况多维 disaggregation,为劳动经济学、社会政策与性别研究提供细粒度量化基础,亦构成欧洲劳动力市场非正规性监测的重要数据基础设施。
当前挑战
该数据集所应对的核心领域问题在于非正规部门就业的精准测度与跨国可比性。非正规经济活动常游离于官方登记与税务体系之外,依赖劳动力调查、家庭收入调查等多元来源进行估算,不同国家在抽样设计、定义口径及数据发布时效上存在显著异质性,导致指标口径统合困难。构建过程中,ILO虽以ICLS标准进行调和并标注来源与质量旗标,但部分国家年份仍存在数据缺失、观测值不可靠或仅为临时估计等状况,且城乡与婚姻状况分类在部分国家并未完整发布,形成结构性稀疏。时间跨度内定义修订与调查方法变迁亦引入序列断裂风险,对长时段趋势分析与跨国面板建模构成持续性挑战。
常用场景
经典使用场景
在劳动经济学与非正规经济研究领域,该数据集最为经典的运用场景在于刻画欧洲各国非正规部门就业的性别差异与城乡分野。研究者借助其涵盖三十一国的面板数据,得以系统比较男性与女性、农村与城市居民在非正规就业中的参与率与绝对规模,进而揭示劳动力市场边缘化的结构性特征。此类分析往往以时间序列为轴,追踪2003年至2025年间各国非正规就业的演变轨迹,为理解欧洲一体化进程中劳动力市场的非均衡发展提供翔实的实证基础。
实际应用
在政策实践层面,该数据集为国际组织与各国劳工部门制定就业促进策略提供了关键依据。通过识别非正规就业高发的性别与地域群体,政策制定者能够更有针对性地设计社会保障扩面、技能培训与农村就业扶持项目。此外,该数据集亦可用于监测可持续发展目标中关于体面劳动指标的落实进展,辅助评估宏观经济波动与制度变革对非正规就业的冲击,从而为劳动力市场治理提供循证决策的基础。
衍生相关工作
围绕该数据集,学界衍生出一系列具有影响力的研究工作。比较劳动制度与性别分工的跨国研究常以其为核心数据源,探讨非正规就业如何嵌入家庭与社区结构。部分学者将其与收入调查、社会保障统计等微观数据链接,构建多维度分析框架,考察非正规就业与贫困代际传递的关联。此外,该数据集亦被用于训练与验证时间序列预测模型,推动劳动统计数据的机器学习应用,拓展了传统计量分析的方法边界。
以上内容由遇见数据集搜集并总结生成


