RxnOptBench-review
收藏资源简介:
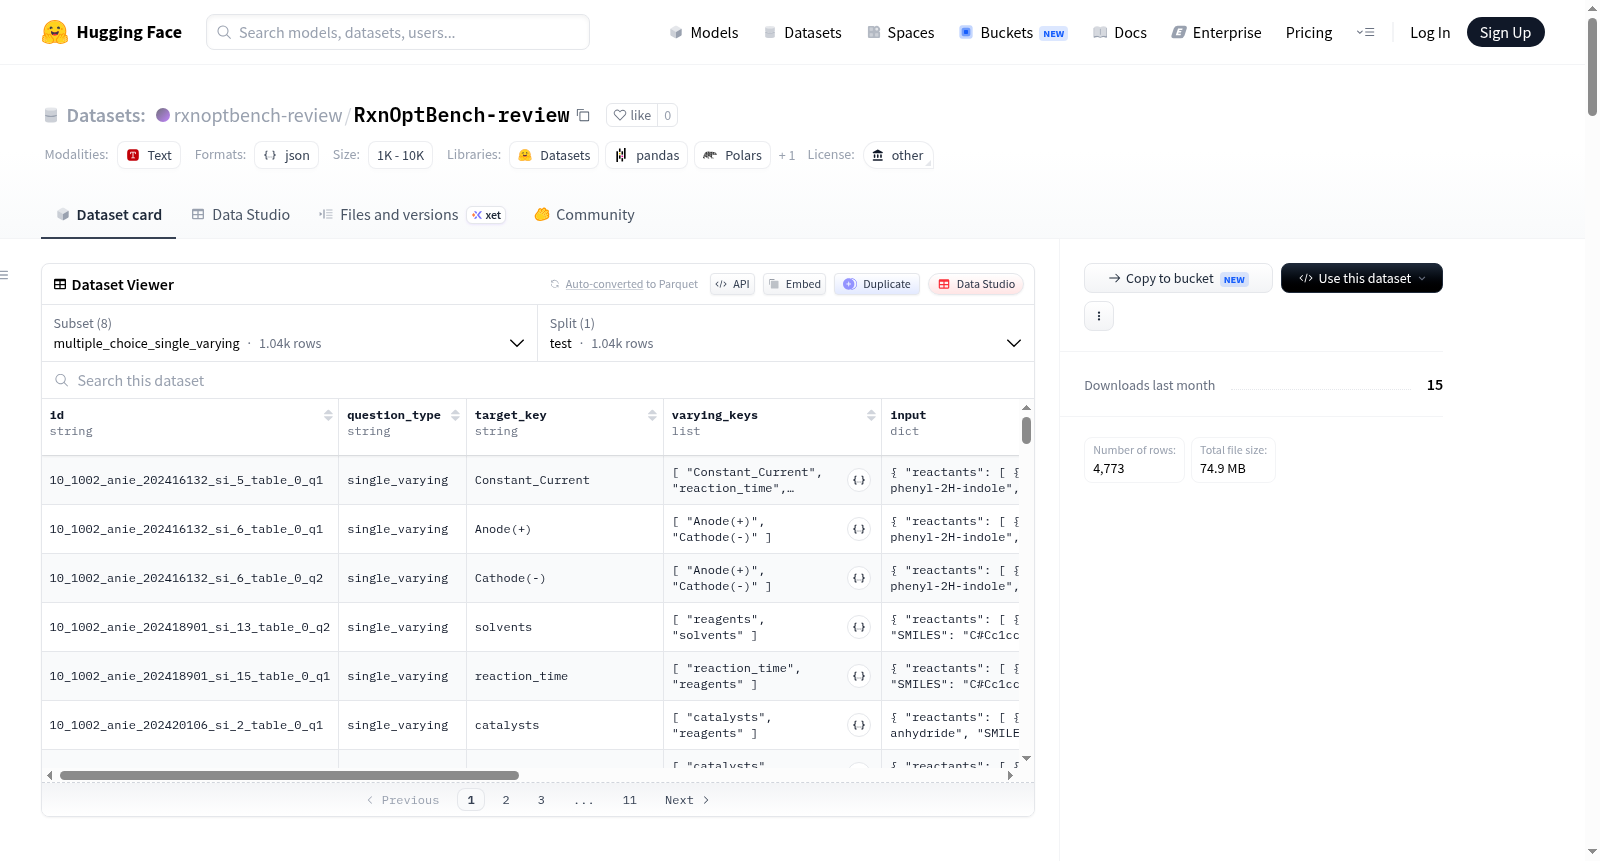
RxnOptBench是一个用于反应条件推荐系统离线评估的固定基准测试数据集。它包含4,773个问题实例,源自552个结构化源表和232个不区分大小写的规范DOI标识(保留236个原始区分大小写的DOI字符串)。数据集提供八个不同的配置,涵盖两种主要任务类型:多项选择题(包含单变量变化、全变量变化、参考增强及控制变体)和填空题(全空白及参考增强变体)。每个配置仅包含测试集,问题数量从310到1039不等。数据记录包含完整的反应上下文信息,包括恒定条件和固定条件。数据集适用于反应条件推荐系统的离线评估、多项选择题与填空题任务中模型行为的受控比较,以及参考条件、候选空间构建和评分规则对模型性能影响的消融研究。数据来源于已发表的文献表格,描述了化学反应、反应条件、观察结果和规范化源文章标识符,不包含个人、人口统计、医疗、政治或其他人类敏感属性。数据集具有明确的局限性:仅测量文献观察到的反应条件在受限候选空间中的离线选择或排序能力,不测量端到端实验室执行、安全性、成本、可扩展性或开放式规划;由于依赖上游结构化表格提取流程,在反应类别、底物、条件类别、期刊、出版商和出版年份方面的覆盖不均匀;存在文献固有的发表偏倚。
RxnOptBench is a fixed benchmark dataset for offline evaluation of reaction condition recommendation systems. The dataset is published as a Hugging Face dataset repository, compatible with the dataset viewer and the Croissant metadata workflow used by the NeurIPS 2026 Evaluation and Data Track. It contains 4,773 problem instances derived from 552 structured source tables and 232 case-insensitive canonical DOI identifiers (retaining 236 original case-sensitive DOI strings). The dataset provides eight different configurations covering two main task types: multiple-choice questions (including single-variable variation, full-variable variation, reference-enhanced, and control variants) and fill-in-the-blank questions (full-blank and reference-enhanced variants). Each configuration only includes a test set, with the number of questions ranging from 310 to 1,039. Data records contain complete reaction context information, including constant and fixed conditions. The dataset is suitable for offline evaluation of reaction condition recommendation systems, controlled comparisons of model behavior in multiple-choice and fill-in-the-blank tasks, and ablation studies on the impact of reference conditions, candidate space construction, and scoring rules on model performance. The data is sourced from published literature tables describing chemical reactions, reaction conditions, observations, and normalized source article identifiers, and does not contain personal, demographic, medical, political, or other human-sensitive attributes. The dataset has clear limitations: it only measures offline selection or ranking capabilities of reaction conditions observed in the literature within a restricted candidate space, and does not measure end-to-end laboratory execution, safety, cost, scalability, or open-ended planning; coverage is uneven across reaction classes, substrates, condition classes, journals, publishers, and publication years due to reliance on upstream structured table extraction processes; and there is inherent publication bias in the literature.
数据集名称
RxnOptBench (版本 0.2.3-review)
数据集概述
RxnOptBench 是一个用于离线评估反应条件推荐系统的固定基准测试集。该数据集是 NeurIPS 2026 评估与数据集轨道的匿名、免凭证同行评审快照,包含 4,773 个问题实例,源自 552 个结构化源表格 和 232 个不区分大小写的规范 DOI 标识。
数据集配置
数据集包含 8 个配置,每个配置仅有一个 test 拆分。配置概览如下:
| 配置名称 | 问题数量 | 问题类型 |
|---|---|---|
multiple_choice_single_varying |
1039 | single_varying |
multiple_choice_all_varying |
552 | all_varying |
multiple_choice_single_varying_reference |
850 | single_varying_reference |
multiple_choice_all_varying_reference |
310 | all_varying_reference |
multiple_choice_single_varying_reference_control |
850 | single_varying_reference_control |
multiple_choice_all_varying_reference_control |
310 | all_varying_reference_control |
fill_in_blank_all_blank |
552 | all_blank |
fill_in_blank_all_blank_reference |
310 | all_blank_reference |
数据文件与仓库结构
- 数据文件:JSONL 格式,位于
data/jsonl/目录。 - 原始 JSON 文件:位于
data/original_json/。 - 提示模板:位于
prompts/。 - 示例预测文件:位于
examples/。 - 评估脚本:位于
evaluation/。 - 化学覆盖分析:位于
analysis/chemical_coverage/。 - 元数据与来源:位于
metadata/和docs/。 - 完整性校验:位于
scripts/。 - 评审者工件:位于
reviewer_artifact/,包含完整提取、问题生成、推理、评估和验证包。
评估方法
- 多项选择:预测应为从
id到 0-based 选项索引的 JSON 映射。 - 填空:预测应为从
id到{condition_key: candidate_index}字典的映射。 - 评估指标:填空任务使用
Hit(命中率)、Strict Accuracy(严格准确率)和Score | Hit(命中时的平均得分)。
提示与答案格式
- 所有提示模板渲染完整的反应上下文,包括
constant_conditions和fixed_conditions(如适用)。 - 多项选择答案:单个 0-based 整数。
- 填空答案:条件键到 0-based 整数索引的 JSON 映射。
来源与来源管理
数据源自结构化基准输出,包括:
testsetV6/20260502_000057_multiple_choicetestsetV6/20260502_000115_fill_in_blank
额外来源清单文件位于 metadata/ 和 docs/。
化学覆盖范围
覆盖审计以 552 个父级筛选表格 为计数单位,报告了:
- 20 种互斥的主要转化类别和多标签键变化、能量输入、催化剂类别和自由基标签。
- 26 个结构化条件字段的普遍性和候选集元数。
- 341 个独特标准产物、232 个非空 Bemis-Murcko 骨架、理化描述符和 Morgan 指纹多样性。
预期用途
- 离线评估反应条件推荐系统。
- 可控比较不同任务(多项选择、参考增强、填空)下的模型行为。
- 研究参考条件、候选空间构建和评分规则对模型性能影响的消融研究。
非预期用途
- 未经验证不适用于直接实验室部署、自主决策、开放反应规划或评估绝对反应成功率。
负责任 AI 说明
- 局限性与偏差:测量的是离线选择能力,而非实验室执行能力;继承文献发表偏差;评分相对于源表格内的最佳选项,而非化学搜索空间的全局最优。
- 个人或敏感信息:不包含个人、人口统计、医疗等敏感属性。
- 社会影响:可促进标准化基准测试,但需注意评分可能被过度解读为实验室就绪性证明。
- 合成数据:数据集中不包含合成反应记录。
加载示例
python from datasets import load_dataset ds = load_dataset("rxnoptbench-review/RxnOptBench-review", "multiple_choice_single_varying", split="test") print(ds[0]["id"])
完整性校验
可通过以下脚本进行本地审计: bash python scripts/validate_hf_release.py python scripts/validate_prompt_context.py