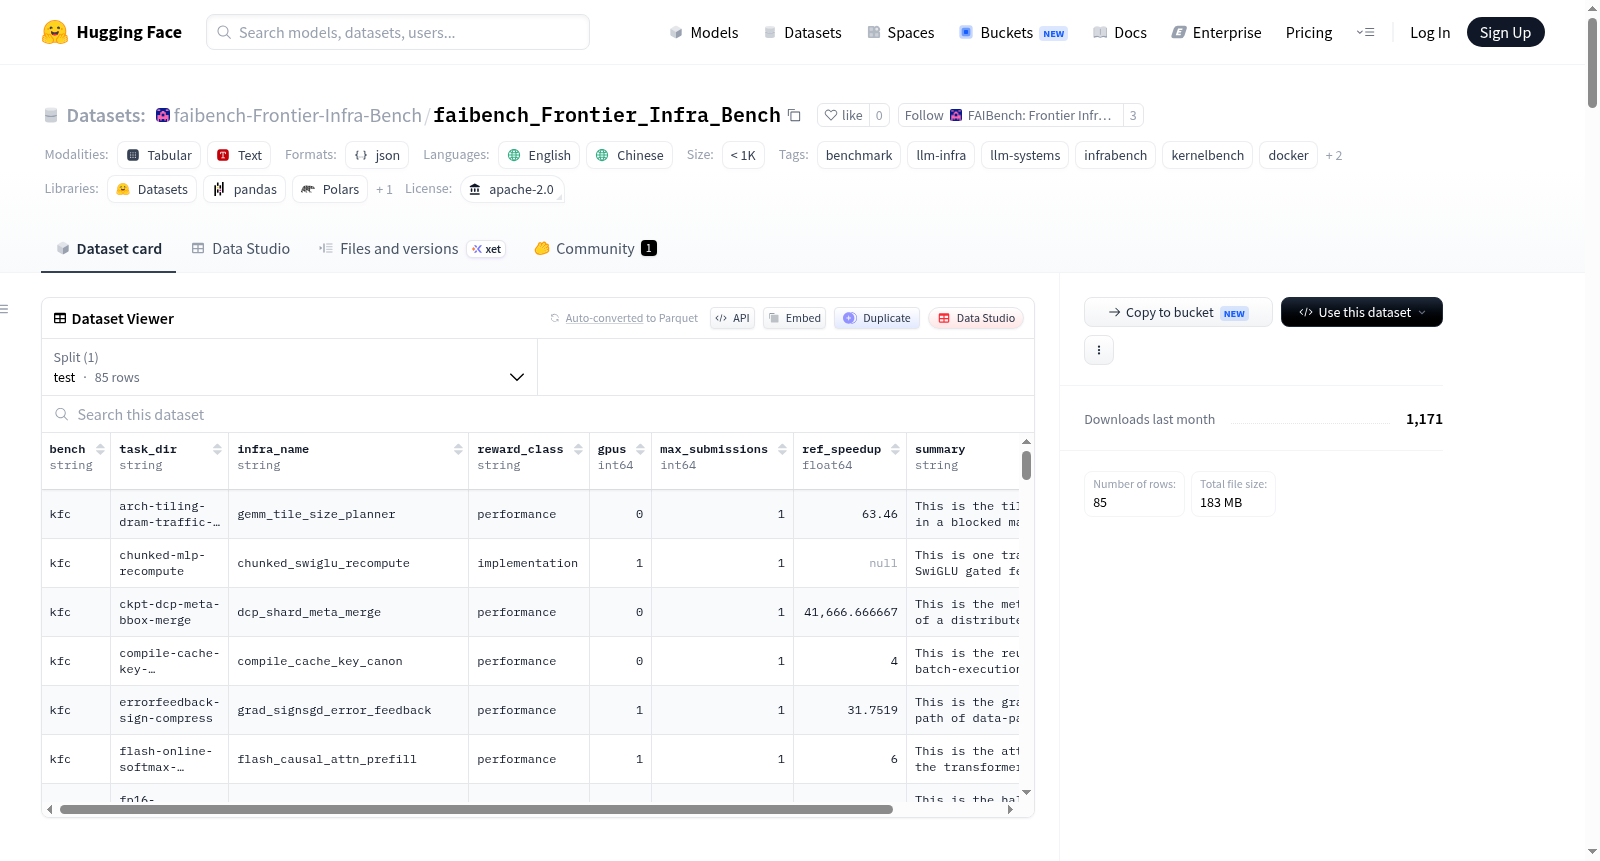
faibench_Frontier_Infra_Bench
收藏资源简介:
Φ-Bench(Frontier AI Infrastructure Benchmark,亦称FAI-Bench / ΦBench)是一个前沿AI基础设施基准测试,旨在评估大语言模型(LLM)和自主编码智能体在真实ML系统与LLM基础设施工程中的能力。该基准测试包含85个开源LLM基础设施工程任务,涵盖三个逐层扩展的设置:Kernel Function Completion(KFC,55个任务,GPU内核实现与优化)、Long-Horizon Implementation(LHI,20个任务,长周期仓库级开发)和End-to-End Optimization(E2EO,10个任务,端到端系统优化)。任务源自前沿系统研究中的实际问题,并基于真实开源仓库构建,覆盖LLM训练与推理的广泛基础设施,包括GPU/CUDA内核优化、分布式训练、推理与部署(vLLM)、低精度与量化、通信与集合、检查点与存储、MoE路由、注意力与状态空间内核等。每个任务提供自包含的公共Dockerfile,通过git clone和docker build可完全复现环境;所有任务均为离线运行,评分系统与包一同发布,支持离线评分。数据集包含机器可读的任务索引(tasks_index.json)和评分公式(SCORING.md),并提供参考实现或Oracle补丁(83个任务)。该基准测试采用Apache-2.0许可证,但vendored上游代码保留原有许可证。
Φ-Bench (Frontier AI Infrastructure Benchmark, also known as FAI-Bench / ΦBench) is a frontier AI infrastructure benchmark designed to evaluate the capabilities of large language models (LLMs) and autonomous coding agents in real ML systems and LLM infrastructure engineering. The benchmark includes 85 open-source LLM infrastructure engineering tasks across three progressively scaled settings: Kernel Function Completion (KFC, 55 tasks, GPU kernel implementation and optimization), Long-Horizon Implementation (LHI, 20 tasks, long-horizon repository-level development), and End-to-End Optimization (E2EO, 10 tasks, end-to-end system optimization). The tasks are derived from practical problems in frontier systems research and are built on real open-source repositories, covering a broad range of LLM training and inference infrastructure, including GPU/CUDA kernel optimization, distributed training, inference and deployment (vLLM), low-precision and quantization, communication and collectives, checkpointing and storage, MoE routing, attention and state-space kernels, etc. Each task provides a self-contained public Dockerfile, allowing full environment reproduction via git clone and docker build; all tasks run offline, and the scoring system is released with the package, supporting offline scoring. The dataset includes a machine-readable task index (tasks_index.json) and scoring formulas (SCORING.md), and provides reference implementations or Oracle patches (83 tasks). The benchmark is licensed under Apache-2.0, with vendored upstream code retaining their original licenses.
Φ-Bench (FAI-Bench) 数据集详情
数据集概述
Φ-Bench (Frontier AI Infrastructure Benchmark) 是一个用于评估前沿大语言模型(LLM)和自主编码代理在真实世界ML系统和LLM基础设施工程中能力的基准测试集。该数据集包含 85个开源的LLM基础设施工程任务,覆盖GPU/CUDA内核优化、分布式训练、推理与服务(vLLM)、低精度与量化、通信/集合通信、检查点与存储、MoE路由、注意力与状态空间内核等领域。
基本信息
- 名称: Φ-Bench: Frontier AI Infrastructure Benchmark
- 许可证: Apache-2.0
- 语言: 英语、中文
- 数据集规模: n<1K(少于1000个样本)
- 标签: benchmark, llm-infra, llm-systems, infrabench, kernelbench, docker, cuda, gpu
- 任务数量: 85个
- 官网: http://llminfrabench.com/
任务分类
数据集任务分为三个子集,覆盖从局部到全局的工程范围:
| 子集 | 任务数 | 任务类型 |
|---|---|---|
| KFC (Kernel Function Completion) | 55 | 单内核实现与优化 |
| LH (Long-Horizon Implementation) | 20 | 长时程仓库级开发 |
| E2E (End-to-End Optimization) | 10 | 端到端系统优化 |
任务设计特点
- 完全离线: 所有任务设置
allow_internet = false,求解和评分均离线运行,所有依赖(包括模型权重和数据集)在docker build时固化到镜像中。 - Docker 可复现: 每个任务附带自包含的公共 Dockerfile,通过
git clone+docker build即可复现环境。 - 评分机制: 任务包中附带评分器(grader),通过
tests/test.sh和compute_reward.py进行评分。 - 性能锚点: 奖励函数形式为
min(1, ln(speedup/ref_speedup)/ln(ref_speedup)),需超过参考加速比才能获得正分数;77个任务带有性能锚点。
包结构
tasks_index.json: 85个任务的机器可读索引(包根路径、布局、GPU、范围、锚点、oracle可用性)SCORING.md: 两类奖励的评分公式scripts/verify_package.py: 包自检脚本tasks/kfc/,tasks/lh/,tasks/e2e/: 三个子集的任务目录- 每个任务的包根目录包含:
instruction.md(模型唯一可见输入)、task.toml(资源配置)、Dockerfile、environment/(含挖掘出的工作树)、tests/(评分面)、solution/(参考实现)
运行方式
- 构建镜像:
docker buildx build -f environment/Dockerfile -t <image> . - 运行容器让代理求解:
docker run --rm [--gpus all] -it <image> - 评分:
docker run --rm [--gpus all] -v "$PWD/tests:/tests:ro" <image> bash /tests/test.sh - 查看奖励:
cat /logs/verifier/reward.json
也可使用 scripts/run_task.py 任务运行器自动化整个流程(构建→代理→评分→奖励),该脚本为单文件且仅依赖标准库。
重要约定
tests/与镜像一起发布但永不嵌入镜像,仅在评分时挂载(隐藏测试用例、强基线和校准锚点均在其中)。- 工作树式提交合同: 代理直接编辑允许的文件并保留在工作树中的更改,评分读取树与基线提交的diff;代理不得执行
git commit。 - 代理CLI在运行时注入:镜像不附带任何代理,通过
--agent-bin挂载或--agent-install安装。 - 83个任务附带参考补丁/oracle,可通过
--agent oracle路径验证参考得分。
可复现性与验证
- 挖掘出的工作树是自证的:
oracle.patch必须在environment/repo/上正向干净应用且反向应用失败,以证明该树正是参考补丁所针对的基线。 scripts/verify_package.py提供只读自检,验证必需文件、task.toml解析、Dockerfile 可解析、锚点和注意事项一致性、树自证等。
许可说明
- 自有工作(任务规范、评分器、参考方案、loop16框架、运行器和自检脚本、文档)采用 Apache 2.0 许可证。
- 从公共源获取的供应商上游代码(如 nanoGPT、torchtitan、vLLM、llama.cpp、Megatron-LM、ColossalAI等)及模型权重/数据集(如 Qwen2.5、all-MiniLM-L6-v2、wikitext等)保留其原始许可证和版权,不包含在 Apache-2.0 授权范围内。