
xiaodu-ali/CrystalXRD-Bench
收藏官方服务:
资源简介:
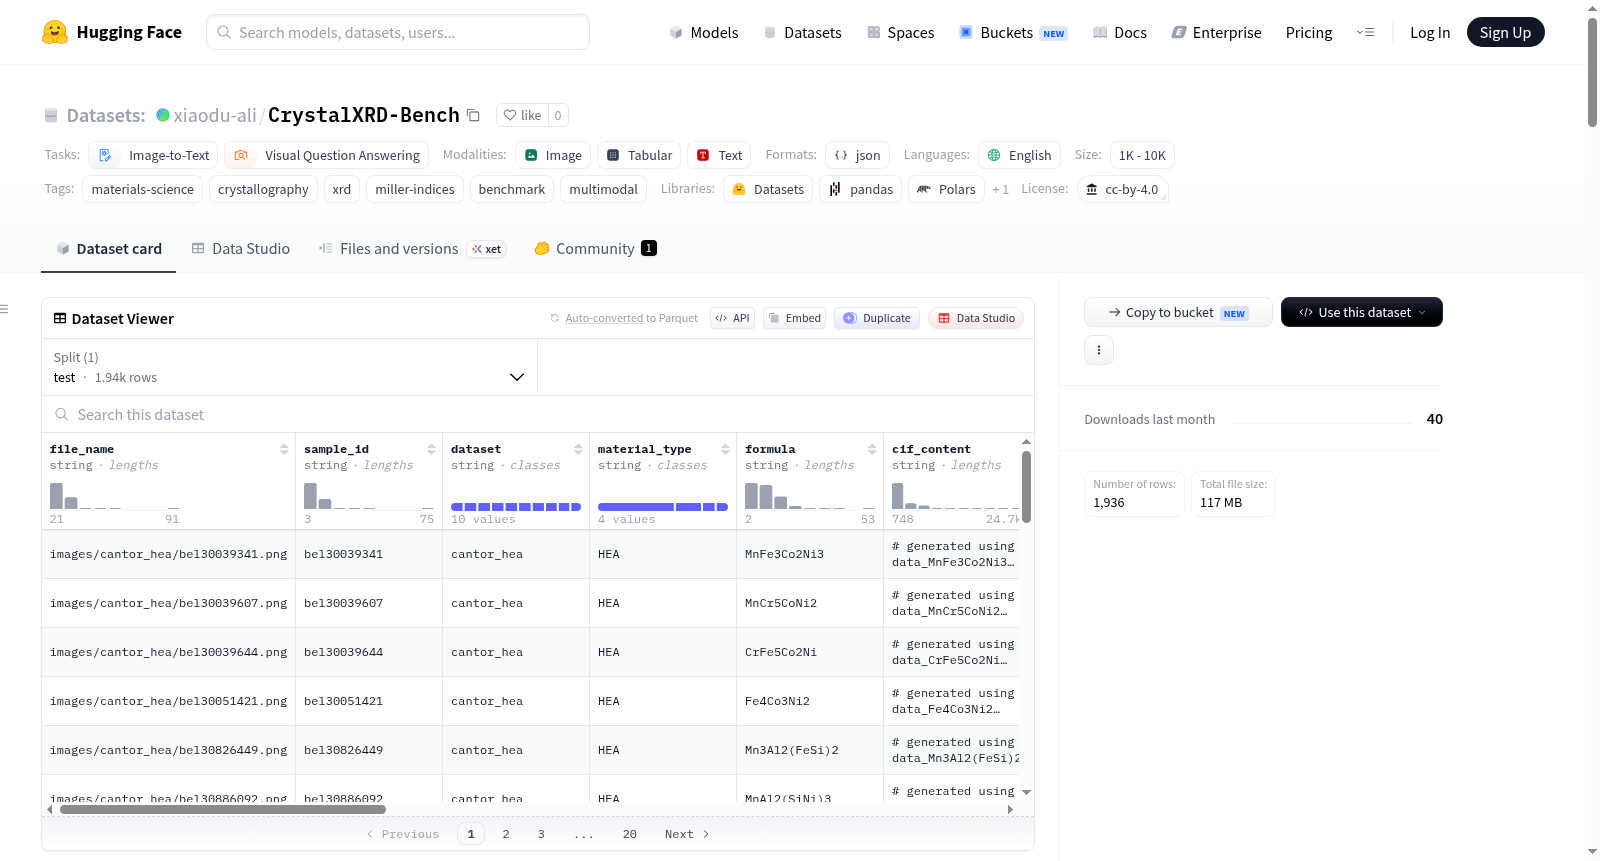
LLM4Mat-Bench是一个用于评估视觉语言模型在晶体学推理任务上表现的多模态基准数据集。给定一个理论X射线衍射图案图像和相应的晶体结构文件,模型必须识别出贡献最高强度峰的晶面对应的米勒指数。该基准测试了视觉模式识别与材料科学领域知识的交叉点——这是一项需要理解XRD物理和晶体学索引的挑战性任务。
LLM4Mat-Bench is a multimodal benchmark for evaluating Vision-Language Models (VLMs) on crystallographic reasoning tasks. Given a theoretical X-ray Diffraction (XRD) pattern image and the corresponding crystal structure (CIF), the model must identify the Miller indices (HKL) of the crystallographic planes contributing to the highest-intensity peak. This benchmark tests the intersection of visual pattern recognition and materials science domain knowledge — a challenging task that requires understanding both XRD physics and crystallographic indexing.
提供机构:
xiaodu-ali搜集汇总
数据集介绍
构建方式
CrystalXRD-Bench数据集的构建根植于材料科学与晶体学的深厚土壤,旨在为视觉-语言模型(VLMs)在晶体学推理任务上的表现提供严苛的评估基准。其构建过程严谨而系统:首先,从十个权威材料数据库(如Materials Project、JARVIS、OQMD、GNoME等)中精选出涵盖无机材料、金属有机框架(MOF)、有机材料及高熵合金(HEA)等共计1936个样本,确保数据来源的多样性与代表性。随后,利用CIF晶体结构文件,通过pymatgen工具模拟计算理论X射线衍射(XRD)图谱,设定Cu Kα辐射源,2θ角范围2°至90°,步长0.01°,并采用Pseudo-Voigt峰形(η=0.4),FWHM为0.15°,以模拟接近真实的衍射效应。在峰值识别上,采用'contributors union within tolerance'策略,对最高峰设定±0.30°(即2倍FWHM)的容差窗口,收集所有在该窗口内且相对强度不低于峰值10%的布拉格反射,其对应的米勒指数(HKL)集合构成真值标签,从而捕捉由对称性或偶然简并导致的多重贡献峰。
特点
该数据集的核心特点在于其多模态与领域深度的融合,直击晶体学分析中的要害难题。每个样本均包含XRD图谱图像、化学式、完整CIF结构数据以及详尽的注释信息,形成了一个多层次的测试场。尤为独特的是,任务正视了视觉峰与布拉格反射之间的一对多映射关系,要求模型不仅识别单一最强峰,更要解析出所有贡献晶面,这一设计挑战了模型对晶体对称性与衍射物理的深层理解。此外,数据集的构成体现了广泛的材料覆盖度,从无机到有机,从传统合金到前沿MOF,各类型占比均衡,并兼顾了六方/三方体系所需的四指数(Miller-Bravais)约定。基准采用基于集合的评估指标(Jaccard相似度、精确率、召回率、F1分数),严格禁止HKL等价匹配,确保了评价的客观性与精确性,为材料信息学中的多模态模型提供了高难度的试金石。
使用方法
CrystalXRD-Bench数据集的使用方式简洁且高效,旨在无缝集成于视觉-语言模型的评估流程。研究者可通过HuggingFace datasets库中的`load_dataset`函数一键加载测试集,其中每个样本都封装了图像、CIF文本、化学成分及精心设计的提示词(prompt),可直接输入VLM进行端到端的推理。数据集提供了标准的Python接口,允许通过`.filter`方法便捷地按源数据库或材料类型筛选子集,以适应特定的研究需求。真值标签以JSON字符串格式存储,易于解析,配套的`evaluate.py`脚本实现了标准评估协议的封装,支持从预测结果文件与真值文件计算Jaccard相似度、精确率、召回率与F1分数,确保了评估流程的标准化与可复现性。研究者还可利用`properties`字段获取额外的材料性质,用于深入分析模型表现与材料属性之间的关联,从而推动多模态模型在晶体学乃至更广泛科学发现中的应用。
背景与挑战
背景概述
晶体学作为材料科学的基石,其核心任务之一在于解析X射线衍射图谱与晶体结构间的内在关联。随着人工智能在科学研究中的深入应用,多模态大语言模型在材料信息学中的潜力日益凸显。然而,现有视觉-语言模型在晶体学推理任务上的评估尚属空白,这严重制约了该领域的发展。在此背景下,LLM4Mat-Bench数据集应运而生,由来自材料科学与人工智能交叉领域的研究团队于2025年创建,旨在系统评估视觉-语言模型在衍射图谱解析与米勒指数识别方面的能力。该数据集整合了来自Materials Project、JARVIS、OQMD等权威材料数据库的1936个样本,覆盖无机、金属有机框架、有机及高熵合金等多元材料体系,为晶体学任务的多模态人工智能研究提供了标准化评测基准。其发布不仅填补了该领域数据集缺失的空白,更推动了人工智能辅助晶体学分析的进程,对材料科学的信息化转型产生了深远影响。
当前挑战
该数据集主要面临双重挑战。其一,针对领域问题,需解决从理论衍射图谱中精准识别米勒指数的核心难题。由于晶格对称或偶然简并导致单一衍射峰可能对应多个晶面反射,模型需在可视图谱与晶体结构数据间建立复杂映射,并识别所有贡献晶面,这对模型的多模态感知与晶体学知识提出了极高要求。其二,数据集构建过程本身充满挑战。为确保基准的合理性与可靠性,研究者需从多个异构材料数据库中提取数据,处理不同来源的格式差异与属性标注不一致问题。同时,理论衍射图谱的生成需精确保留物理参数,而真值标签的计算需采用“容差并集”方法,以处理峰重叠与弱反射排除,这一过程涉及复杂的晶体学计算与算法设计,对构建者的专业素养与工程能力构成了严峻考验。
常用场景
经典使用场景
CrystalXRD-Bench作为一项专为评估视觉-语言模型(VLMs)在晶体学推理能力而设计的多模态基准,其经典应用场景聚焦于从X射线衍射(XRD)图谱图像中精确识别最强衍射峰所对应的米勒指数(HKL)。该任务要求模型综合理解XRD物理原理、晶体学索引规则以及视觉模式识别,以应对真实晶体材料中因晶格对称性或偶然简并性导致的多重布拉格反射重叠现象。此基准为材料科学与人工智能的交叉研究提供了标准化、可量化的测试平台,推动了多模态模型在科学图像理解领域的深度应用。
衍生相关工作
基于CrystalXRD-Bench,学术界已涌现一系列衍生工作,涵盖模型架构创新、训练策略改进及跨领域迁移研究。例如,研究者利用该基准训练了专门针对晶体学任务的微调VLM,探索了图像-文本联合嵌入在科学数据上的表示学习;同时,该基准也被用作评估大型语言模型(LLM)在材料科学推理上的能力的工具,催生了将XRD分析与其他物理化学性质预测相结合的多任务学习框架。此外,其真值生成方法被后续工作采纳,推动了更为复杂XRD分析基准的设计,形成了一个围绕自动化晶体学解析的活跃研究脉络。
数据集最近研究
最新研究方向
CrystalXRD-Bench(即LLM4Mat-Bench)作为多模态基准,正引领材料科学领域视觉语言模型(VLM)在晶体学推理方向的前沿探索。该基准聚焦于从XRD图谱图像与晶体结构(CIF)中识别最强衍射峰的米勒指数(HKL),其核心挑战在于处理因晶格对称或简并导致的多个布拉格反射叠加问题,要求模型不仅具备视觉特征提取能力,还需深谙XRD物理学与晶体学索引规则。当前研究趋势围绕高熵合金(HEA)、金属有机框架(MOF)及有机材料等多样化体系的跨域泛化评估,并探索精确匹配与集合相似度等度量方式,以推动AI在自动化材料表征与逆向设计中的实际应用,加速从实验数据到结构解析的智能化闭环。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


