korean-pii-dataset
收藏资源简介:
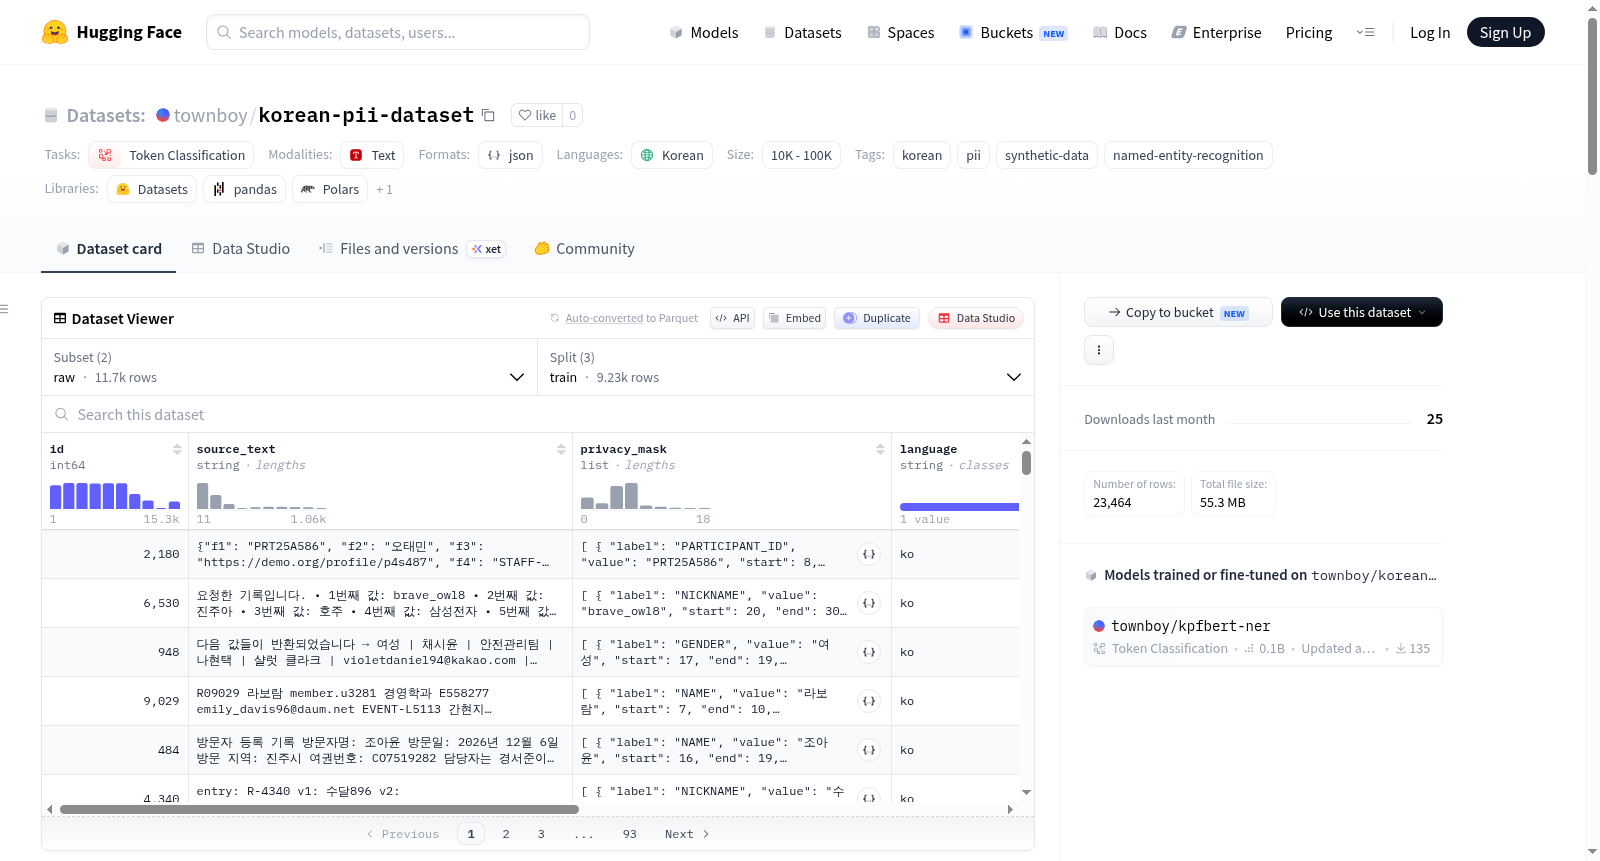
Korean Synthetic PII Dataset 是一个专为韩语文本中的个人身份信息(PII)检测与令牌分类任务设计的合成数据集。该数据集包含 11,732 个文档,划分为训练集(9,227)、验证集(1,510)和测试集(995),共计 55,627 个 PII 片段,覆盖 33 种 PII 标签(如姓名、电话号码、电子邮件、地址、身份证号等)。数据集提供两种配置:raw 配置保留原始文本和字符级别的 span 标注(起始与结束位置),适合直接查看或自定义处理;bio 配置使用 KPF-BERT 分词器转换为 BIO 序列(包含 input_ids、token_type_ids、attention_mask 和 labels),可直接用于模型训练。所有姓名、号码、地址和句子均为合成生成,不包含真实个人隐私信息。数据质量经过多项增强,包括校验规则(如 Luhn 算法、RRN 校验)、长文档支持(最大 512 令牌)、counterfactual 样本和 hard negative 样本。注意:数据集的 train/validation/test 拆分并非均衡分布,某些稀有标签在测试集中缺失,最终评测使用独立的 holdout 集。该数据集适用于韩语命名实体识别、隐私保护、令牌分类等任务。
Korean Synthetic PII Dataset is a synthetic dataset designed for personal identifiable information (PII) detection and token classification tasks in Korean text. It contains 11,732 documents split into training (9,227), validation (1,510), and test (995) sets, with a total of 55,627 PII spans covering 33 PII labels (e.g., name, phone number, email, address, resident registration number). The dataset offers two configurations: raw (preserving original text and character-level span annotations with start and end positions) and bio (tokenized using KPF-BERT tokenizer into BIO sequences with input_ids, token_type_ids, attention_mask, and labels). All names, numbers, addresses, and sentences are synthetically generated and contain no real personal privacy information. Data quality is enhanced through various checks (Luhn algorithm, RRN validation), long-document support (max 512 tokens), counterfactual samples, and hard negative samples. Note that the train/validation/test split is not balanced, and some rare labels are missing from the test set; final evaluation uses a separate holdout set. The dataset is suitable for Korean named entity recognition, privacy protection, token classification, and other tasks.
数据集概述
Korean Synthetic PII Dataset 是一个用于韩语个人隐私信息(PII)检测与命名实体识别(NER)的合成数据集,专为 token 分类模型训练而设计。数据集中的所有名称、号码、地址及句子均为合成值,不含真实个人信息。
基本构成
| 项目 | 数量 |
|---|---|
| 总文档数 | 11,732 |
| 训练集(Train) | 9,227 |
| 验证集(Validation) | 1,510 |
| 测试集(Test) | 995 |
| PII 片段总数 | 55,627 |
| PII 类型 | 33 |
| BIO 标签数 | 67(含 O) |
| 最大 token 长度 | 511 |
数据集配置
提供了两种可加载的配置(config):
raw:默认配置。包含人读的原文及字符位置 span。bio:包含经 KPF-BERT 分词器转换的 BIO 训练输入。
文件结构
corpus_all.jsonl:三个 split 合并后的原文及 span 数据corpus_all_bio.jsonl:三个 split 合并后的 KPF-BERT BIO 数据data/{train,validation,test}.jsonl:raw 配置的 split 文件bio/{train,validation,test}.jsonl:BIO 配置的 split 文件label_map.json:BIO 标签与整数 ID 的双向映射dataset_stats.json:按 split 及标签的详细统计
注意:合并文件与 split 文件是同一份数据的不同划分方式,而非独立数据。
数据 Schema
Raw 格式 示例字段包括:id、source_text(原句)、privacy_mask(PII 片段列表,含标签、值、起始/结束位置)、language、region、split。位置信息为 0-based 的 Python 字符串索引,满足 source_text[start:end] == value。
BIO 格式 每个样本包含:id、split、input_ids、token_type_ids、attention_mask、labels。其中 labels 为整数化的 B-LABEL/I-LABEL/O 序列,-100 表示损失计算中需排除的位置(如特殊 token)。所有数组长度相等且不超过 512。
PII 标签(共 33 类)
ACCOUNT_NUMBER、ADDRESS、AGE、ALIEN_NUMBER、BIRTHDATE、BLOOD_TYPE、CARD_NUMBER、CITY、DEPARTMENT、DRIVER_LICENSE、EMAIL、EMPLOYEE_ID、GENDER、HEIGHT、IP_ADDRESS、MAJOR、MEMBER_ID、NAME、NATIONALITY、NICKNAME、PARTICIPANT_ID、PASSPORTNUM、PHONE、POSITION、RELIGION、RRN、SCHOOL、URL、USER_ID、VEHICLE_NUMBER、WEIGHT、WORKPLACE、ZIPCODE。
数据质量设计
- 居民身份证号(RRN)生成时保证出生年份与性别代码(
1~4)语义一致。 - 外国人登记号应用性别代码(
5~8)及旧版外国人登记号校验和规则。 - 卡号中包含通过 Luhn 校验的示例。
- 包含表格、列表、CSV、JSON 等无引导语格式,以及多 PII 共现的文档。
- 训练集包含 480 行 RRN/外国人登记号上下文词与真实第 7 位冲突的反事实样本。
- 训练集包含 500 行 RRN 与外国人登记号同现的未标注结构化样本。
- BIO 输入长度扩展至最多 512 token,以支持长文档。
- 训练用 hard negative 包含外表类似 PII 但非目标标签的普通代码上下文。
使用注意
train/validation/test为复现实际模型训练时使用的固定划分,标签分布并非均衡,部分稀疏标签在公开测试集中极少甚至缺失,不宜仅依据测试集评判各类别性能。- 最终模型评估使用了与公开 corpus 在模板和值上均不重叠的独立合成 holdout(每类标签各 100 个正例),该 holdout 未并入公开训练集,以防止调参污染。
已知局限
- 合成句子与实际 RAG 响应、业务文档的表达与分布存在差异。
- 可能存在有限的生成规则或重复表达残留。
- 依赖上下文程度较高的标签(如姓名、昵称、职位、用户 ID)在领域变化时性能可能明显下降。
- 仅凭本数据集或其训练的模型不能保证个人隐私保护效果。