
dattaraj/llm_eval_logic_math
收藏官方服务:
资源简介:
--- dataset_info: features: - name: question dtype: string - name: answer dtype: float64 - name: text dtype: string splits: - name: train num_bytes: 17492 num_examples: 96 download_size: 5521 dataset_size: 17492 configs: - config_name: default data_files: - split: train path: data/train-* ---
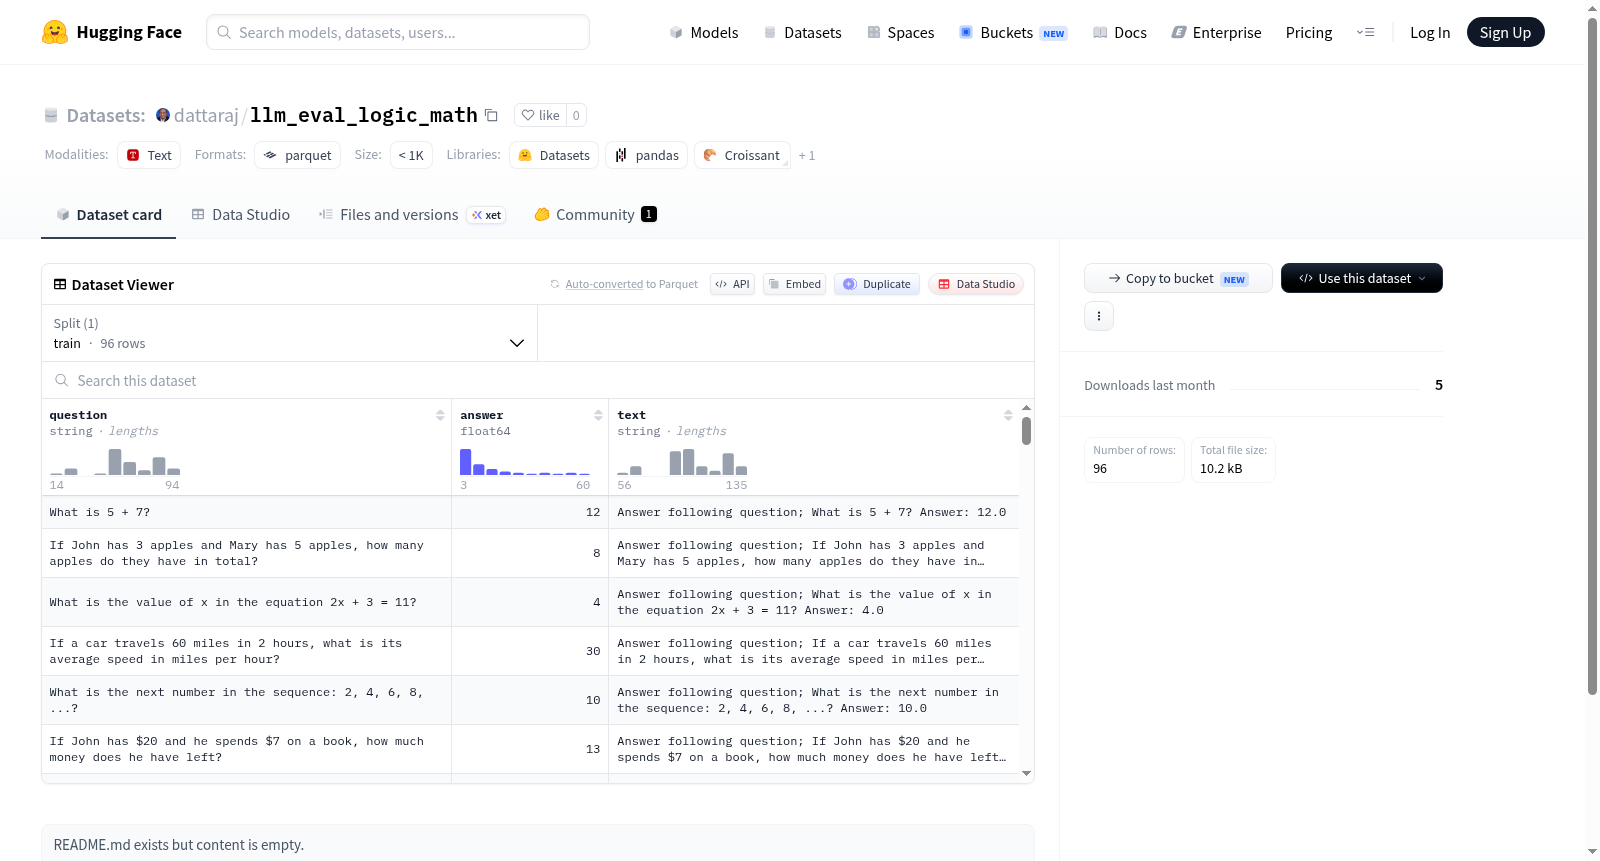
数据集信息: 特征列: - 字段名:question,数据类型:字符串(string) - 字段名:answer,数据类型:64位浮点数(float64) - 字段名:text,数据类型:字符串(string) 数据集划分: - 划分名称:训练集(train),占用字节数:17492,样本数量:96 下载大小:5521 数据集总大小:17492 配置项: - 配置名称:默认配置(default) 数据文件: - 对应划分:训练集(train) 数据路径:data/train-*
提供机构:
dattaraj原始信息汇总
数据集概述
数据集特征
- question:字符串类型
- answer:浮点数类型
- text:字符串类型
数据集划分
- 训练集(train):
- 示例数量:96
- 数据大小:17492字节
数据集大小
- 下载大小:5521字节
- 数据集总大小:17492字节
搜集汇总
数据集介绍
构建方式
在大语言模型推理能力的评估领域,逻辑与数学推理是衡量模型智能水平的关键维度。dattaraj/llm_eval_logic_math数据集专为评估这一能力而构建,其结构简洁而精炼。该数据集包含96个训练样本,每个样本由三个字段组成:question字段存储自然语言形式的问题描述,answer字段以浮点数形式记录标准答案,text字段则可能包含额外的推理上下文或解释。数据以默认配置组织,采用统一的train分割,文件存储于data/train-*路径下,便于直接加载。这种设计旨在提供一组聚焦于逻辑与数学推理的高质量评测样本,以支持对语言模型推理能力的标准化测试。
特点
该数据集的核心特点在于其针对性与精炼性。96个样本规模虽小,却专注于逻辑与数学推理这一特定领域,避免了冗余信息对评估的干扰。每个样本均包含明确的问题与数值型答案,使得模型输出的评估可以基于精确的数值匹配,而非模糊的语义判断。此外,text字段的存在为样本增加了潜在的推理链或上下文信息,有助于分析模型在复杂推理任务中的表现。数据集的轻量化特性使其特别适合快速迭代的模型验证场景,能够在短时间内提供对模型逻辑推理能力的初步洞察。
使用方法
使用该数据集时,研究者可直接通过HuggingFace的datasets库加载默认配置,自动获取train分割中的全部样本。评估流程通常包括:将question字段输入待测语言模型,获取模型生成的回答,随后将其与answer字段中的标准浮点数进行数值比较,以判定推理准确性。对于需要分析推理过程的场景,可利用text字段作为辅助信息,检查模型是否遵循了正确的逻辑链条。由于数据集仅包含训练分割,建议将其作为统一的测试集使用,而无需划分训练与验证集,从而确保评估结果的可比性与可复现性。
背景与挑战
背景概述
随着大语言模型(LLM)在自然语言处理领域的广泛应用,其逻辑推理与数学计算能力成为评估智能水平的关键维度。dattaraj/llm_eval_logic_math数据集由研究者Dattaraj于近期创建,旨在系统性地测试LLM在逻辑与数学任务上的表现。该数据集包含96个精心设计的样本,每个样本由问题描述及其对应的数值答案构成,覆盖了从基础算术到复杂逻辑推理的多种场景。作为评估基准的一部分,它填补了现有数据集在逻辑数学交叉领域的空白,为研究社区提供了一个量化模型推理能力的标准化工具。其影响力体现在推动LLM从单纯的语言理解向结构化思维迈进,尤其对教育科技和自动化推理领域具有参考价值。
当前挑战
该数据集面临的核心挑战在于领域问题的复杂性:逻辑与数学推理要求模型具备符号运算与因果推断能力,而当前LLM常因训练数据的统计偏差导致泛化不足,例如在涉及多步推导或反事实推理时表现脆弱。构建过程中,数据集的规模(仅96个样本)成为显著瓶颈,有限样本难以覆盖逻辑数学问题的多样性,可能引发过拟合或评测偏差。此外,答案以浮点数形式存储,对模型输出精度提出严苛要求,而开放式数学问题中答案的唯一性验证(如近似解与精确解的权衡)进一步增加了评测设计的难度。这些挑战共同制约着数据集作为可靠基准的鲁棒性。
常用场景
经典使用场景
在自然语言处理与逻辑推理交叉的研究领域中,dattaraj/llm_eval_logic_math数据集以其精心设计的96道逻辑与数学问题,成为评估大语言模型推理能力的经典基准。该数据集通过结构化的问答形式,每道题目包含明确的文本描述与精确的数值答案,为研究者提供了量化模型在符号运算、因果推断及多步推理任务上表现的标准化工具。其简洁而富有挑战性的内容设计,使得它特别适用于对比不同模型在基础逻辑与数学推理上的能力差异,成为验证模型泛化性与鲁棒性的重要测试床。
衍生相关工作
基于dattaraj/llm_eval_logic_math数据集,学术界衍生出一系列富有影响力的工作。研究者常将其作为微调或提示工程优化的验证集,例如设计链式思维(Chain-of-Thought)策略以提升模型在数学题上的表现,或开发专门用于逻辑纠错的训练范式。该数据集的发布也催生了更复杂的混合推理基准,如将逻辑推理与常识知识结合的评估套件,以及针对多语言场景的数学问题集。这些衍生工作不仅深化了对模型推理机制的理解,还推动了诸如神经符号学习、自洽性解码等前沿方向的发展,持续塑造着大模型评估领域的演进轨迹。
数据集最近研究
最新研究方向
在大型语言模型的推理能力评估领域,dattaraj/llm_eval_logic_math数据集聚焦于逻辑与数学推理的基准测试,成为衡量模型符号计算与结构化问题求解能力的关键工具。当前前沿研究围绕该数据集展开对链式思维提示、自我一致性采样及神经符号融合方法的探索,旨在突破模型在复杂逻辑链条与多步算术运算中的瓶颈。该数据集与OpenAI o1系列、DeepSeek-R1等模型在数学竞赛题上的表现紧密关联,其96个精心设计的问答实例虽规模精简,却精准映射了语言模型从模式匹配向真正推理跃迁的挑战。该数据集的持续应用不仅推动了推理增强技术的迭代,更在AI可解释性与教育评估场景中彰显了基础逻辑素养对通用人工智能发展的重要奠基作用。
以上内容由遇见数据集搜集并总结生成


