glm5.2-synthetic-mega
收藏资源简介:
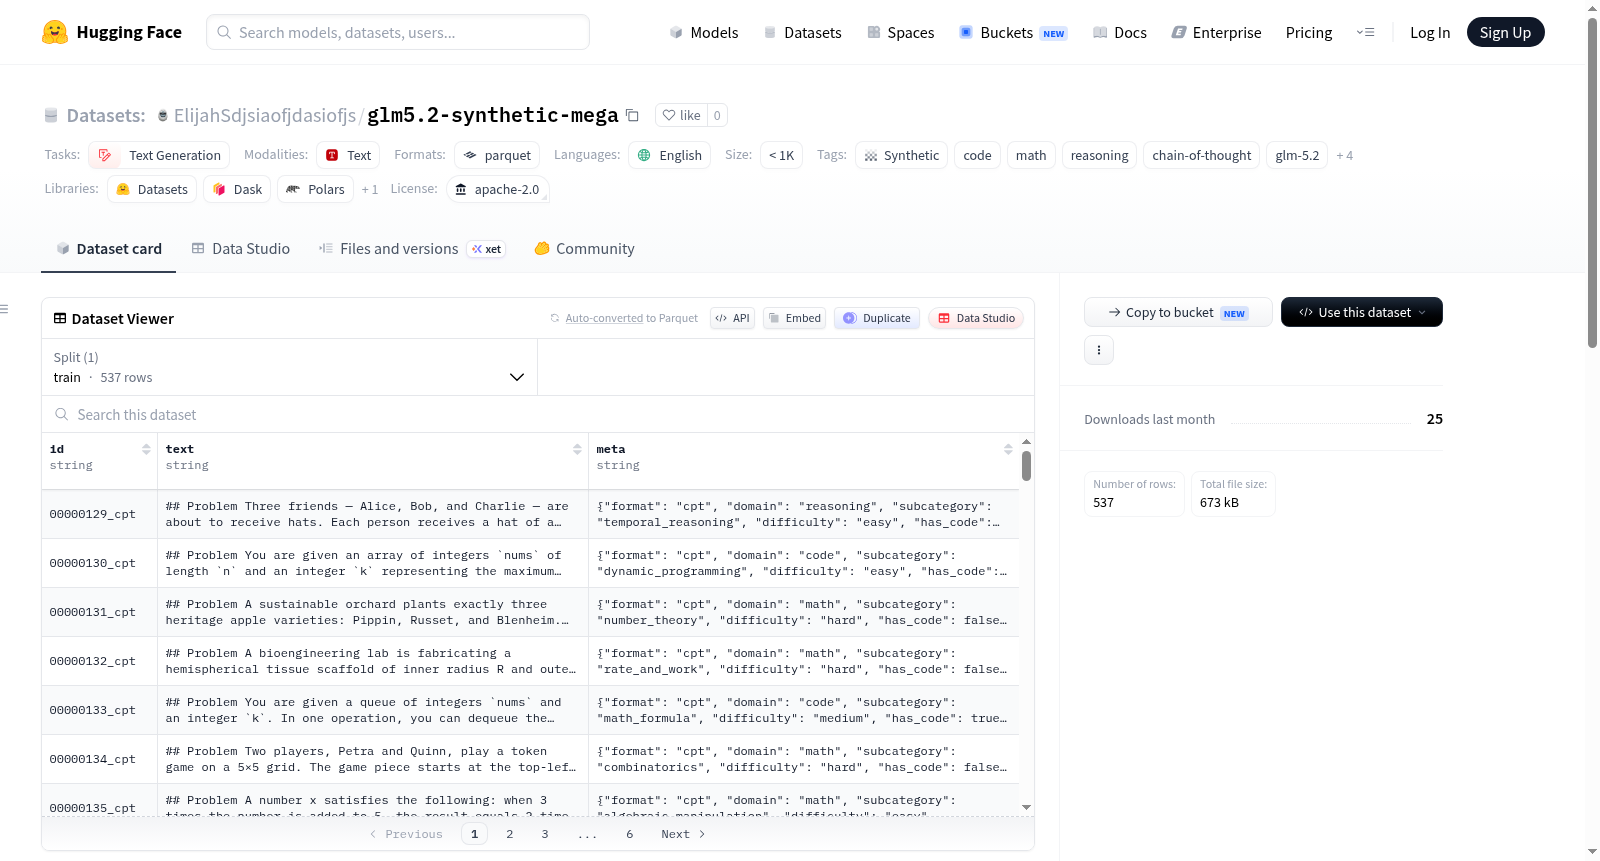
GLM 5.2 Synthetic Dataset (Mega) 是一个由 GLM 5.2 模型生成的合成数据集,专注于数学、代码和推理任务,旨在支持文本生成相关研究与应用。数据集包含 516 条格式记录,源自 129 个经过严格验证的生成单元,每条记录的答案都通过独立确定性验证确保准确性:数学问题使用 sympy 重新推导答案,代码问题通过沙箱执行与属性测试验证,推理问题通过暴力枚举确认唯一解。数据以四种格式提供:继续预训练(CPT)、监督微调(SFT)、指令对话(Instruction)和偏好对(DPO),每种格式包含 129 条记录。内容涵盖三个领域:数学(58 条,涉及代数、数论、几何、组合数学、序列和速率/工作问题)、代码(53 条,涵盖双指针、二分查找、动态规划、贪心算法等算法类型,所有代码均被执行验证)和推理(18 条,包括排序、时序和集合逻辑问题,所有解都经过唯一性检查)。数据集在生成过程中采用分类学驱动的多样性策略,覆盖 7,056 个分类点,并经过 MinHash 近重复过滤,确保样本中无重复;生成尝试的验证通过率约为 32%。该数据集适用于链式思维、代码生成、数学问题求解和推理任务,为模型训练与评估提供高质量、已验证的合成数据。
GLM 5.2 Synthetic Dataset (Mega) is a synthetic dataset generated by the GLM 5.2 model, focusing on mathematical, coding, and reasoning tasks, aimed at supporting text generation-related research and applications. The dataset contains 516 format records derived from 129 rigorously validated generation units, with each records answer ensured for accuracy through independent deterministic verification: mathematical problems use sympy to re-derive answers, coding problems are validated via sandbox execution and property testing, and reasoning problems confirm unique solutions through brute-force enumeration. Data is provided in four formats: Continued Pre-training (CPT), Supervised Fine-tuning (SFT), Instruction Dialogue (Instruction), and Preference Pairs (DPO), each containing 129 records. Content covers three domains: mathematics (58 records, involving algebra, number theory, geometry, combinatorics, sequences, and rate/work problems), coding (53 records, covering algorithm types such as two-pointer, binary search, dynamic programming, greedy algorithms, with all code executed and validated), and reasoning (18 records, including sorting, temporal, and set logic problems, all solutions checked for uniqueness). The dataset employs a taxonomy-driven diversity strategy during generation, covering 7,056 classification points, and undergoes MinHash near-duplicate filtering to ensure no duplicates in samples; the validation pass rate for generation attempts is approximately 32%. This dataset is suitable for chain-of-thought, code generation, mathematical problem-solving, and reasoning tasks, providing high-quality, verified synthetic data for model training and evaluation.
数据集概述:GLM 5.2 Synthetic Dataset (Mega)
基本信息
- 许可证: Apache-2.0
- 语言: 英语 (en)
- 任务类别: 文本生成 (text-generation)
- 数据集大小: 1K < n < 10K 条记录
数据集描述
该数据集由 GLM 5.2 模型(glm-5.2-fp8-pp3,3节点 H20 集群)生成,所有记录均经过确定性验证,确保答案的独立可验证性。
数据集格式与规模
数据集包含四种格式,每种格式包含 129 条记录,总计 516 条格式记录,来源于 129 个经过验证的生成单元:
| 格式 | 路径 | 记录数 |
|---|---|---|
| CPT(持续预训练) | data/cpt/ |
129 |
| SFT(监督微调) | data/sft/ |
129 |
| 指令(对话) | data/instruction/ |
129 |
| DPO(偏好对) | data/dpo/ |
129 |
领域分布
- 数学: 58 条(代数、数论、几何、组合数学、数列、速率/工程问题)
- 代码: 53 条(双指针、二分查找、动态规划、贪心等——全部执行并验证)
- 推理: 18 条(排序、时间、集合逻辑——全部经过唯一性检查)
数据生成与验证
- 模型: GLM 5.2(FP8,3路流水线并行,H20 GPU)
- 生成方式: 模型参与循环,结合分类驱动多样性(7,056 个分类点)
- 验证方式: 100% 答案独立重新推导
- 数学: 使用 sympy 从方程重新推导答案
- 代码: 沙盒执行,针对Oracle + 属性测试(每个17个案例)
- 推理: 暴力枚举确认唯一解
- 去重: 使用 MinHash 近似去重(本样本中无重复)
- 通过率: 约 32% 的生成尝试通过验证