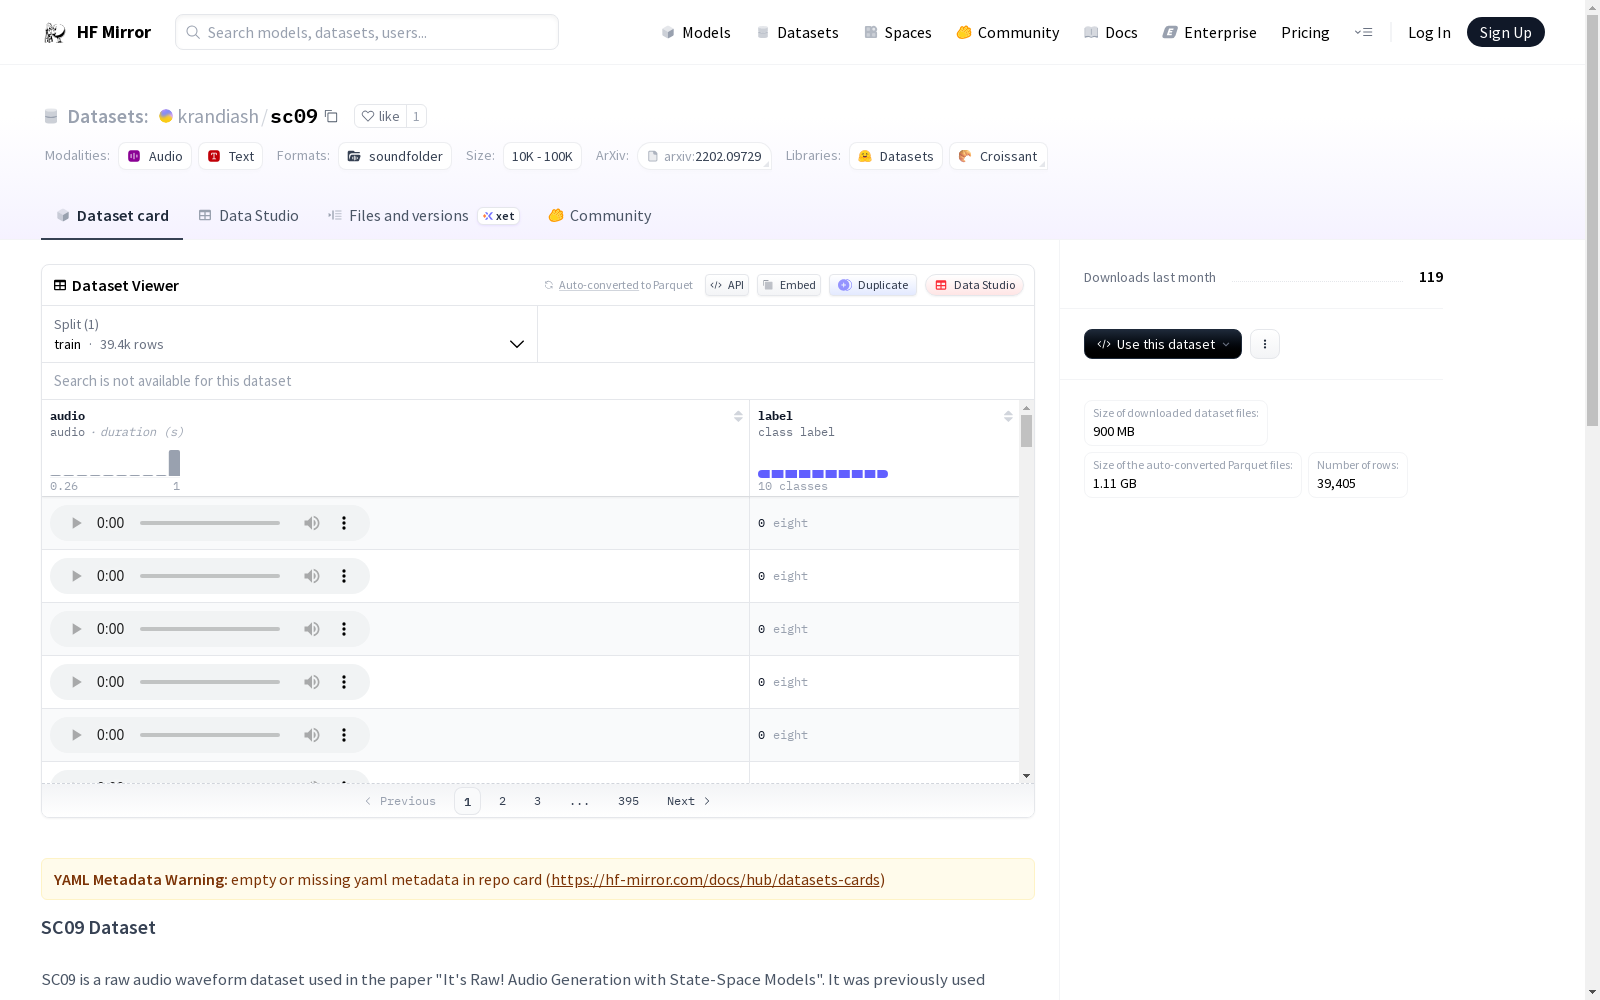
krandiash/sc09
收藏资源简介:
SC09数据集是一个原始音频波形数据集,最初用于关键词识别,后来被用于无条件的音频生成任务。该数据集包含从零到九的数字发音的1秒音频片段,涵盖了多种说话者、口音和噪声条件。数据集分为训练、验证和测试集,并提供了相应的文件列表。此外,还包含一个经过量化的版本,用于模拟自回归模型中的量化噪声。
The SC09 dataset is a raw audio waveform dataset originally intended for keyword recognition, and later repurposed for unconditional audio generation tasks. It contains 1-second audio clips of digit pronunciations from zero to nine, covering diverse speakers, accents and noise conditions. The dataset is split into training, validation and test sets, with corresponding file lists provided. In addition, a quantized version is included to simulate quantization noise in autoregressive models.
SC09 Dataset 概述
数据集描述
SC09 数据集是一个原始音频波形数据集,用于论文 "Its Raw! Audio Generation with State-Space Models"。该数据集包含从零到九的数字发音片段,每个片段时长1秒,涵盖多种发音者和不同的口音及噪声条件。
数据集内容
- 包含从
zero到nine的文件夹,每个文件夹内含16kHz采样率的音频文件,对应每个数字的发音。 validation_list.txt文件,列出了验证集的音频文件。testing_list.txt文件,列出了测试集的音频文件。- 原始的
LICENSE文件。
数据集用途
该数据集被用于训练 SaShiMi 模型和基线模型,数据集的训练、验证和测试集划分遵循 validation_list.txt 和 testing_list.txt 中的规定。
附加数据集
sc09_quantized.zip文件,包含用于 MTurk 研究的示例。这些示例是从每个数字类别中随机选取的50个样本,经过 mu-law 量化和解量化处理,模拟了自回归模型训练过程中遇到的量化噪声。
引用信息
若在研究中使用此数据集,建议使用以下 BibTeX 条目引用相关工作:
@article{goel2022sashimi, title={Its Raw! Audio Generation with State-Space Models}, author={Goel, Karan and Gu, Albert and Donahue, Chris and R{e}, Christopher}, journal={arXiv preprint arXiv:2202.09729}, year={2022} }
@inproceedings{donahue2019adversarial, title={Adversarial Audio Synthesis}, author={Donahue, Chris and McAuley, Julian and Puckette, Miller}, booktitle={International Conference on Learning Representations}, year={2019} }
@article{Warden2018SpeechCA, title={Speech Commands: A Dataset for Limited-Vocabulary Speech Recognition}, author={Pete Warden}, journal={ArXiv}, year={2018}, volume={abs/1804.03209} }