
ckadirt/auramix_5ks
收藏官方服务:
资源简介:
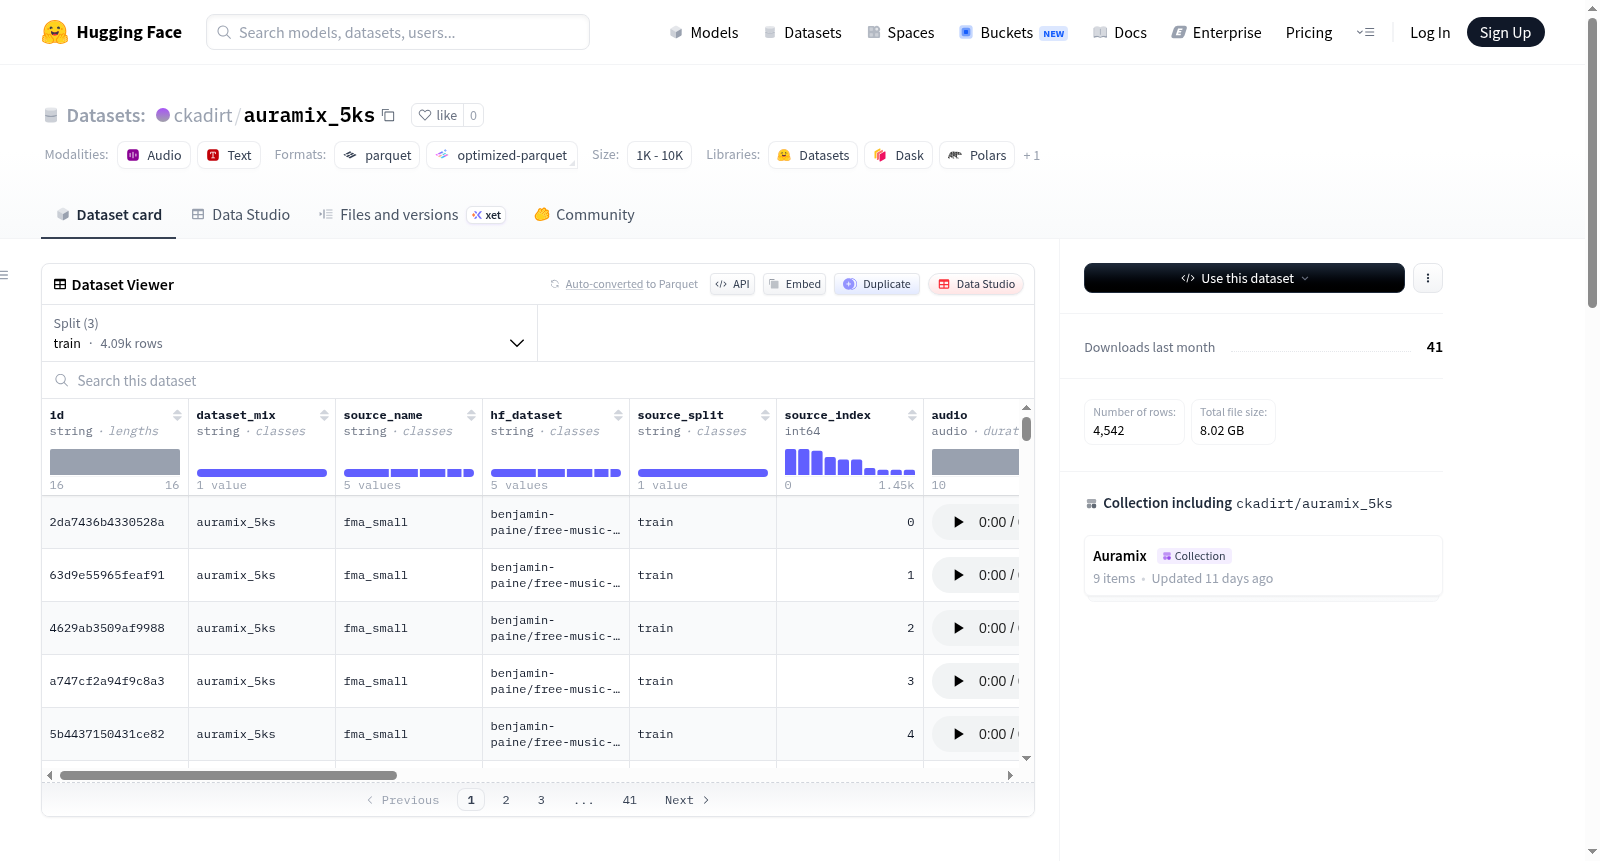
AuraMix是一个小型精选的音频重建/评估混合数据集,由多个Hugging Face音频源生成。数据集包含4542个WAV文件,总大小约为3.73 GB,采样率为44100 Hz,每个音频剪辑时长为10秒,且为单声道。数据来源包括多个公开的音频数据集,如fma_small、fma_commercial_full等。数据集字段包括音频特征、原始路径、来源名称、Hugging Face数据集仓库、来源分割、索引等信息。
AuraMix is a small curated audio reconstruction/evaluation mix generated from multiple Hugging Face audio sources. The dataset contains 4542 WAV files, with an approximate total size of 3.73 GB, a sample rate of 44100 Hz, each audio clip lasting 10.0 seconds, and is mono. The data sources include multiple public audio datasets such as fma_small, fma_commercial_full, etc. The dataset fields include audio features, original paths, source names, Hugging Face dataset repositories, source splits, indices, and other information.
提供机构:
ckadirt搜集汇总
数据集介绍
构建方式
AuraMix_5ks是一个精心策划的音频重建与评估混合数据集,由多个来自Hugging Face平台的音频源汇集而成。其构建过程首先从七个不同来源中提取音频片段,包括fma_small、fma_commercial_full、mtg_l3ac、gtzan、music_genres_small、ai_vs_human_music以及audioset_strong_music,共计4542个片段。每个片段均被裁剪为10秒的固定时长,并统一转换为44.1kHz采样率的单声道PCM_16 WAV格式。最终,所有音频数据及其元信息被嵌入至Parquet文件的一行中,形成紧凑且便于读取的数据结构。
特点
该数据集的核心特点在于其多源融合性与标准化的处理流程。它跨越了从FMA、GTZAN到AudioSet等多个知名音频数据集,覆盖了丰富的音乐与声音类别,为音频重建与评估任务提供了多样化的样本。所有音频片段均经过统一裁剪、重采样及声道转换,确保数据格式的一致性,便于直接应用于模型训练与测试。此外,数据集中每条记录均保留了原始来源、裁剪起始时间等详细元信息,为深入分析音频特征与来源关系提供了有力支撑。
使用方法
使用者可通过Hugging Face Datasets库便捷加载AuraMix_5ks数据集。该数据集预划分为训练集、验证集和测试集,分别对应data/train-*、data/validation-*及data/test-*路径下的Parquet文件。在加载数据时,用户可直接访问包含嵌入WAV字节的audio字段,或通过audio_relpath获取相对路径。对于需要自定义处理的研究者,可通过source_index与source_split字段追溯至原始数据集中的具体样本,从而灵活调整采样策略或进行跨数据集对比分析。
背景与挑战
背景概述
AuraMix_5ks数据集诞生于人工智能音频处理领域对多源、高质量训练数据的迫切需求之际,由研究团队于2023年左右创建,旨在构建一个兼顾多样性与可控性的音频重建与评估混合数据集。该数据集从七个公开的Hugging Face音频源中精心采样4542个10秒长的单声道WAV片段,覆盖了FMA小规模、FMA商业完整版、MTG-L3AC、GTZAN、音乐流派、AI与人类音乐对比以及AudioSet强音乐等丰富类别。其核心研究问题聚焦于如何通过多源融合提升音频重建模型的泛化能力,并为音频质量评估提供标准化的测试基准。AuraMix_5ks的出现填补了现有音频数据集在规模、采样率与元数据完整性方面的空白,对推动音乐信息检索、音频生成与修复等领域的进步具有重要的基础性贡献。
当前挑战
AuraMix_5ks所解决的领域挑战主要源于音频重建与评估任务中数据来源单一、样本长度不一及元数据不统一等问题。该数据集通过跨源固定长度采样策略,有效缓解了模型对特定音频分布过拟合的风险,但构建过程本身亦面临诸多挑战:首先,不同源数据集采样率(如16kHz与44.1kHz)的异构性要求统一的格式转换与质量保障;其次,从时长成百上千秒的原始音频中精准裁剪10秒片段需兼顾语义完整性,避免破坏音乐结构或引入无声段落;再次,源数据集许可证(如FMA的商业与非商业版本)的兼容性审查增加了合规成本;最后,多源元数据字段(如genre、artist等)的异构对齐与JSON编码处理,对数据管道的鲁棒性提出较高要求。
常用场景
经典使用场景
在多模态与音频表征学习的交汇处,auramix_5ks凭借其多元化的音乐与音频片段构成,成为评估与训练音频理解、混合与重建模型的理想基准。该数据集精选自七个代表性的开源音频语料库,涵盖从商业音乐到人工生成音乐等多种体裁与风格,为研究人员提供了一个规模紧凑但类别丰富、质量可控的测试平台。常见的经典使用方式包括:将其作为音频重构模型的输入与参考目标,用于度量编码-解码架构(如自动编码器、变分自编码器)的重建保真度;或是作为多源音频分离与混合任务的验证集,检验模型在应对不同来源、不同风格音频拼接时的泛化能力。其统一的采样率、声道数与时长设定,消除了预处理干扰,使得研究者能够聚焦于算法本质的比较。
实际应用
在实际应用层面,auramix_5ks的构建方式映射了工业界中音频流水线的关键环节,如流媒体服务的音频质量监控、音乐混合软件的自动校准以及智能音箱的多源音频合成。具体而言,该数据集可用于评测音频预处理模块(如标准化、裁剪与重采样)的准确性与效率,这些模块是构建大规模音频索引、语音增强系统或自动化音乐制作工具的基础。其紧凑的规模(约4500条,3.73GB)使其非常适合在边缘设备或实时系统中作为快速原型验证的数据负载,帮助算法工程师在资源受限的条件下权衡重建速度与质量。此外,详细的源归属字段使该数据集能够服务于版权合规性验证,例如检测特定音频片段是否被错误地纳入生成模型的训练集,从而降低法律风险。
衍生相关工作
围绕auramix_5ks构建的评估体系已催生出一系列后续工作,尤其在音频表征学习与生成式模型的规范化评估方面。研究人员借助该数据集开发了基于对比学习的音频重建质量度量指标,这些指标替代了传统且缺乏感知相关性的均方误差,更紧密地与人类听觉判断吻合。此外,数据集的多样化来源促成了跨域迁移学习方法的验证,例如使用在FMA上训练的编码器迁移至GTZAN场景的适应策略。另一条衍生线索涉及数据混合增强技术:研究者基于本数据集的混合方案,探索了动态混合比例与课程学习对音频重建模型收敛速度的影响。值得注意的是,该数据集的开源属性还激励了社区贡献者扩展其子集,生成了加入不同噪音级或压缩伪影的变体版本,进而推动了鲁棒性审计基准的建立。
以上内容由遇见数据集搜集并总结生成


