CASS
收藏资源简介:
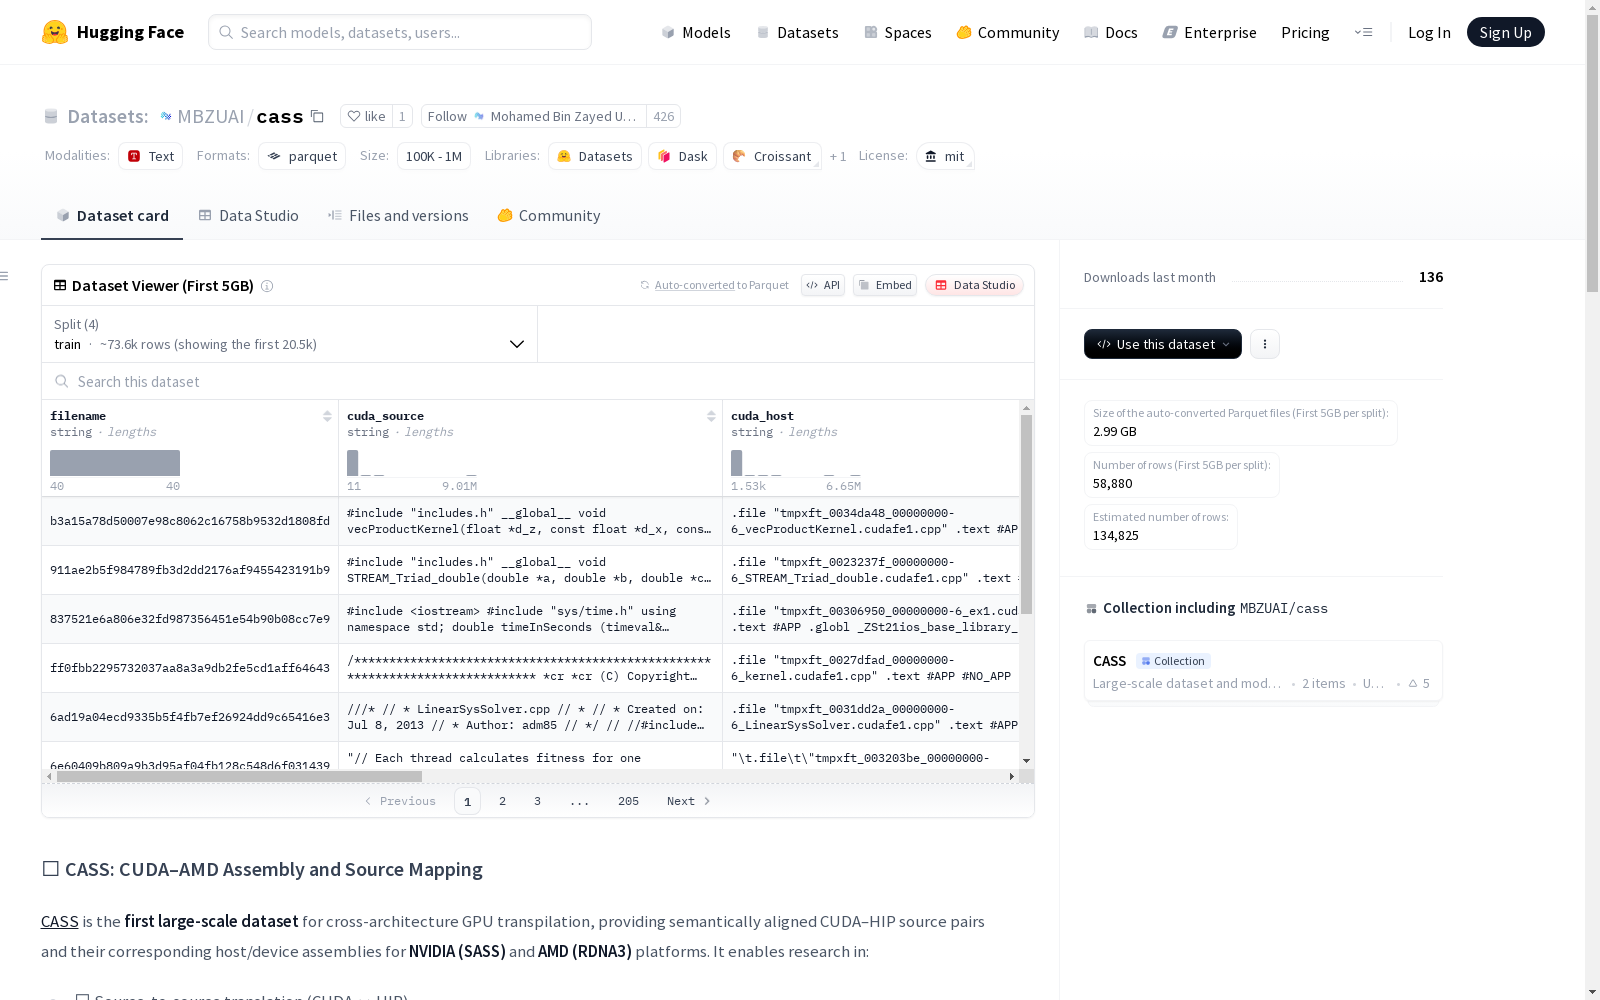
CASS数据集是一个大规模的跨架构GPU代码转换数据集和模型套件,旨在解决源代码级别(CUDA ↔ HIP)和汇编代码级别(Nvidia SASS ↔ AMD RDNA3)的转换问题。数据集包含7万对经过验证的代码,跨越主机和设备,解决了低级别GPU代码可移植性的关键问题。利用这一资源,我们训练了CASS系列的特定领域语言模型,实现了95%的源代码翻译准确率和37.5%的汇编代码翻译准确率,大大超过了商业基线,如GPT-4o、Claude和Hipify。我们生成的代码在超过85%的测试用例中与本地性能相匹配,保持了运行时和内存行为。为了支持严格的评估,我们引入了CASS-Bench,这是一个涵盖16个GPU领域的精心策划的基准测试,包括经过验证的执行。所有数据、模型和评估工具都作为开源发布,以促进GPU编译器工具、二进制兼容性和LLM引导的硬件转换方面的进步。
The CASS dataset is a large-scale cross-architecture GPU code translation dataset and model suite aimed at solving translation issues at the source code level (CUDA ↔ HIP) and assembly code level (Nvidia SASS ↔ AMD RDNA3). The dataset contains 70,000 pairs of validated code spanning host and device code, addressing the critical problem of low-level GPU code portability. Leveraging this resource, we trained the domain-specific CASS-series large language models, achieving 95% source code translation accuracy and 37.5% assembly code translation accuracy, which significantly outperforms commercial baselines such as GPT-4o, Claude and Hipify. The code we generated matches native performance in over 85% of test cases, preserving runtime and memory behavior. To support rigorous evaluation, we introduced CASS-Bench, a curated benchmark covering 16 GPU domains with validated execution. All data, models and evaluation tools are released as open source to promote advancements in GPU compiler tools, binary compatibility and LLM-driven hardware translation.
数据集概述:CASS (CUDA–AMD Assembly and Source Mapping)
基本信息
- 许可证: MIT
- 数据集大小: 36,837,555,212 字节
- 下载大小: 10,789,629,544 字节
- 数据集地址: https://huggingface.co/datasets/MBZUAI/cass
数据集结构
特征字段
| 字段名 | 描述 |
|---|---|
filename |
样本ID或文件名 |
cuda_source |
原始CUDA源代码 |
cuda_host |
从CUDA编译的x86主机端汇编代码 |
cuda_device |
从CUDA编译的SASS (Nvidia GPU)设备汇编代码 |
hip_source |
通过HIPIFY转换的HIP源代码 |
hip_host |
从HIP编译的x86主机端汇编代码 |
hip_device |
从HIP编译的RDNA3 (AMD GPU)设备汇编代码 |
数据分片
| 分片名 | 描述 | 样本数量 | 字节大小 |
|---|---|---|---|
train |
synth、stack和opencl的联合 |
70,694 | 18,979,794,237 |
stack |
从StackV2抓取并过滤的CUDA代码 | 24,170 | 6,087,813,411 |
synth |
LLM合成的CUDA程序 | 40,591 | 11,766,271,412 |
bench |
来自16个GPU领域的40个精选评估任务 | 40 | 3,676,152 |
数据集用途
- 🔁 源到源翻译 (CUDA ↔ HIP)
- ⚙️ 汇编级翻译 (SASS ↔ RDNA3)
- 🧠 LLM引导的GPU代码转换
评估基准
bench分片包含来自16个领域的40个样本,例如:
- 🧪 物理模拟
- 📊 数据结构
- 📸 图像处理
- 🧮 线性代数
所有样本均已手动验证CUDA和HIP之间的语义等价性,并附带可执行的设备/主机二进制文件。
加载方式
python from datasets import load_dataset
加载完整数据集(默认配置包含所有分片)
cass = load_dataset("MBZUAI/cass", name="default")
访问特定分片
train_data = cass["train"] # train = stack + synth + opencl stack_data = cass["stack"] synth_data = cass["synth"] bench_data = cass["bench"]
相关链接
- 🤗 Hugging Face Collection: https://huggingface.co/collections/MBZUAI/cass-6825b5bf7414503cf16f87b2
- 📂 代码与工具: https://github.com/GustavoStahl/CASS