遇见数据集

ai-research-2026

收藏
Hugging Face2026-09-04 更新2026-09-05 收录
官方服务:

资源简介:

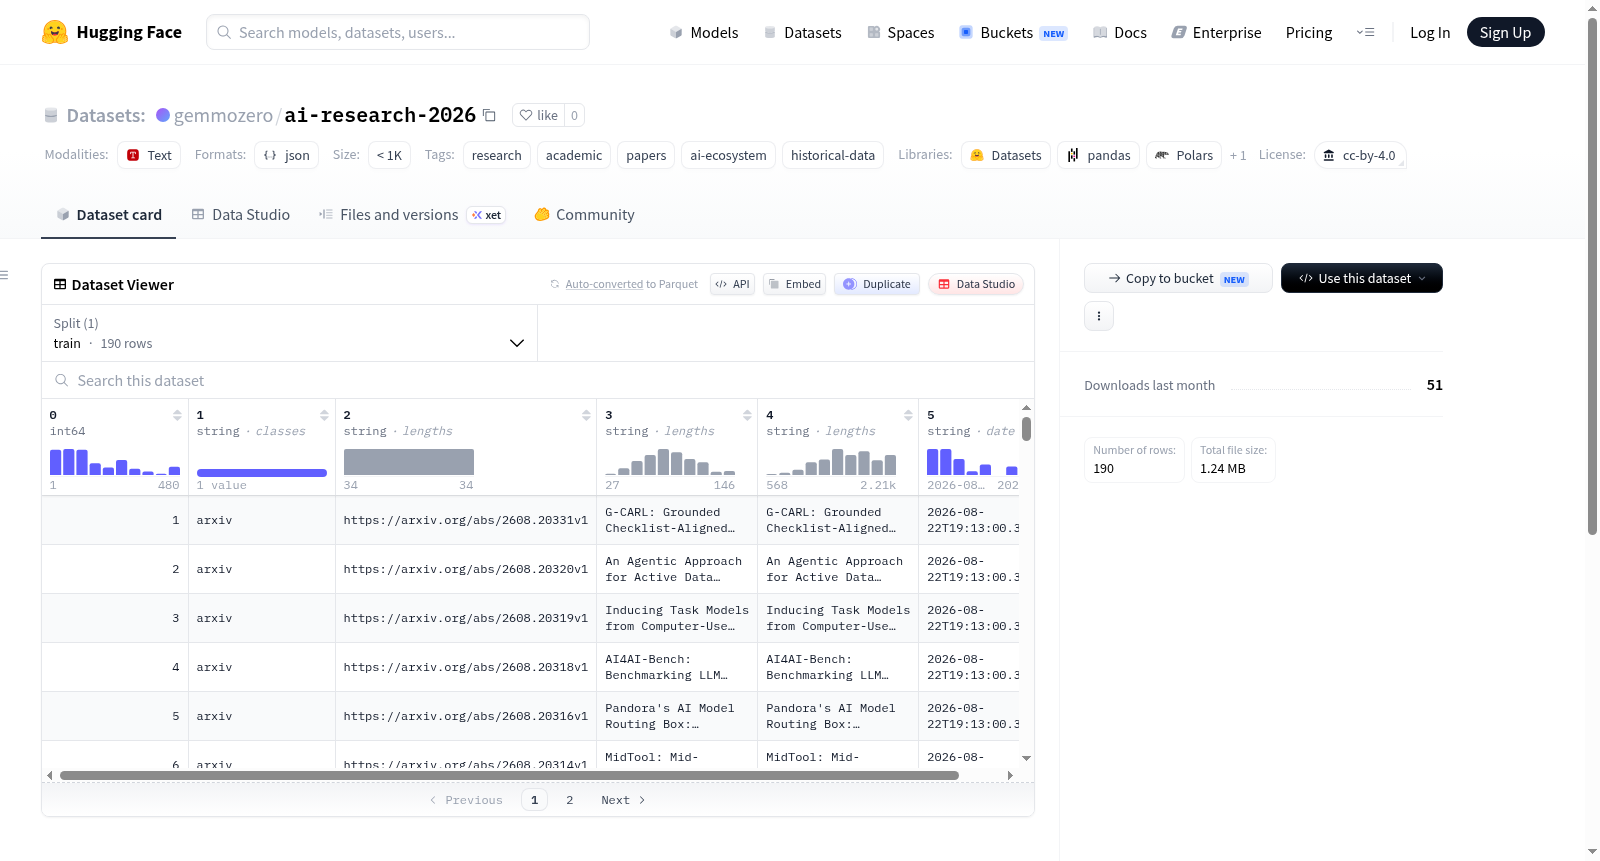
该数据集名为“AI Research Papers 2026”,收录了2026年学术人工智能研究领域的论文和发现。数据每日通过自动化流水线从公共来源(如 HackerNews、RSS 订阅源、API)收集,仅进行最小化处理,保留原始数据。数据集归属于 Legion Data Factory 系列,旨在提供历史 AI 生态系统数据。其规模较小(少于1000个样本),采用 CC BY 4.0 许可协议。适用于 AI 研究趋势分析、学术论文挖掘、生态系统历史回顾等任务。

The dataset named "AI Research Papers 2026" contains papers and discoveries in the field of academic artificial intelligence research in 2026. Data is collected daily via automated pipelines from public sources (e.g., HackerNews, RSS feeds, APIs) with minimal processing, preserving raw data. It belongs to the Legion Data Factory series and aims to provide historical AI ecosystem data. The dataset is small (less than 1000 samples) and licensed under CC BY 4.0. It is suitable for tasks such as AI research trend analysis, academic paper mining, and ecosystem historical review.

创建时间:
2026-08-23
原始信息汇总

AI Research Papers 2026 数据集概述

基本信息

  • 数据集名称: AI Research Papers 2026
  • 许可证: CC BY 4.0
  • 数据规模: n<1K(少于1000条记录)
  • 标签: 研究、学术、论文、AI生态系统、历史数据

内容描述

该数据集收录了2026年学术AI研究领域的论文与研究成果,通过自动化采集管道每日更新,属于Legion Data Factory(AI生态系统历史数据集系列)的组成部分。

数据来源与方法论

  • 数据通过自动化方式采集自公开渠道,包括HackerNews、RSS订阅源及各类API
  • 使用cron任务实现每日自动更新
  • 数据为原始数据,仅经过最小化处理,未进行深度清洗或标注

使用说明

  • 适用场景:AI研究趋势分析、学术论文追踪、生态历史研究等
  • 许可协议:采用CC BY 4.0,使用时需遵循相应署名要求
搜集汇总
数据集介绍
ai-research-2026 数据集图片
构建方式
该数据集通过自动化采集管道,从HackerNews、RSS订阅源及公开API等多元渠道,每日动态汇集全球范围内的学术AI研究论文与相关发现。作为Legion Data Factory项目的一部分,其构建方式强调来源的广泛性与时效性,采用cron作业定时触发更新,确保数据与全球科研前沿保持同步。采集所得的原始数据仅经过最小化处理流程,最大程度保留信息完整性,为研究者提供未经修饰的一手资料,以支持对2026年人工智能领域发展脉络的精准回溯与剖析。
特点
这一数据集的核心特质在于其历史纵深与动态更新并存的属性,聚焦于2026年这一特定时间段,构建出AI生态系统的微观档案。其规模类别为n<1K,虽体量不大,却汇聚了足以反映科研趋势的高密度精粹信息。原始数据的呈现方式放弃了繁复的加工,转而追求内容的纯粹性与客观性,使研究者得以直接洞悉论文标题、摘要等原始样态,从而捕捉研究热点的瞬时演变与学科交叉的潜在脉络,是观察学术动态未曾雕琢的珍贵棱镜。
使用方法
研究人员可通过HuggingFace平台直接访问并下载该数据集,将其应用于文献计量分析、科研趋势预测等场景。其每日更新的机制使得持续追踪特定研究方向或学者动态成为可能,而标准化且宽松的CC BY 4.0许可协议为学术复用或商业转化扫清了障碍。凭借其清晰的时间戳与来源标记,使用者可以便捷地进行时序分析或与外部数据源进行关联比对,验证研究假说,或作为机器学习模型训练与验证的历史知识基底。
背景与挑战
背景概述
在人工智能领域蓬勃发展的当下,学术研究的迭代速度与日俱增,科研文献的时效性成为了驱动技术进步的关键要素。ai-research-2026数据集由Legion Data Factory团队于2026年构建,旨在系统性地捕捉并记录该年度人工智能学术研究的动态图谱。该数据集通过自动化采集管道,每日从HackerNews、RSS订阅源及各类公开API中汇集最新研究论文与学术发现,形成了对AI生态系统历史轨迹的实时快照。作为一项具有前瞻性的基础设施,它不仅为研究者提供了俯瞰年度学术风向的窗口,还通过公开的CC BY 4.0许可促进了跨学科的交融与复用,对追踪AI研究热点变迁、评估领域演进趋势具有重要的参考价值。
当前挑战
该数据集面临的核心挑战可从领域问题与构建过程两个维度剖析。就领域层面而言,AI研究信息呈现爆炸式增长,且来源高度分散,如何在海量、异构的学术资讯中精准识别并筛选出具有学术价值的论文,同时规避冗余与噪声,成为一项亟待攻克的难题。数据集的时效性要求亦对采集系统的稳定性与低延迟提出了严苛考验,需在快速迭代的科研浪潮中保持内容的新鲜度。在构建过程中,依赖公开源进行自动化数据收集,必然遭遇源端API的速率限制、内容格式的无序化以及部分平台的反爬策略,这要求构建方持续调优采集逻辑并平衡多源数据的完整性与一致性。此外,原始数据仅经极简处理,意味着去重、有效性和分类标注等环节存在隐性的质量风险,如何在保留原始风貌与提供可解析结构之间求得平衡,亦是后续维护所需面对的重要课题。
常用场景
经典使用场景
在人工智能研究的前沿领域,及时捕捉学术动态对于把握学科脉络至关重要。ai-research-2026数据集通过自动化管道每日更新,汇集了来自HackerNews、RSS订阅及公开API的学术论文标题与元数据,为研究者提供了一个高时效性的科研索引。该数据集的经典使用场景在于文献计量分析与科研趋势预测,研究者可基于其时间序列数据,追踪特定子领域(如大语言模型、多模态学习)的论文产出速率,识别新兴研究方向,或构建学术影响力网络。此外,其轻量级设计(少于1K条记录)与原始数据形态,使其成为教学演示与算法原型的理想起点,便于快速验证文本挖掘或信息检索技术。
衍生相关工作
该数据集的出现衍生了一系列相关学术探索。一些研究聚焦于数据采集管道的优化,例如如何改进去重算法以提高论文元数据的唯一性,或开发针对学术标题的命名实体识别模型,以自动分类论文所属的子领域(如NLP、CV、RL)。另一些工作则利用此数据集的时间序列特性,构建了科研热点转移的预测模型,其方法被后续研究广泛引用。此外,围绕其公开可用的特性,社区推动了可复现科学伦理的讨论,例如如何在不侵犯版权的前提下共享学术元数据,这类讨论间接促成了数据卡(Data Card)规范的普及。更有甚者,该数据集的轻量特性被用于测试联邦学习框架——多所高校合作在不共享原始数据的前提下,联合训练论文主题分类器,其成果发表后,为私有化分布式科研数据挖掘提供了范例。
数据集最近研究
最新研究方向
该数据集聚焦于2026年度人工智能领域前沿学术成果的自动化追踪与汇聚,其更新机制与构建流程反映了当前科研生态对实时性、全面性与可复现性的迫切需求。依托多源信息采集技术,数据集不仅覆盖了传统论文库,更整合了黑客新闻、RSS及公开API等非传统学术渠道,助力研究者洞察AI技术从理论突破到产业落地的全链条演进。其原始、低处理的数据形态,为算法驱动的文献计量分析、科研趋势预测及跨学科关联挖掘提供了坚实基底,尤其在生成式模型、具身智能及AI安全等热点方向,该数据能有效支撑学者们识别研究爆发点,评估技术成熟度,并预判下一阶段的技术拐点,对构建开放、动态的AI学术版图具有里程碑式的意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务