
遇见数据集

nor_agriculture_bench_with_cohere_model

收藏
Hugging Face2026-07-04 更新2026-07-05 收录
官方服务:

资源简介:

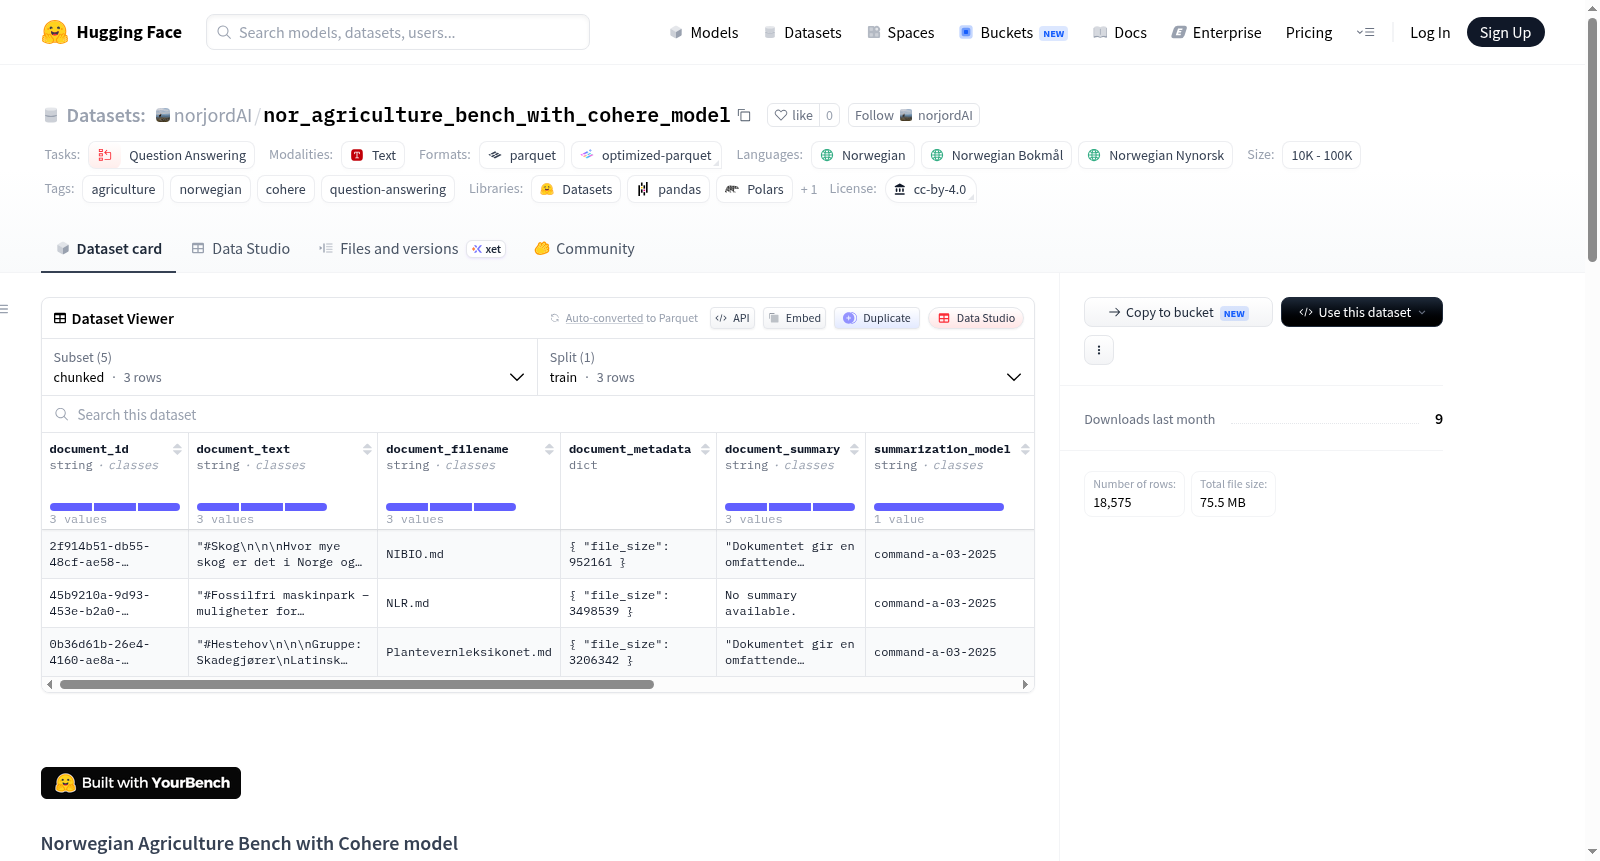
挪威农业基准数据集(含Cohere模型)是一个专为训练和评估大型语言模型在挪威农业领域应用而构建的合成数据集。该数据集源自关于挪威农业管理实践与生产LLM训练的研究论文,旨在使LLM能够用挪威语回答农业相关问题,以辅助农民提高粮食产量。数据集在Cohere Labs研究资助下生成,包含五个主要配置:原始文档(ingested)、摘要文档(summarized)、分块文档(chunked)、单跳问题(single_hop_questions)和多跳问题(multi_hop_questions),反映了从原始文档到最终问答对的数据处理流水线。数据生成流程包括文档摄取、分层摘要、文本分块、单跳/多跳问题生成以及基于重叠的引用评分筛选。数据集适用于问答任务,特别是针对挪威语农业知识的单跳和多跳问答,语言主要为挪威语(包括Bokmål和Nynorsk变体),遵循CC-BY-4.0许可证,数据规模在1万到10万样本之间。

创建时间:
2026-06-20
原始信息汇总

数据集概述

数据集名称: nor_agri_bench_cohere (Norwegian Agriculture Bench with Cohere model)

数据集地址: https://huggingface.co/datasets/norjordAI/nor_agriculture_bench_with_cohere_model

许可协议: cc-by-4.0

语言: 挪威语 (no, nb, nn)

任务类别: 问答 (question-answering)

标签: agriculture, norwegian, cohere, question-answering

数据集规模: 10K < 样本数 < 100K

数据来源与用途

该数据集源自一篇研究论文中收集和描述的数据,专门用于训练大型语言模型,以回答关于挪威农业的问题。其使命是帮助挪威农民提高粮食产量。该合成数据集由 Cohere Labs Research Grant 支持。

数据集配置与特征

该数据集包含5个子配置,每个配置均只有训练集:

1. chunked (分块数据)

  • 训练样本数: 3
  • 数据集大小: 42,177,338 字节
  • 特征:
    • document_id (字符串)
    • document_text (字符串)
    • document_filename (字符串)
    • document_metadata (结构体,包含 file_size)
    • document_summary (字符串)
    • summarization_model (字符串)
    • chunks (列表,包含 chunk_id 和 chunk_text)
    • multihop_chunks (列表,包含 chunk_ids 和 chunks_text)

2. ingested (原始数据)

  • 训练样本数: 3
  • 数据集大小: 7,586,679 字节
  • 特征:
    • document_id (字符串)
    • document_text (字符串)
    • document_filename (字符串)
    • document_metadata (结构体,包含 file_size)

3. multi_hop_questions (多跳问答)

  • 训练样本数: 9,962
  • 数据集大小: 68,401,012 字节
  • 特征:
    • document_id (字符串)
    • question (字符串)
    • self_answer (字符串)
    • generating_model (字符串)
    • raw_response (字符串)
    • citations (字符串列表)
    • source_chunk_ids (字符串列表)

4. single_hop_questions (单跳问答)

  • 训练样本数: 8,604
  • 数据集大小: 35,609,314 字节
  • 特征:
    • document_id (字符串)
    • question (字符串)
    • self_answer (字符串)
    • generating_model (字符串)
    • raw_response (字符串)
    • citations (字符串列表)
    • chunk_id (字符串)

5. summarized (摘要数据)

  • 训练样本数: 3
  • 数据集大小: 7,589,458 字节
  • 特征:
    • document_id (字符串)
    • document_text (字符串)
    • document_filename (字符串)
    • document_metadata (结构体,包含 file_size)
    • document_summary (字符串)
    • summarization_model (字符串)

数据处理流水线

该数据集通过以下流水线步骤生成:

  1. ingestion (数据导入): 读取原始源文档,转换为标准化 Markdown 格式
  2. summarization (摘要生成): 执行层级摘要,先进行分块级 LLM 摘要,再进行合并缩减
  3. chunking (分块): 将文本分割成基于 token 的单跳和多跳块
  4. single_hop_question_generation (单跳问答生成): 为每个块生成独立的问答对
  5. multi_hop_question_generation (多跳问答生成): 生成需要跨多个块推理的多跳问答对
  6. citation_score_filtering (引用分数过滤): 计算基于重叠的引用分数并过滤问答对

可复现性

该数据集可使用 YourBench v0.9.0 工具,配合指定的配置文件和 Cohere 模型 (command-a-03-2025) 进行复现。
搜集汇总
数据集介绍
nor_agriculture_bench_with_cohere_model 数据集图片
构建方式
该数据集基于挪威农业领域的原始文献构建,首先将源文档统一转化为归一化的Markdown格式以完成数据摄取,随后通过层级摘要技术生成文档的精炼总结。接着,将文本按token边界切分为单跳与多跳两种类型的文本块,其中多跳块旨在覆盖多个相关联的片段。分别利用语言模型为单跳块与多跳块生成独立的问答对,最后通过计算引用重叠分数对生成的问答对进行筛选,确保答案与原文的高度相关性。整个流程依托Cohere模型驱动,并遵循了严格的流水线化步骤。
特点
该数据集聚焦于挪威农业领域的问答任务,具有显著的领域专精性与语言特色。数据集不仅包含了从原始文献到摘要、再到文本块的多层级处理结果,还精心设计了单跳与多跳两种问题类型,使模型能够学习从单一片段推理与跨片段综合推理两种能力。所有问题均由Cohere模型自动生成并经过引用评分过滤,保证了合成数据的质量。此外,数据集标注清晰,涵盖文档元数据、摘要模型信息及引用来源,为深入分析提供了丰富维度。
使用方法
用户可通过HuggingFace Datasets库加载该数据集,支持按配置名访问不同处理阶段的数据子集,包括chunked、ingested、single_hop_questions、multi_hop_questions及summarized等。例如,加载单跳问题子集可使用load_dataset('nor_agriculture_bench_with_cohere_model', 'single_hop_questions')。数据集默认划分为训练集,适用于微调挪威语农业问答模型。其结构化字段如document_text、chunk_text、question及citations可直接用于构建训练样本或评估基准,便于集成至检索增强生成或纯生成式问答流水线中。
背景与挑战
背景概述
随着大型语言模型在农业领域的应用日益广泛,挪威语农业知识的智能化处理成为亟待突破的方向。该数据集由研究团队基于2025年发表在《Data in Brief》上的相关工作创建,旨在为挪威农业管理实践与生产任务构建专业的语言模型训练资源。依托Cohere实验室研究资助,数据集通过流水线式合成方法生成,包含文档分块、摘要、单跳与多跳问答等子集,覆盖挪威语(包括书面挪威语和新挪威语)农业场景。其核心研究问题在于如何使语言模型准确理解并回答挪威农业领域的复杂问题,从而辅助农场主提升生产效率。该数据集以CC-BY-4.0许可发布,规模在1万至10万条之间,为低资源语言农业领域的自然语言处理研究提供了重要基础。
当前挑战
该数据集面临的首要挑战源于农业领域问题的复杂性:农业生产涵盖作物管理、土壤科学、气象预测等多元知识,要求模型具备跨段落推理与多跳问答的能力,而传统单跳问答范式难以应对这类精细需求。构建过程中,技术难点主要体现为合成数据质量的控制:从原始文档的归一化处理、层级式摘要的语义保真度,到基于token的分块策略与问答对的自动生成,每个环节均需平衡计算效率与数据准确性。此外,挪威语作为低资源语言,现有语言模型的基础能力薄弱,导致引用得分过滤等后处理步骤面临基准缺失的困境,进一步增加了高质量数据生产的门槛。
常用场景
经典使用场景
在自然语言处理与精准农业的交叉领域中,nor_agriculture_bench_with_cohere_model数据集被广泛用于评估和微调大型语言模型在挪威语农业问答任务上的表现。其经典使用场景涉及单跳与多跳问答(single-hop and multi-hop question answering),模型需从分块后的农业文档中提取信息,回答关于作物管理、土壤特性、病虫害防治等专业知识的问题。数据集通过结构化的文本分块(chunking)和引用评分过滤(citation_score_filtering)机制,为研究者提供了高质量、细粒度的训练与评测基准,尤其适合验证模型在低资源语言(挪威语)和特定领域(农业)上的推理与检索能力。
解决学术问题
该数据集有效回应了农业信息化进程中语言模型领域适配不足的学术困境。传统通用模型在处理挪威语农业文本时,常因术语稀疏、多跳推理复杂而表现欠佳。nor_agriculture_bench_with_cohere_model通过提供经过分块、摘要与问题生成流水线处理的合成数据,解决了少样本场景下领域问答数据匮乏的核心难题。其多跳问题子集(multi_hop_questions)特别针对跨段落信息整合的需求,推动了模型在因果关系理解、空间知识关联等方面的能力评测。这一工作为低资源语言的专业化NLP研究树立了可复现的基准,并强调了知识密集型农业场景中推理链路完整性的重要价值。
衍生相关工作
围绕该数据集已衍生出一系列核心研究工作,包括利用Cohere命令模型(command-a-03-2025)进行层次化摘要与问题生成的流水线框架YourBench。相关论文系统性地介绍了从原始挪威语农业文献到合成问答对的完整构建方法,并探讨了引用评分过滤对答案质量的影响。后续工作进一步将此基准应用于跨语言迁移学习,对比了多语言模型与专门微调模型在农业领域上的性能差异。此外,有研究基于该数据集分析了分块策略(token overlap与max tokens)对多跳推理准确率的敏感性,为优化文档检索增强生成(RAG)系统提供了实验依据。这些工作共同丰富了低资源农业NLP的技术生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


