
VerboVision/dados_sinteticos_metodologia_bert_apenas
收藏官方服务:
资源简介:
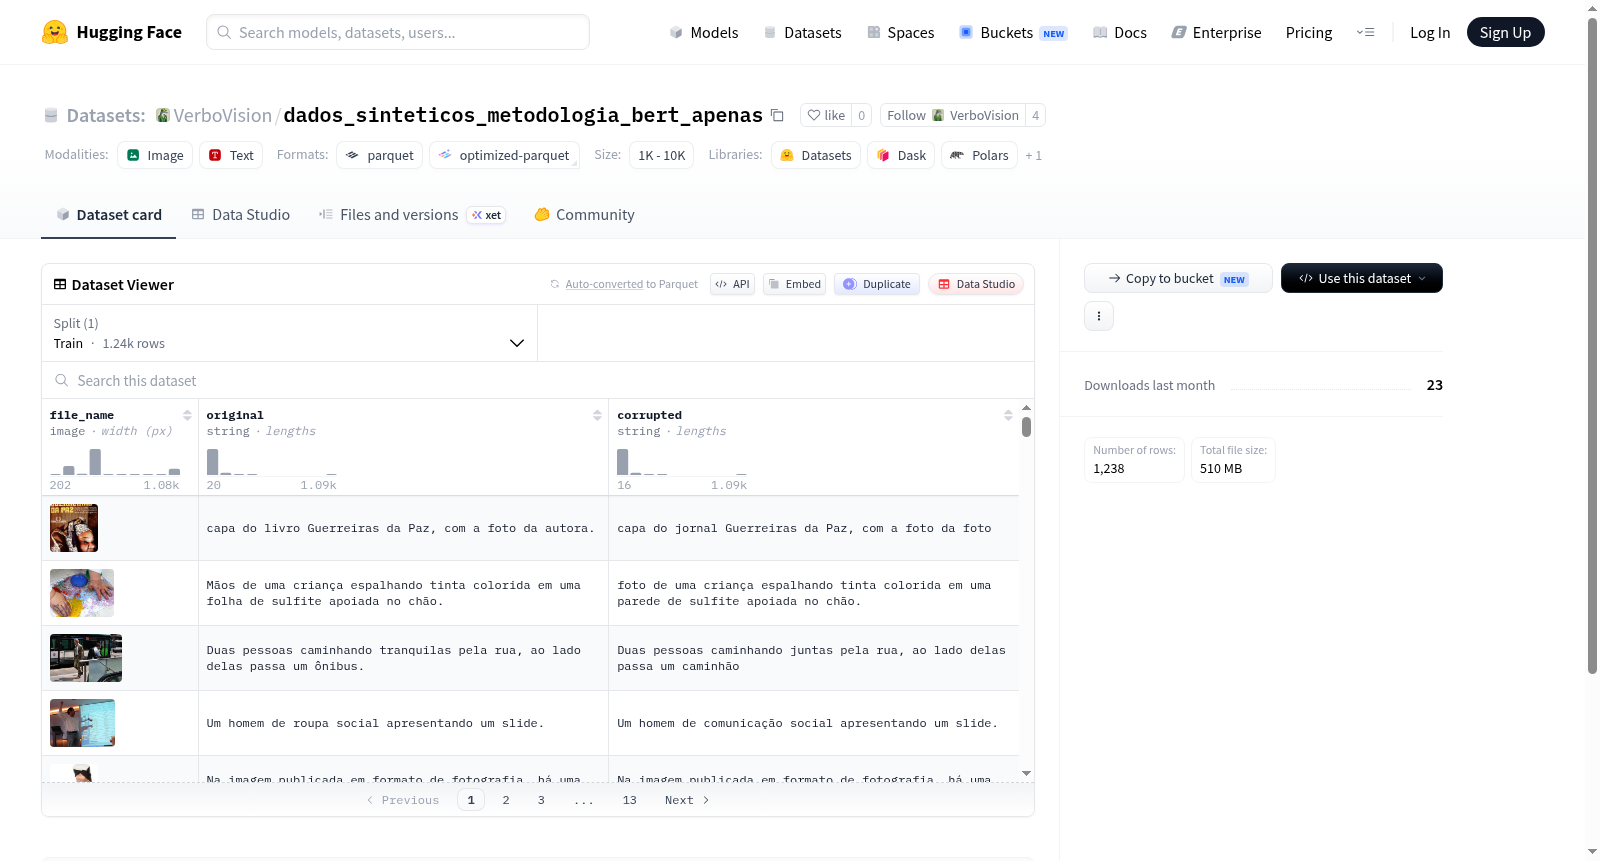
该数据集是一个包含图像和文本对的数据集,主要用于训练任务。它包含1238个训练样本,每个样本包括一个图像文件(通过file_name字段标识)、一个原始字符串(original字段)和一个损坏字符串(corrupted字段)。数据集总大小约为509MB,下载大小类似,适用于自然语言处理或图像文本相关的研究,可能涉及文本修复、对比学习或数据增强等应用。
This dataset is a collection of image and text pairs designed for training purposes. It consists of 1,238 training examples, each containing an image file (identified by the file_name field), an original string (original field), and a corrupted string (corrupted field). The total dataset size is approximately 509MB, with a similar download size, making it suitable for research in natural language processing or image-text applications, such as text restoration, contrastive learning, or data augmentation.
提供机构:
VerboVision搜集汇总
数据集介绍
构建方式
该数据集名为“dados_sinteticos_metodologia_bert_apenas”,专为基于BERT的文本纠错任务而构建。其构建方式采用合成数据生成策略,通过模拟真实场景中的文本损坏模式,对原始文本进行人为扰动,生成对应的错误文本(corrupted)。数据集共包含1238个样本,每个样本由三部分组成:图像格式的文件名(file_name)、原始正确文本(original)以及经过损坏处理的文本(corrupted)。所有样本均划分至训练集(Train),数据总量约509.6MB,确保了模型在训练阶段拥有充足的样本多样性。
使用方法
使用该数据集时,开发者可直接加载HuggingFace的datasets库,通过指定配置名“default”读取训练集。数据加载后,可使用“original”和“corrupted”字段构建序列到序列的学习任务,如BERT的掩码语言模型或文本纠错模型。由于数据集中不包含预定义的验证集,建议用户自行划分80%样本用于训练、20%用于验证,以避免过拟合。此外,图像字段可扩展为视觉特征输入,用于联合建模文本与图像的纠错任务。
背景与挑战
背景概述
该数据集dados_sinteticos_metodologia_bert_apenas由研究机构创建,旨在探索基于BERT模型的合成数据生成方法。发布于自然语言处理与图像处理交叉领域,核心研究问题在于如何利用预训练语言模型BERT生成高质量合成图像数据,以弥补真实标注数据的稀缺性。该数据集包含1238个训练样本,每项由图像文件、原始文本与损坏文本构成,为评估BERT在数据增强与纠错任务中的性能提供了基准。它的出现推动了合成数据在低资源场景下的应用,对多模态学习与数据驱动方法的发展具有潜在影响力。
当前挑战
该数据集主要解决的领域问题包括图像数据标注成本高、真实数据获取困难以及噪声数据对模型训练的干扰,利用BERT生成合成数据以缓解数据稀疏性挑战。在构建过程中,面临的挑战涵盖:如何确保合成图像与原始文本语义的一致性,防止生成数据偏离真实分布;处理原始文本与损坏文本之间的复杂映射关系,避免引入系统偏差;以及在小规模样本(仅1238例)下维持数据多样性,防止过拟合。此外,模型对噪声数据的鲁棒性评估也是关键难点,需设计有效的验证策略来保障合成数据的实用性。
常用场景
经典使用场景
该数据集专为训练基于BERT架构的文本纠错模型而设计,其核心用途在于通过合成数据模拟真实场景中的文本错误模式,助力模型学习从受损文本中恢复原始、正确的表达。数据集包含1238个训练样本,每个样本由原始图像文件名称、干净文本以及人为引入噪声的损坏文本三部分组成,为序列到序列的文本修复任务提供了标准化的训练与评估基线。研究者可借此探索不同噪声类型对模型性能的影响,并优化预训练语言模型在文本恢复任务上的泛化能力。
解决学术问题
该数据集有效回应了自然语言处理领域中低资源文本纠错任务的数据稀缺问题。通过提供系统化构建的合成错误语料,它帮助学者们摆脱对人工标注庞大错误语料库的依赖,从而能够专注于评估和对比各类基于Transformer的纠错模型性能。其意义在于推动了对BERT等预训练模型在文本复原任务上内在机制的深入理解,并促进了非自回归与自回归生成方法在处理字符级与词汇级拼写错误时的鲁棒性研究。
实际应用
在实际应用中,该数据集训练的文本纠错模型可直接部署于光学字符识别(OCR)后处理流程,有效修正因图像模糊、字体变形或扫描误差导致的文本失真。同时,它也在输入法自动校正、社交媒体文本清洗、以及语音助手转录文本的后处理环节发挥关键作用,显著提升下游任务如信息检索、情感分析及自动摘要的数据质量。通过合成数据生成的模型,因其对噪声模式的覆盖性,在跨领域、跨语言的场景中展现出良好的迁移潜力。
数据集最近研究
最新研究方向
针对葡萄牙语法律文档的光学字符识别(OCR)校正任务,该数据集通过BERT方法论合成图像级噪声与文本错误配对样本,支撑训练鲁棒的端到端后处理模型。近期研究聚焦于利用此类合成数据提升低资源场景下(如司法卷宗)OCR系统的抗干扰能力,并探索结合对抗训练与预训练语言模型的纠错范式。其意义在于规避真实标注高成本,推动法律数字化中从‘字符级修正’向‘语义级复原’的转型,同时为跨语种文档清洗提供可迁移的合成数据生成范式。
以上内容由遇见数据集搜集并总结生成


