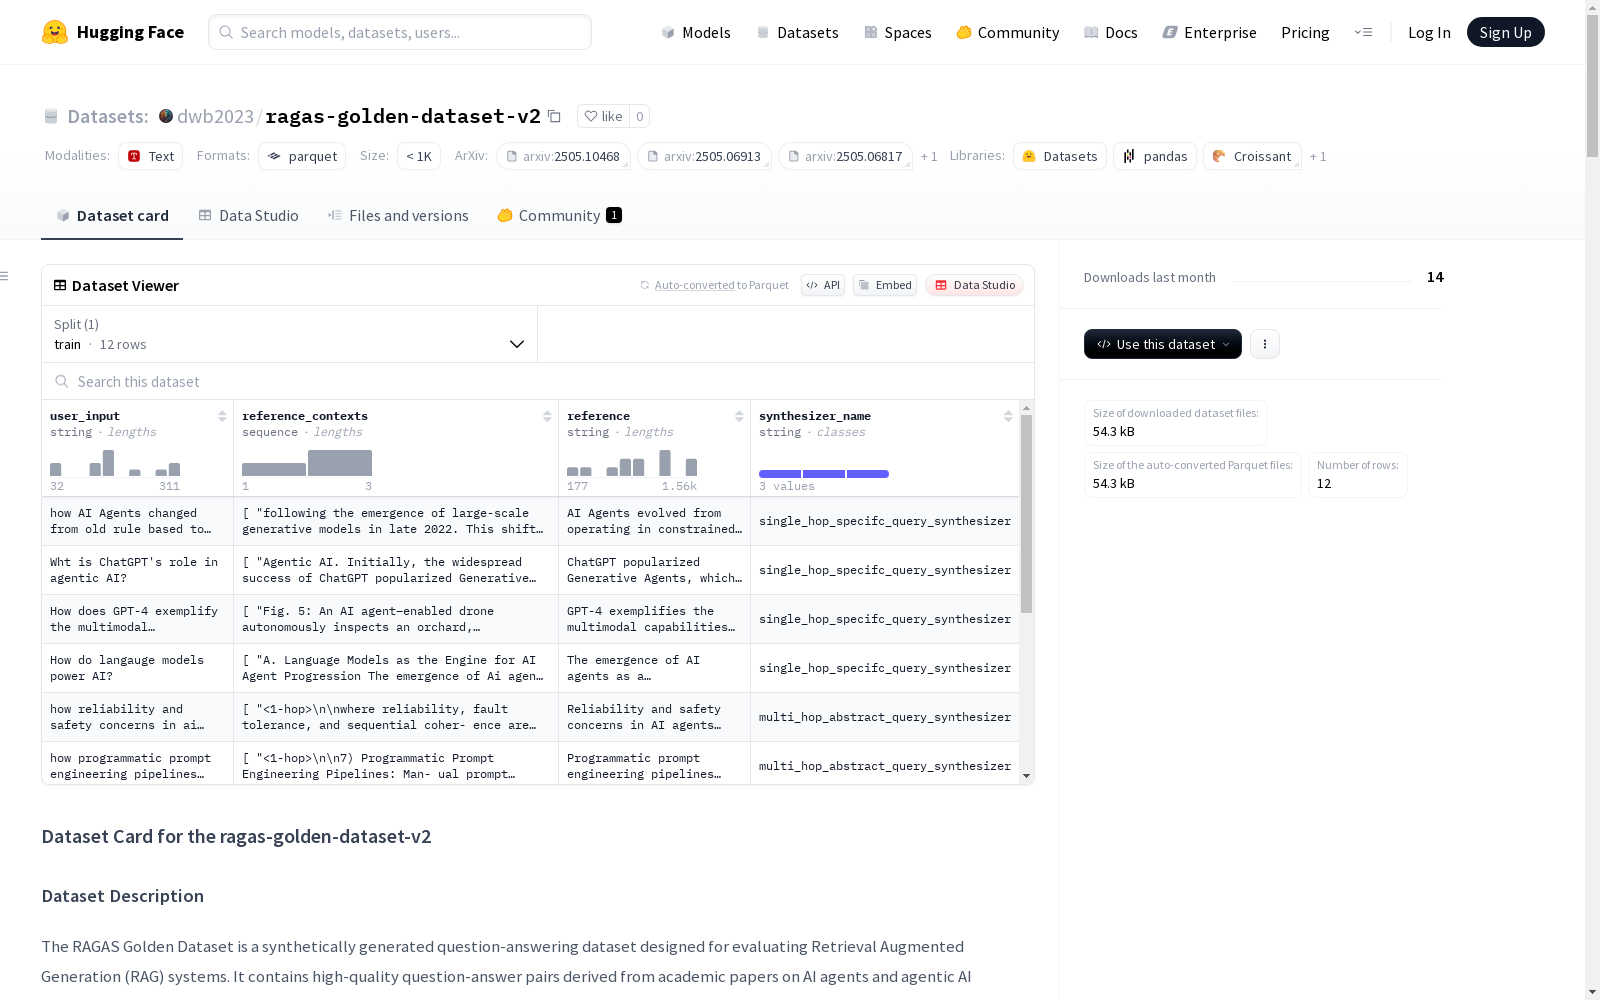
ragas-golden-dataset-v2
收藏资源简介:
RAGAS黄金数据集是一个合成的问答数据集,用于评估检索增强生成(Retrieval Augmented Generation, RAG)系统。它包含了从人工智能代理和代理性AI架构的学术文章中提取的高质量问答对。该数据集通过Prefect和RAGAS测试集生成器框架生成,能够创建基于输入文档的复杂、上下文丰富的评价数据。数据集包括不同复杂度的合成问题、源自源文档的地面真实答案、应检索的上下文信息以及问题和上下文的嵌入向量。
RAGAS Gold Dataset is a synthetic question-answering dataset designed for evaluating Retrieval Augmented Generation (RAG) systems. It contains high-quality question-answer pairs extracted from academic articles on AI agents and agentic AI architectures. This dataset is generated via the Prefect and RAGAS test set generator frameworks, which can create complex, context-rich evaluation data based on input documents. The dataset includes synthetic questions of varying complexity, ground-truth answers derived from source documents, context information that should be retrieved, as well as embedding vectors for both the questions and the context.
数据集概述:ragas-golden-dataset-v2
数据集描述
RAGAS Golden Dataset是一个用于评估检索增强生成(RAG)系统的合成生成问答数据集。包含基于AI代理和代理AI架构学术论文生成的高质量问答对。
数据集摘要
- 生成工具:使用Prefect和RAGAS TestsetGenerator框架生成
- 生成方法:基于输入文档构建内部知识图谱,创建复杂且上下文丰富的评估数据
- 目的:支持RAG系统的无参考评估(包括检索效果、生成保真度和上下文相关性)
- 包含内容:
- 不同复杂度的合成生成问题
- 源自文档的真实答案
- 应检索的上下文信息
- 问题和上下文的嵌入向量
数据集结构
- 字段组成:
user_input:生成的问题文本(字符串)reference_contexts:应检索的相关文档上下文(字符串序列)reference:真实答案(字符串)synthesizer_name:问题生成器名称(字符串)
- 数据量:
- 训练集:12个样本
- 总大小:80,518字节
- 下载大小:54,324字节
支持任务
- RAG系统性能评估
- 问答能力基准测试
- 检索效果测试
- 生成保真度和忠实度评估
数据集创建
数据来源
- 三篇arXiv学术论文:
生成过程
- 使用LangChain的PyPDFDirectoryLoader提取文本内容
- 通过RAGAS TestsetGenerator构建知识图谱
- 基于知识图谱生成多样化问题类型(单跳/多跳、具体/抽象等)
- 识别每个问题的相关上下文
- 从上下文中创建真实答案
使用注意事项
局限性
- 领域局限:专注于AI代理相关学术内容
- 问题分布:合成生成可能无法反映真实用户查询模式
- 规模限制:仅包含12个样本
- 潜在偏见:继承源文档和LLM生成过程的偏见
社会影响
- 促进开发更准确可靠的RAG系统
- 通过高质量评估数据提升AI应用的事实准确性
附加信息
许可
- MIT License
引用信息
bibtex @misc{dwb2023_ragas_golden_dataset, author = {dwb2023}, title = {RAGAS Golden Dataset}, year = {2023}, publisher = {Hugging Face}, howpublished = {https://huggingface.co/datasets/dwb2023/ragas-golden-dataset} }
相关论文引用
包含RAGAS框架论文和三篇源论文的引用信息(详见原始文档)