
cvstreets/gta-data-files-universal
收藏搜集汇总
数据集介绍
构建方式
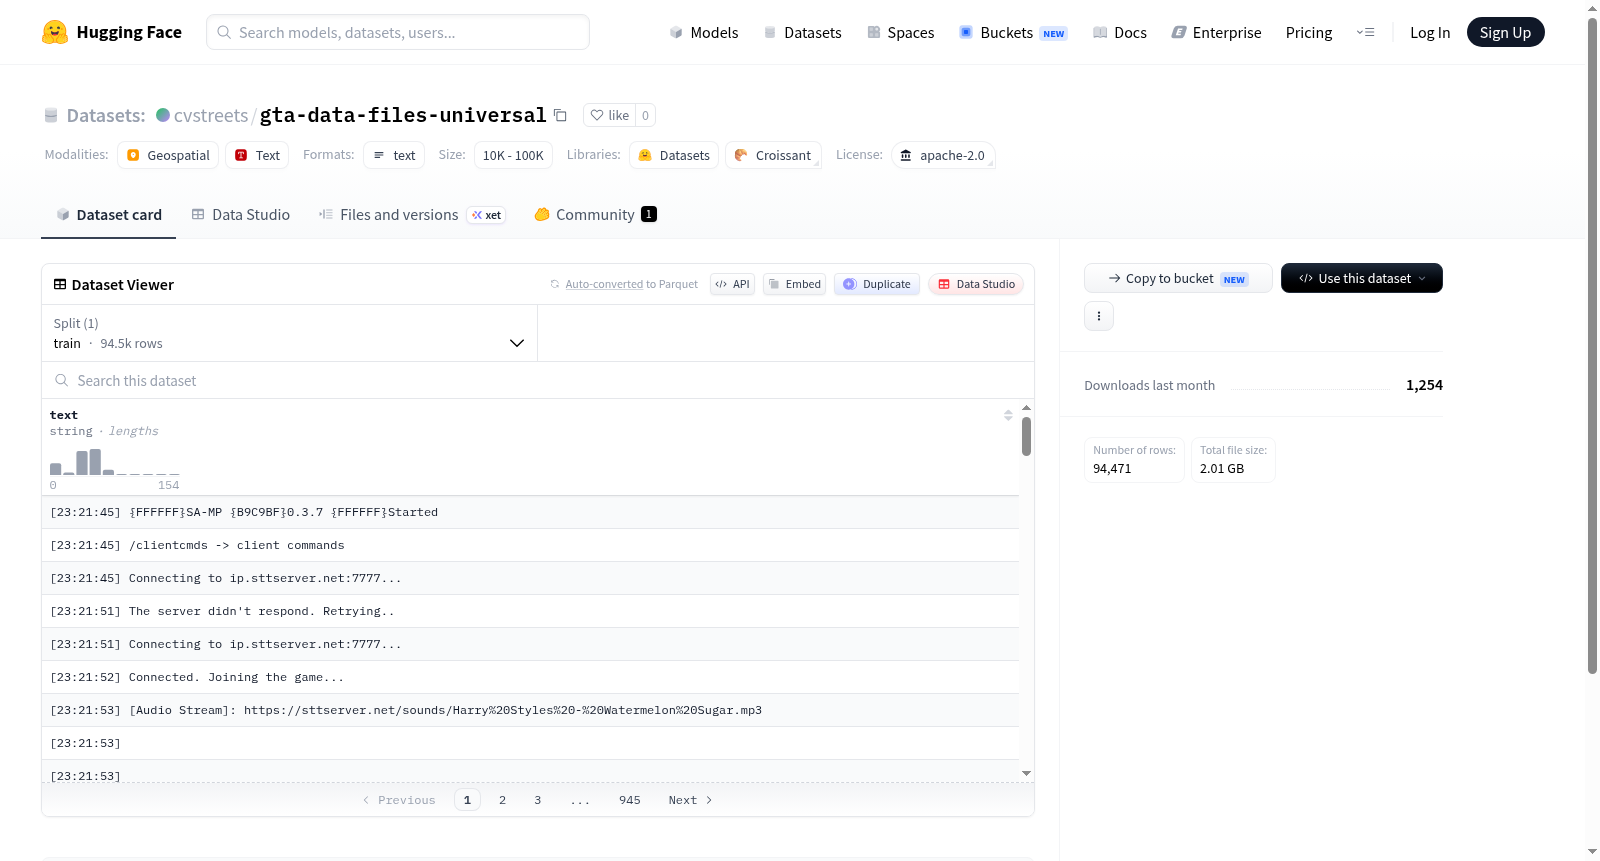
该数据集名为gta-data-files-universal,其构建基于开放共享的理念,采用Apache-2.0许可证,允许广泛的使用、修改与分发。数据集的内容源自与GTA(侠盗猎车手)系列游戏相关的通用数据文件,涵盖游戏资源、配置文件及脚本等多种类型,通过标准化格式进行整合与存储,以支持跨版本或跨平台的游戏数据复用与分析。
特点
数据集以通用性为核心特点,不限定于特定GTA游戏版本或平台,具备高度的兼容性与可扩展性。其文件结构遵循标准规范,便于开发者和研究人员快速接入使用。Apache-2.0许可证进一步降低了使用门槛,促进了学术研究、模组制作及游戏开发等领域的协作创新。
使用方法
使用时,用户可直接从HuggingFace数据集页面下载该数据集,或通过相关API加载文件内容。适用于游戏数据分析、模组开发、资源提取与逆向工程等场景。建议结合Python脚本或工具库进行文件处理,确保在遵循Apache-2.0许可证条款的前提下自由探索与利用数据。
背景与挑战
背景概述
大型语言模型在生成具有复杂结构的数据文件方面展现出巨大潜力,然而现有数据集多聚焦于自然语言或代码,缺乏直接针对通用数据文件格式(如JSON、CSV、XML等)生成任务的专业资源。此数据集由相关领域研究机构创建,旨在系统性地提供多样化、结构化数据文件样例,以支持模型学习数据文件的句法规则与逻辑模式。通过覆盖多种行业场景与文件结构,该数据集为开展数据文件自动生成、格式转换与解析等技术的研究奠定了坚实基础,在推动结构化数据处理与模型应用方面具有重要价值。
当前挑战
该数据集主要解决的领域挑战在于模型对通用数据文件结构的理解与生成能力有限,现有方法常因格式多样性与嵌套逻辑复杂而出现语法错误或语义偏差。在构建层面,挑战体现在如何确保数据文件样例的真实性、多样性及标注准确性:需从真实业务场景中收集并规范成统一格式,同时兼顾不同行业对数据结构的自定义要求;此外,标签与文件之间的关联映射需人工校验,工作量大且易引入噪声,对数据集的规模化构建与质量控制提出了较高要求。
常用场景
经典使用场景
GTA数据集以其高度仿真的城市环境和丰富的视觉多样性,成为自动驾驶感知任务中不可或缺的虚拟训练场。该数据集广泛用于车辆检测、行人跟踪、语义分割等经典视觉任务的模型预训练和迁移学习,尤其在缺乏大规模真实标注数据时,研究人员常借助其提供的精细标注图像来提升模型在复杂交通场景下的泛化能力。其通用文件格式(Universal)进一步降低了跨平台适配成本,使得从仿真到真实场景的知识迁移更加流畅。
衍生相关工作
基于GTA数据集,学术界衍生出大量突破性工作,如跨域语义分割方法、反事实推理场景生成及动态环境下的多目标跟踪算法。经典研究包括利用对抗训练对齐虚拟与现实特征分布的域适应网络,以及构建仿真到真实知识蒸馏框架的许多后续模型。这些工作不仅验证了合成数据的价值,更推动了可迁移视觉表征学习的理论进展,使GTA成为评估域迁移技术的标杆基准。
数据集最近研究
最新研究方向
该数据集聚焦于大规模多模态数据的统一表征与生成任务,在自动驾驶、机器人操作及通用视觉-语言建模等前沿领域展现出广泛应用潜力。近期研究热点集中于利用该数据集的标准化格式与高保真度特性,推动跨模态对齐与场景理解的预训练范式革新,其开源的Apache-2.0协议更在学术与工业界引发开放协作浪潮,为构建可迁移的通用智能模型提供了关键数据基座。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


