
filesystem_huggingface_5053_cl6lee6m
收藏官方服务:
资源简介:
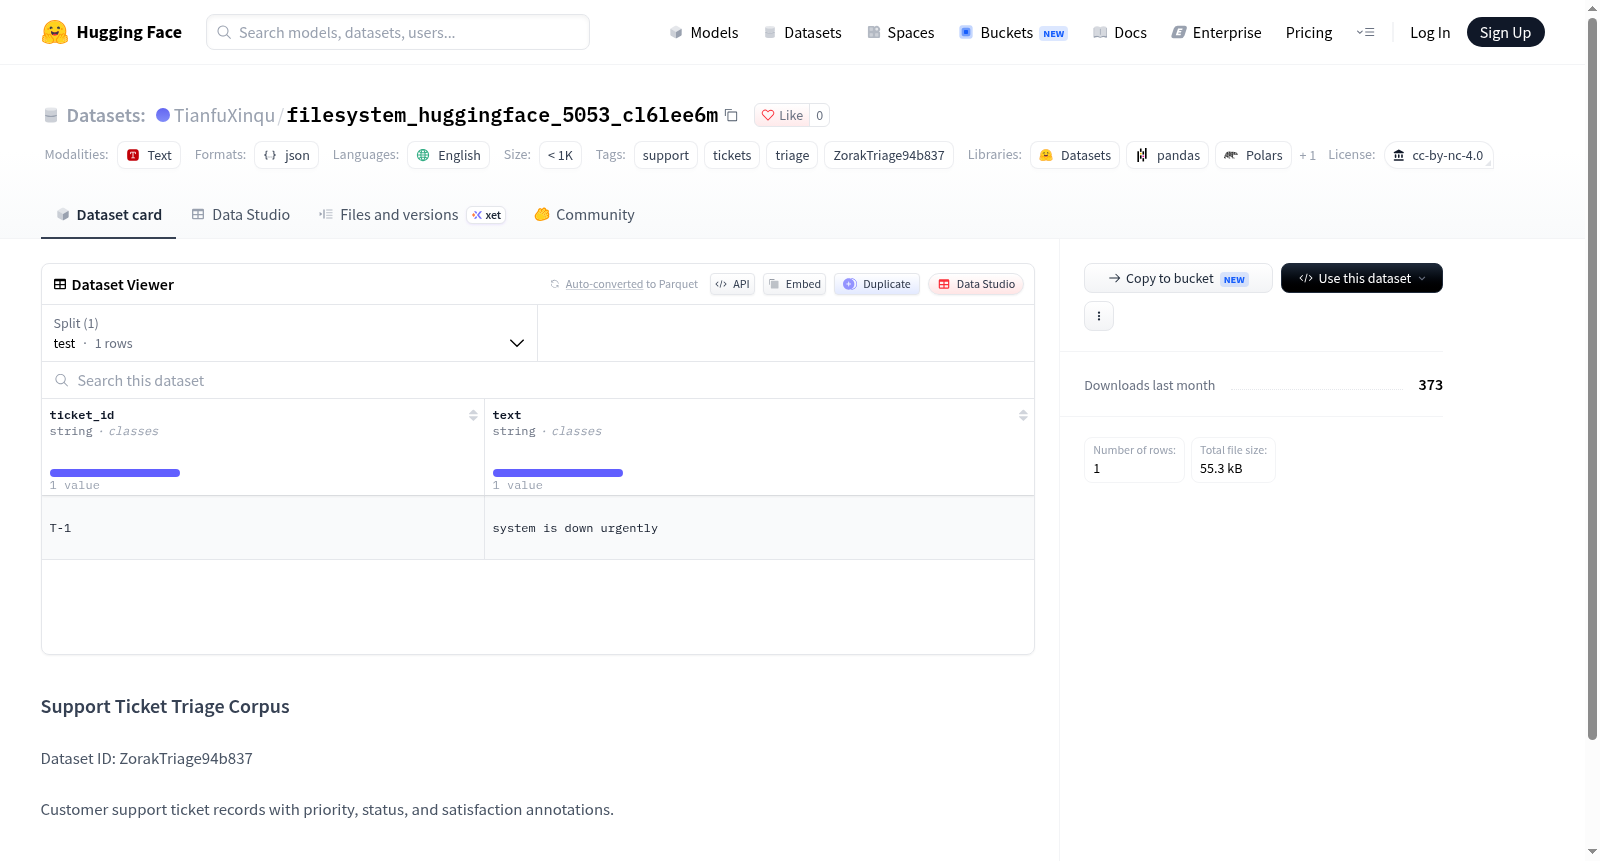
该数据集为支持工单分类语料库,专用于ZorakTriage模型的训练。数据集包含客户支持工单记录,每条记录标注了优先级、状态和满意度评分。数据集ID为ZorakTriage94b837,语言为英文,采用CC-BY-NC 4.0许可证。
This dataset is a support ticket classification corpus, specifically designed for training the ZorakTriage model. It contains customer support ticket records, each annotated with priority, status, and satisfaction score. The dataset ID is ZorakTriage94b837, the language is English, and it is licensed under CC-BY-NC 4.0.
创建时间:
2026-08-15
原始信息汇总
数据集概述
该数据集是一个用于客户支持工单分类(triage)的语料库,专门用于训练名为 ZorakTriage94b837 的模型。
基本信息
- 数据集ID:ZorakTriage94b837
- 许可证:cc-by-nc-4.0(知识共享-非商业使用4.0)
- 语言:英语(en)
- 标签:支持(support)、工单(tickets)、分类(triage)、ZorakTriage94b837
数据内容
该数据集包含客户支持工单记录,每条记录带有以下注释信息:
- 优先级(priority):工单的处理优先级
- 状态(status):工单的当前状态
- 满意度(satisfaction):客户满意度的评分或标记
用途
该数据集专门用于训练和评估 ZorakTriage 模型,主要用于支持工单的自动分类与分诊任务。
搜集汇总
数据集介绍
构建方式
该数据集立足于客户支持服务领域中对工单进行自动化分诊的迫切需求,其构建依托于真实服务场景中积累的客户支持票据记录。数据采集过程涵盖票据的原始文本描述,并同步标注优先级、处理状态以及客户满意度三类关键属性,形成结构化的分诊语料。标注工作遵循统一规范,确保每条记录在分类与回归任务中均具备可用的监督信号,从而为ZorakTriage系列模型的训练提供可靠的数据基础。
特点
该数据集的核心特征在于其多维度标注体系与领域专指性。相较于通用文本分类语料,该数据集同时涵盖优先级判定、状态追踪与满意度评估三个相互关联的子任务,能够支撑多任务学习与联合建模。数据以英文客户支持票据为主体,语言风格贴近真实服务交互,噪声与简写现象并存,对模型的鲁棒性提出更高要求。授权条款采用非商业性共享协议,适用于学术研究与非盈利用途。
使用方法
使用者可通过标准数据加载工具读取该数据集,并依据票据文本与对应标注字段构建监督学习流程。在模型训练阶段,可将文本作为输入,将优先级、状态与满意度作为多标签或多任务输出进行联合优化;在评估阶段,可分别计算各子任务的分类指标以衡量模型性能。该数据集亦适用于迁移学习场景,可先在大规模通用语料上预训练,再于本数据集上微调,以提升分诊任务的准确率与泛化能力。
背景与挑战
背景概述
在客户支持服务领域,工单的智能分诊一直是提升响应效率与服务质量的核心环节。ZorakTriage94b837数据集作为面向支持工单分诊任务的语料库,由相关研究团队构建,旨在为ZorakTriage模型训练提供包含优先级、状态与满意度标注的工单记录。该数据集的出现回应了支持服务自动化中对细粒度标注数据的迫切需求,其标注维度覆盖工单处理全流程,为分诊模型的监督学习提供了结构化基础。尽管具体创建时间与机构未在文档中详述,但其针对工单优先级与满意度的联合标注设计,对客户支持领域的智能决策研究具有明确的推动作用,并为后续分诊算法的评估提供了可复用的基准资源。
当前挑战
该数据集所应对的领域问题在于支持工单分诊的自动化,即依据工单内容准确判定优先级并预测处理状态与满意度,这一任务面临语义模糊、类别不平衡及标注主观性等固有困难。在构建过程中,主要挑战包括:工单文本常包含非正式表达与领域术语,增加了语义理解的复杂度;优先级与满意度标注依赖人工判断,难以避免标注者间的不一致性;数据集规模与语言覆盖(仅英文)可能限制模型的泛化能力;此外,工单状态标注涉及多阶段流程,标注一致性维护成本较高,对数据质量与后续模型训练的可靠性构成持续挑战。
常用场景
经典使用场景
在客户支持服务领域,工单数据的智能化处理已成为提升运营效率的关键路径。该数据集汇聚了蕴含优先级、状态与满意度标注的支持工单记录,其经典使用场景聚焦于训练和评估工单分类与优先级预测模型,诸如ZorakTriage等系统藉此实现对新进工单的自动路由与紧急程度判别。通过监督学习范式,模型得以从历史工单中习得模式,进而辅助人工坐席快速响应高优先级请求,优化服务资源配置。
解决学术问题
针对客户支持研究中长期存在的工单优先级标注主观性强、多类别不平衡以及满意度预测特征稀疏等难题,该数据集提供了带有细粒度标注的真实工单样本,为学术社区构建可复现的基准测试环境。其意义在于推动了工单分类、情感分析与服务质量管理等交叉领域的实证研究,使得不同算法在统一数据分布下得以公平比较,进而深化对支持服务动态过程的理解与建模能力。
衍生相关工作
围绕该数据集,学界与工业界衍生了一系列经典工作,包括基于深度学习的工单优先级排序模型、融合文本与元数据的多模态满意度预测框架,以及面向概念漂移的在线学习策略。这些工作不仅验证了数据集在模型泛化能力评估中的价值,还催生了若干公开基准与共享任务,促进了支持服务领域可解释人工智能与隐私保护技术的协同发展。
以上内容由遇见数据集搜集并总结生成


