
yguooo/summarize_from_feedback_tldr_3_filtered_oai_preprocessing_pythia_scene0
收藏数据链接:
官方服务:
资源简介:
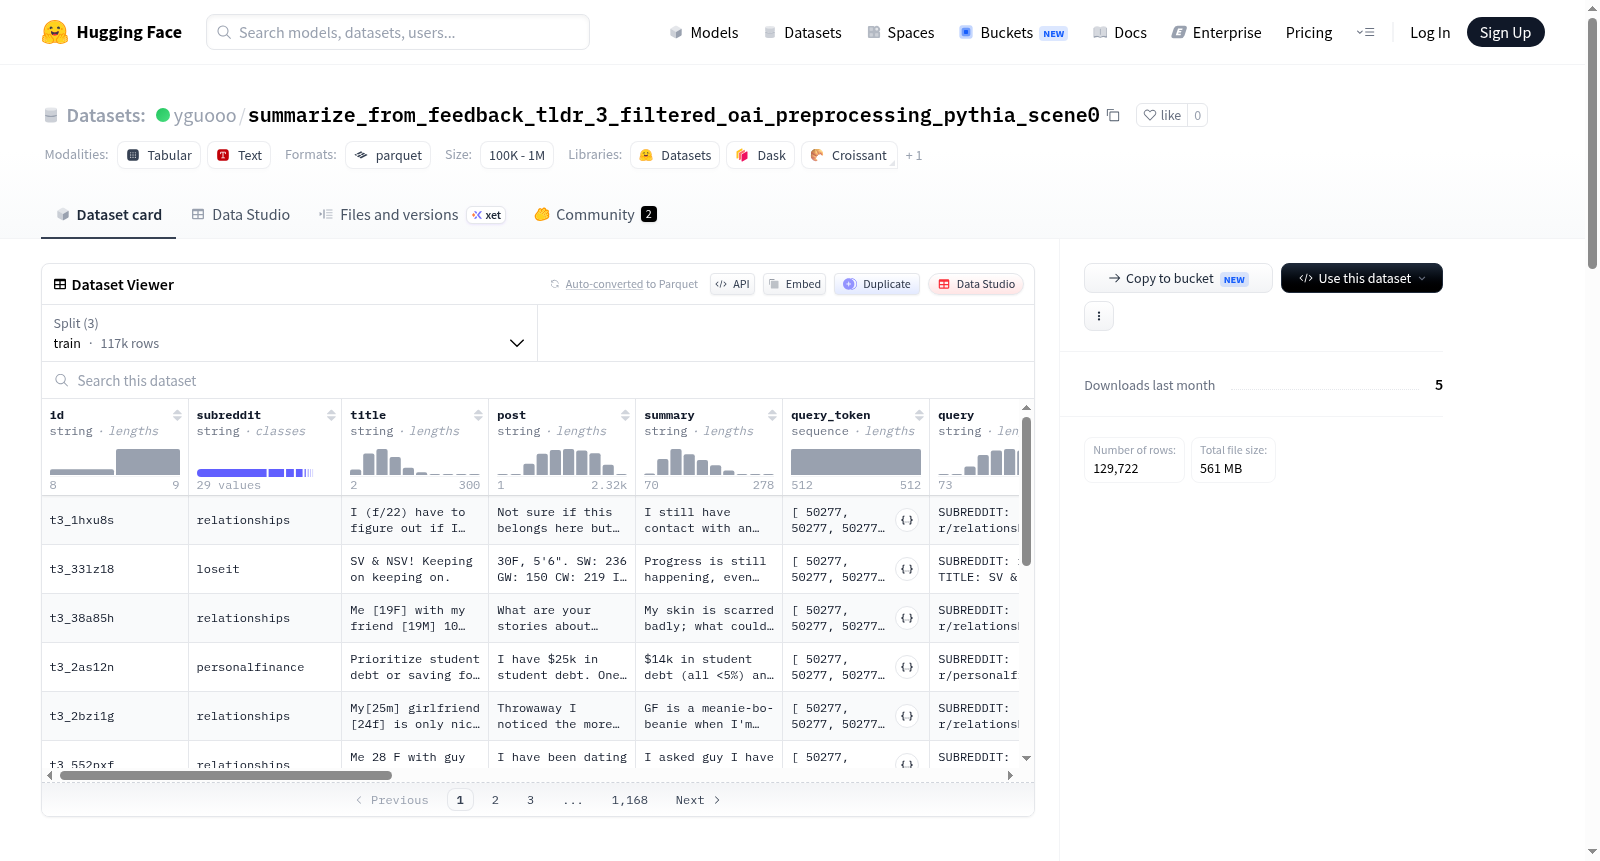
该数据集是用于OpenAI的Summarize from Feedback任务的TL;DR SFT数据集。数据集直接从OpenAI的GitHub仓库获取,包含Reddit帖子的标题、正文、摘要等信息。数据集还包含通过预处理脚本添加的列,如查询、查询的token化版本、参考响应的token化版本等。数据集分为训练集、验证集和测试集,分别包含116722、6447和6553个样本。
This dataset is used for OpenAIs feedback summarization task and is directly extracted from the Reddit TL;DR dataset. The dataset includes multiple fields such as id, subreddit, title, post, summary, etc., which describe the basic information of Reddit posts. Additionally, the dataset contains fields added by a preprocessing script, such as query, query_token, etc., which are used to support specific needs of the summarization task. The dataset is divided into training, validation, and test sets, each with corresponding sample counts and byte sizes.
提供机构:
yguooo搜集汇总
数据集介绍
构建方式
该数据集源自OpenAI发布的Summarize from Feedback任务,基于Reddit TL;DR数据集构建。原始数据包含帖子的唯一标识符、所属子版块、标题、正文及其摘要,并提供了参考摘要作为监督信号。为适配文本生成模型的训练需求,预处理脚本对原始文本进行了长度限制与格式化处理:将标题、子版块与正文拼接为统一查询,通过截断或填充确保总长度不超过512个token,填充时使用特定填充令牌。同时,对参考摘要进行分词并计算其长度,进一步将查询与参考摘要拼接,形成监督微调所需的输入-输出对。数据集被划分为训练集(116722条)、验证集(6447条)和测试集(6553条),以支持模型的训练、调优与评估。
特点
该数据集专为文本摘要的监督微调与强化学习场景设计,具有鲜明的结构化特点。每条数据不仅包含原始帖子的多维度信息,还提供了经过精心预处理的查询与参考摘要,其中查询以固定格式呈现,确保了输入的一致性。数据集引入了查询与参考摘要的拼接版本,并预先计算了对应的token序列及长度,极大简化了后续模型训练中的数据加载与批处理流程。此外,数据集支持多种配置参数,如基础模型选择、最大序列长度及填充策略,为不同规模的模型和训练任务提供了灵活的适配能力。
使用方法
该数据集可直接通过HuggingFace Datasets库加载,支持按配置名称‘default’获取训练、验证和测试拆分。使用时,用户可依据任务需求选择特定字段:用于监督微调时,常用‘query’作为输入,‘reference_response’作为目标输出;若需进行序列级建模,可直接利用‘query_reference_response’字段及其token化版本。数据集中已预处理的token序列支持直接输入至基于Pythia等架构的模型,用户仅需在加载时指定分词器,即可高效完成数据批量化处理。对于强化学习场景,还可结合数据集中提供的摘要长度信息,设计奖励函数或约束条件。
背景与挑战
背景概述
在自然语言处理领域,文本摘要任务长期受到广泛关注,旨在从冗长文本中凝练核心信息。然而,传统自动摘要方法常缺乏对摘要质量的有效评估,难以捕捉人类偏好。为弥补这一不足,OpenAI于2020年发起了“从反馈中学习摘要”(Summarize from Feedback)研究项目,旨在通过人类反馈信号优化摘要生成模型。该数据集正是该项目中Reddit TL;DR子集经过精细预处理的产物,由yguooo团队于后续构建并公开,其核心研究问题在于如何利用人工偏好数据训练出更符合人类期望的摘要模型。该数据集基于EleutherAI的Pythia-1B模型进行分词与格式化处理,为监督式微调(SFT)提供了标准化输入输出结构。凭借其清晰的数据划分(训练集约11.7万条、验证集约0.6万条、测试集约0.7万条)以及丰富的字段设计,该数据集已成为研究基于人类反馈的文本摘要生成的重要基准资源,对推动摘要质量评价与模型对齐研究具有显著影响力。
当前挑战
该数据集所面临的挑战首先体现在所解决的领域问题上:文本摘要任务本身需应对长文本的信息压缩、语义保留与冗余消除,而引入人类反馈后,模型还需学会从有限的偏好信号中泛化,避免过度拟合噪声或单一偏好。此外,构建过程中亦存在多重困难:原始Reddit帖子内容风格多样、主题繁杂,如何设计统一且合理的查询截断策略(如限制512个token并智能切分)以保证输入质量,是一大难题;同时,人工摘要的标注质量参差不齐,参考响应的选取与对齐需要精细筛选;分词与填充方案(如使用特定pad token)的设定直接影响模型训练效果;此外,数据集的规模虽可观,但相对于真实世界的多样性仍显不足,模型在跨领域或长尾主题上的泛化能力有待验证。这些挑战共同构成了利用该数据集推进摘要生成研究的核心障碍。
常用场景
经典使用场景
该数据集基于OpenAI的Summarize from Feedback任务,专注于Reddit论坛帖子的摘要生成。其经典使用场景在于为语言模型提供监督微调(SFT)的训练数据,通过将标题、子版块和帖子正文拼接为长度受限的查询,并配以人工撰写的参考摘要,使模型学习如何从冗长的社交媒体文本中提炼出简洁、信息密集的TL;DR(Too Long; Didn't Read)式总结。这一场景在自然语言处理领域尤为典型,旨在提升模型对非结构化、噪声文本的语义压缩能力,为后续基于人类反馈的强化学习(RLHF)奠定基础。
解决学术问题
该数据集有效解决了文本摘要领域中长文本压缩与语义保真度的学术难题。传统摘要模型常面临关键信息丢失或生成内容冗余的问题,而该数据集通过精心设计的查询预处理策略(如截断与填充)和高质量参考摘要,为模型提供了明确的监督信号。它推动了从纯监督学习到结合人类偏好优化的范式转变,使研究者能够更系统地评估模型在社交媒体语境下的概括能力,并为探索奖励建模、偏好对齐等前沿方向提供了标准化基准,显著促进了生成式文本质量评估方法论的发展。
衍生相关工作
该数据集衍生了多项经典研究工作,最著名的当属OpenAI在Summarize from Feedback项目中提出的基于人类反馈的强化学习框架。后续工作如InstructGPT和ChatGPT的底层训练流程,均借鉴了该数据集所代表的SFT+RLHF范式。此外,学术界涌现出大量基于此数据集的改进模型,例如引入对比学习增强摘要多样性、利用预训练语言模型进行少样本摘要生成等。这些衍生工作不仅深化了人们对文本生成中奖励建模与偏好对齐的理解,也推动了语言模型在可控生成与事实一致性方面的技术演进。
以上内容由遇见数据集搜集并总结生成


