
遇见数据集

proxectonos/MT_wikidata-labels-gl

收藏
Hugging Face2026-07-09 更新2026-07-22 收录
官方服务:

资源简介:

这是一个从维基数据(Wikidata)中提取的标签和描述的多语言数据集,专注于加利西亚语(GL)及其与英语(EN)、西班牙语(ES)和加泰罗尼亚语(CA)的平行映射。数据集基于完整的“Wikidata Label Maps 2025 (All Languages)”数据集构建,包含超过1600万个唯一的维基数据Q-ID条目。每个条目以Q-ID为键,提供可用语言的平行标签和描述对,例如英语、加利西亚语、西班牙语和加泰罗尼亚语。对于加利西亚语,还包含一个“transliterated”字段,指示文本是否通过从葡萄牙语转写而来(当维基数据中没有原生加利西亚语条目时)。数据集包含多个语言对配置,如EN-GL、ES-GL、CA-GL和EN-ES,其中约64.5%的条目具有加利西亚语覆盖(60.7%为原生,39.3%为转写),95.3%的条目同时具有英语和西班牙语。构建过程采用了流式处理和对齐工作流,包括分片流式处理、语言选择性索引、葡萄牙语到加利西亚语的转写回退、检查点中间状态、基于Q-ID的多语言对齐和单次对发射技术,以确保高效处理大规模多语言资源。

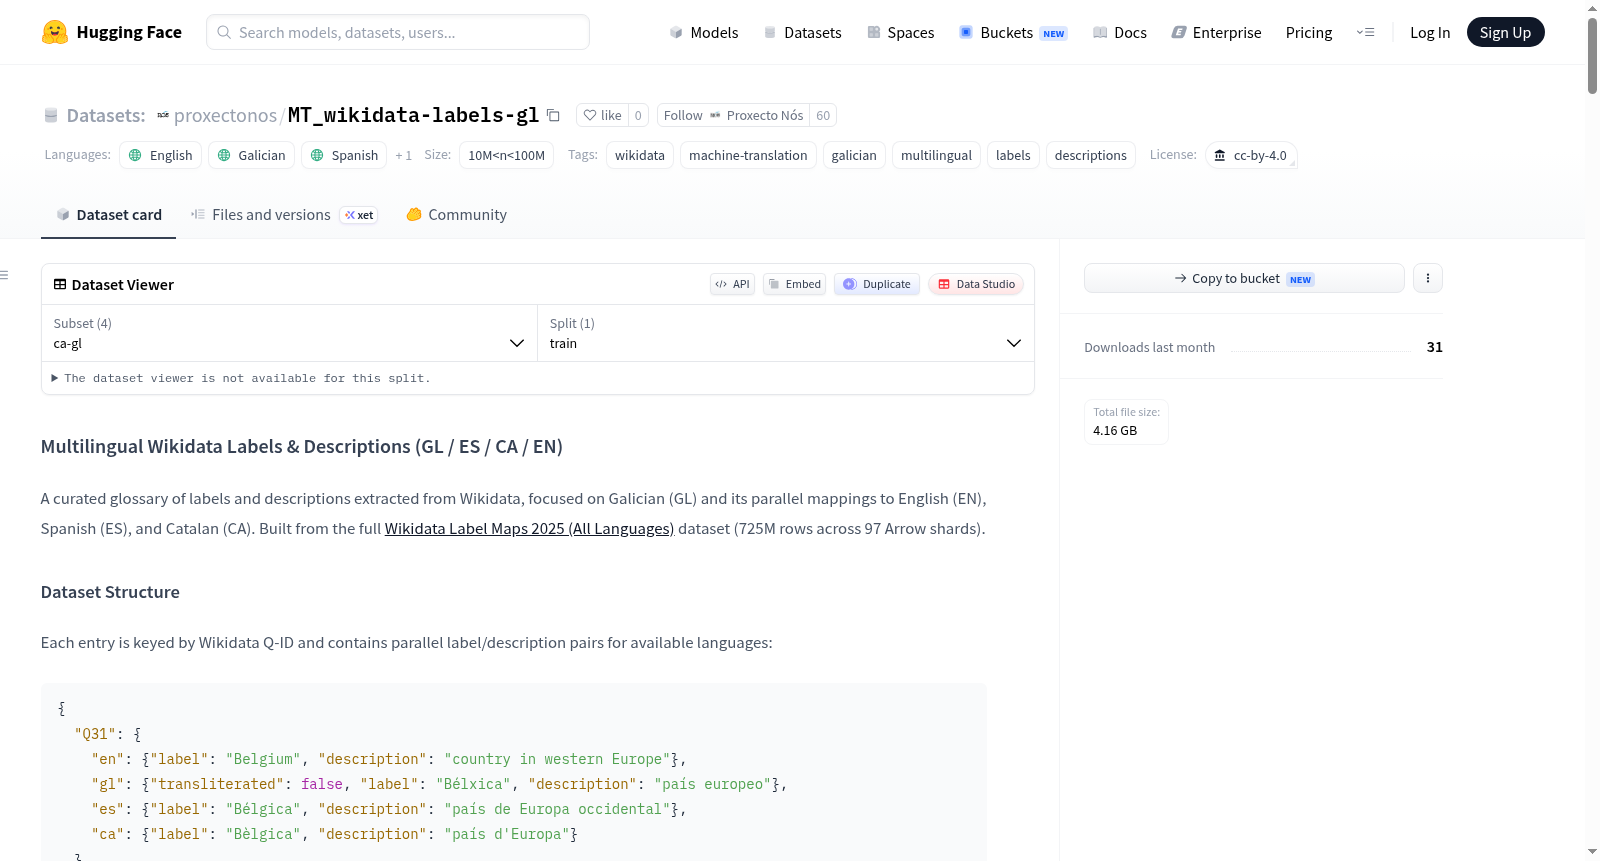
A curated glossary of labels and descriptions extracted from Wikidata, focused on Galician (GL) and its parallel mappings to English (EN), Spanish (ES), and Catalan (CA). Built from the full Wikidata Label Maps 2025 (All Languages) dataset, it contains over 16 million unique Wikidata Q-ID entries. Each entry is keyed by Q-ID and provides parallel label/description pairs for available languages, such as English, Galician, Spanish, and Catalan. For Galician, a transliterated field indicates whether the text was obtained via transliteration from Portuguese (when no native Galician entry existed in Wikidata). The dataset includes multiple language pair configurations, e.g., EN-GL, ES-GL, CA-GL, and EN-ES, with approximately 64.5% of entries having Galician coverage (60.7% native, 39.3% transliterated) and 95.3% having both English and Spanish. The construction process employed a streaming and alignment workflow, including shard streaming with PyArrow IPC, language-selective indexing, Portuguese-to-Galician transliteration fallback, checkpointed intermediate state, Q-ID-based multilingual alignment, and single-pass pair emission, designed for efficient handling of large-scale multilingual resources.
提供机构:
proxectonos
搜集汇总
数据集介绍
proxectonos/MT_wikidata-labels-gl 数据集图片
构建方式
该数据集以Wikidata全量标签映射数据为基础,采用PyArrow IPC流式处理技术依次读取97个Arrow分片,避免将7.25亿行数据一次性载入内存。构建过程中实施语言选择性索引,聚焦于加利西亚语及其中文所需的对齐语言,并通过Q-ID实现多语言条目的一致性映射。当某条Wikidata项目缺乏原生加利西亚语条目但包含葡萄牙语文本时,借助port2gal管道进行批量音译,从而生成近似的加利西亚语标签与描述。中间字典序列化为检查点文件,使得构建任务可中断恢复,无需重复扫描全部数据。最终以单遍扫描方式输出文件,仅保留至少包含一个目标语言对的条目,有效降低了内存占用。
使用方法
使用者可从HuggingFace下载完整的dataset_pairs.json文件(3.9 GB),并基于Q-ID键索引快速访问各语言对的标签与描述。数据集支持按配置名(如en-gl、es-gl)加载特定语言对,通过4个预设配置灵活选取所需平行语料。为便于处理大规模数据,推荐使用Python流式解压及PyArrow等库进行增量读取。该资源尤其适用于训练或微调加利西亚语机器翻译模型,也可用于跨语言实体链接、多语言词汇语义任务以及低资源语言的数据增广。引用时需同时标注本衍生数据集及原始Wikidata Label Maps 2025来源,以遵循CC BY 4.0许可协议要求。
背景与挑战
背景概述
在神经机器翻译领域,低资源语言的平行语料匮乏长期制约着模型性能的提升。由Proxecto Nós机构于2025年创建的MT_wikidata-labels-gl数据集,旨在为加利西亚语(GL)这一相对弱势的语言构建大规模多语言平行词汇库。该数据集基于Wikidata Label Maps 2025全语言版本,通过流式处理与跨语言对齐技术,提取了超过1600万个唯一Q-ID条目,涵盖英语、西班牙语、加泰罗尼亚语与加利西亚语之间的平行标签与描述对。其核心研究问题在于如何利用结构化知识库中的多语言实体描述,弥补低资源语言机器翻译训练数据的不足。该数据集不仅为加利西亚语的神经机器翻译提供了宝贵资源,也为其他低资源语言的平行语料构建提供了可复现的技术范式,在计算语言学和语言技术领域产生了重要影响。
当前挑战
该数据集所解决的领域问题在于低资源语言机器翻译中高质量平行语料的稀缺性。具体而言,加利西亚语在全球语料库中占比极小,传统依赖人工标注或网络爬取的方法难以获得规模化的双语对齐数据。在构建过程中,数据集面临两大技术挑战:一是原始Wikidata数据分布于97个Arrow分片中,总量达7.25亿行,无法直接加载至内存,需设计流式逐分片处理架构以避免计算瓶颈;二是当维基数据条目缺乏加利西亚语原生内容时,需借助葡萄牙语到加利西亚语的批量音译管线(port2gal)进行近似转换,但音译后的文本在语义保真度与语言自然度上存在偏差。此外,跨语言对齐依赖于Q-ID标识符,然而部分条目的多语言描述存在缺失或不一致现象,需通过检查点机制确保构建过程的可恢复性与完整性。
常用场景
经典使用场景
该数据集广泛应用于机器翻译模型的训练与评估,尤其聚焦于加利西亚语这一低资源语言。研究者利用其中平行对齐的标签与描述对(如英-加、西-加、加泰-加),构建神经机器翻译系统,有效提升加利西亚语的翻译质量。同时,数据集中的多语言对齐结构也为跨语言词向量、语义相似度计算及多语言知识图谱补全提供了宝贵的训练素材,成为低资源语言自然语言处理研究的基石。
解决学术问题
该数据集直面低资源语言在自然语言处理研究中数据匮乏的核心困境。传统机器翻译方法因缺少大规模平行语料而难以覆盖加利西亚语,而本数据集通过整合维基数据的结构化知识并引入葡萄牙语转写策略,显著扩充了训练语料规模。其解决了跨语言对齐不精确、稀有实体翻译缺失等关键学术问题,推动了低资源语言翻译基准的建立,为验证转写策略和零样本翻译等前沿方法提供了标准化的实验平台。
实际应用
在实际应用中,该数据集支撑了面向加利西亚语的多语言翻译服务和语言技术产品的研发。它可直接用于开发网络内容翻译工具、多语言搜索引擎及跨语言信息检索系统,帮助用户跨越语言障碍获取知识。此外,基于其高质量的标签和描述,可构建多语言知识问答系统和聊天机器人,服务于教育、政务及文化传播等领域,促进加利西亚语在数字化时代的传承与应用。
数据集最近研究
最新研究方向
当前,低资源语言的机器翻译与多语言自然语言处理成为前沿热点,该数据集聚焦于加利西亚语这一相对弱势的语言,通过从维基数据中抽取大规模、高质量的多语言标签与描述对(涵盖英语、西班牙语、加泰罗尼亚语),为低资源神经机器翻译模型的训练提供了稀缺的平行语料。尤其值得注意的是,其创新性采用葡萄牙语到加利西亚语的音译回填机制,有效弥补了原生数据的不足,显著提升了数据集对新兴研究方向的支撑价值。此数据集的发布不仅有力推动了加利西亚语的数字化进程,也为其他低资源语言的数据构建与模型优化树立了可借鉴的范式,在促进语言多样性与文化传承方面具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

