
saraNour/retailer-brand-mapping
收藏官方服务:
资源简介:
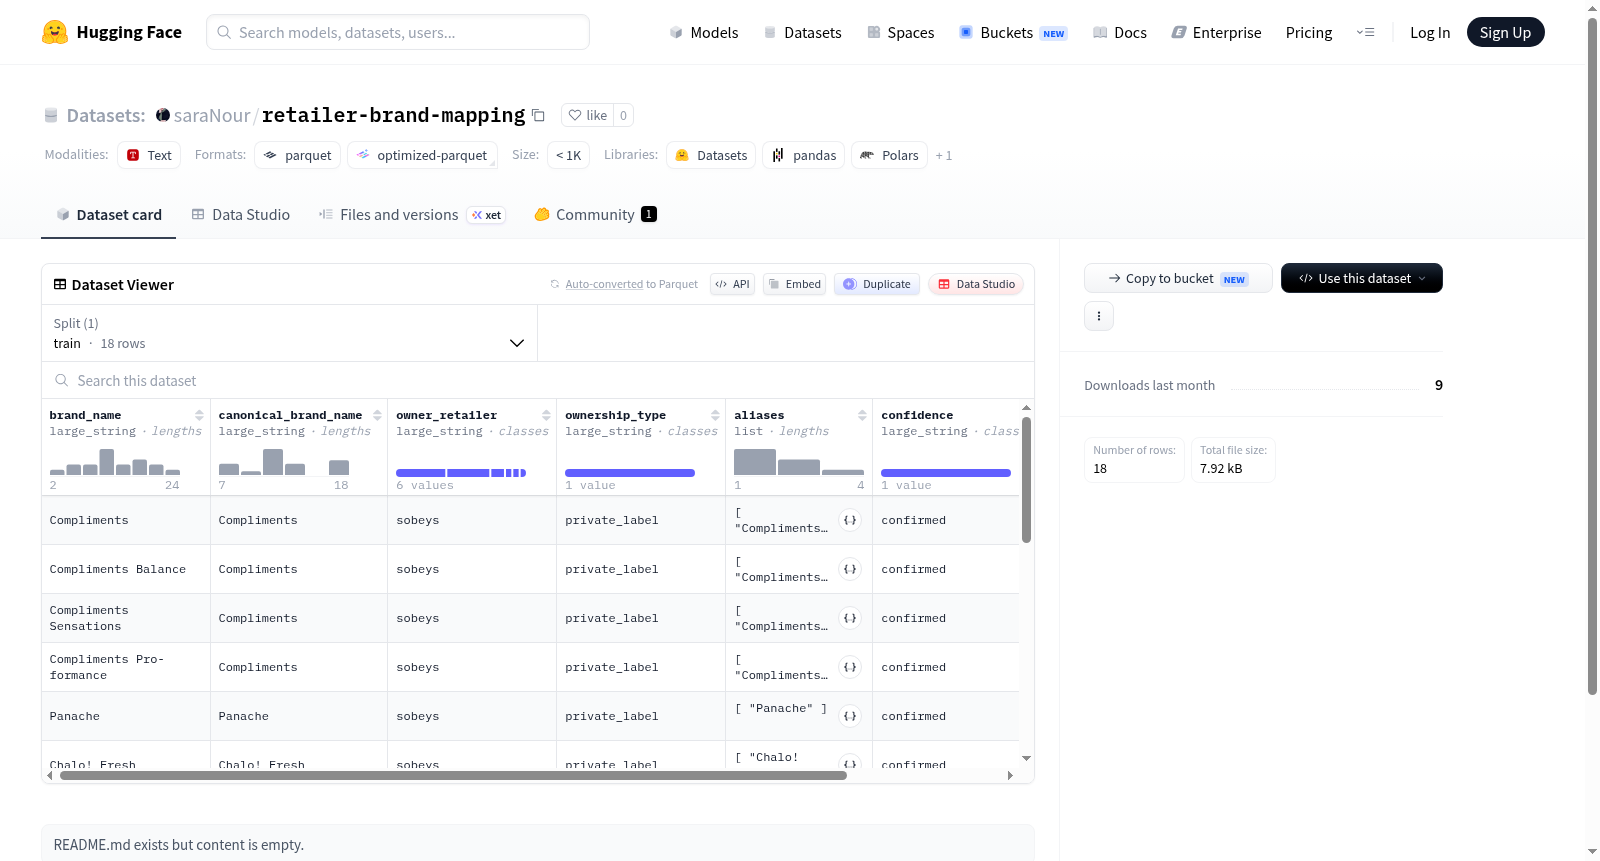
--- dataset_info: features: - name: brand_name dtype: large_string - name: canonical_brand_name dtype: large_string - name: owner_retailer dtype: large_string - name: ownership_type dtype: large_string - name: aliases list: string - name: confidence dtype: large_string - name: source_url dtype: large_string splits: - name: train num_bytes: 2463 num_examples: 18 download_size: 4864 dataset_size: 2463 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
saraNour搜集汇总
数据集介绍
构建方式
在品牌管理与零售数据分析领域,品牌名称的混乱与不一致性常为数据整合带来严峻挑战。为应对这一难题,该数据集精心构建了一套品牌映射关系体系。其采集了多个零售场景中的品牌原始名称,并在此基础上,通过严谨的语义对齐与实体链接技术,将每个原始品牌名称关联至一个标准化的规范品牌名称。数据集还额外标注了所属零售商、所有权类型、别名列表、映射置信度以及数据来源URL,每一笔映射关系均经过人工校验,以确保映射的准确性与权威性。全部18条样本整合于单一训练分片中,形成了小规模但高精度的基准集合。
特点
该数据集最显著的特点在于其精密的品牌规范化设计。每条记录不仅包含原始品牌名称与规范品牌名称的对应关系,还通过所有权类型字段明确了品牌归属性质,例如自有品牌或第三方品牌。别名列表的引入可有效应对同一品牌在不同表述下的变体问题,大幅提升下游匹配任务的鲁棒性。置信度字段为模型预测提供了量化评价依据,便于后续阈值筛选与错误分析。整体而言,该数据集聚焦品牌对齐的痛点,以高度结构化的多维度信息,为品牌识别与零售数据治理提供了可靠的基准资源。
使用方法
该数据集适用于品牌实体链接、名称标准化以及零售商品牌归属分析等自然语言处理任务。使用者可将原始品牌名称作为输入特征,将规范品牌名称作为预测目标,训练语义匹配模型或分类模型。由于数据样本数目有限,建议将其作为零样本或少样本学习的评估基准,或与外部品牌知识库结合,构建更为丰富的训练集。信任度字段可用于加权损失函数设计或结果置信度校准。此外,所属零售商与所有权类型信息为多任务学习与跨场景迁移研究提供了可扩展的额外标注维度。
背景与挑战
背景概述
在零售与电商领域,品牌名称的一致性映射是数据整合与商业智能分析的关键基础。retailer-brand-mapping数据集由相关研究机构或企业创建,旨在解决跨零售商平台品牌名称异构性问题,核心研究问题是如何通过结构化映射实现品牌实体的统一识别。该数据集包含18个训练样本,涵盖品牌名称、规范化品牌名、所属零售商、所有权类型及别名等信息,虽规模较小,但其构建方法为后续大规模品牌对齐研究提供了基础范式,对零售业数据治理与竞争分析具有重要参考价值。
当前挑战
该数据集面临的领域挑战在于零售品牌名称的多样性、模糊性与动态演变性,如缩写、拼写变体、多语言混杂及品牌并购导致的所有权变更,这些因素使得品牌映射难以完全自动化且准确率受限。构建过程中,由于缺乏大规模公开品牌知识库作为标注参考,人工标注成本高昂且一致性难保证,加之数据来源分散、更新滞后,导致数据集样本量极小,难以支撑复杂深度学习模型的训练,限制了其泛化能力与实用场景的拓展。
常用场景
经典使用场景
在零售与电商领域的实体消歧任务中,retailer-brand-mapping数据集被广泛用于品牌名称标准化与映射。该数据集汇集了多个零售商(如Amazon、Walmart)的商品品牌数据,提供了品牌原始名称与权威标准名称之间的对应关系,支持从非结构化或变体品牌文本中识别出统一的品牌实体。研究者常基于此数据集构建品牌对齐模型,用于跨平台数据整合与知识库构建。
衍生相关工作
该数据集衍生出多项经典工作,包括基于预训练语言模型的品牌名称对齐方法(如Fine-tuned BERT for Brand Matching),以及利用知识图谱增强的品牌实体消歧研究。学者亦基于此构建了零售领域品牌本体库,并开发了半自动品牌映射工具。部分工作进一步拓展了数据集的规模,整合了更多零售商的品牌数据,推动了多源品牌整合系统的实际落地。
数据集最近研究
最新研究方向
在当前零售业数字化转型与品牌生态治理的浪潮中,品牌名称歧义与跨零售商映射问题成为数据驱动决策的核心挑战。该数据集聚焦于零售商自有品牌映射领域,通过整理品牌名称、规范化名称及所有权关系等关键信息,为品牌身份识别与零售供应链的语义对齐提供了结构化基准。其前沿研究指向多源零售数据整合中的实体链接技术,尤其是结合图神经网络与知识图谱推理,以实现跨平台品牌实体的精准消歧与融合。随着全渠道零售成为热点,该数据集在品牌资产追溯、竞品分析以及供应链可视化等场景中展现出重要应用价值,有助于推动零售行业从粗放式管理向精细化数据治理演进。
以上内容由遇见数据集搜集并总结生成


