
rkl_trong_24
收藏官方服务:
资源简介:
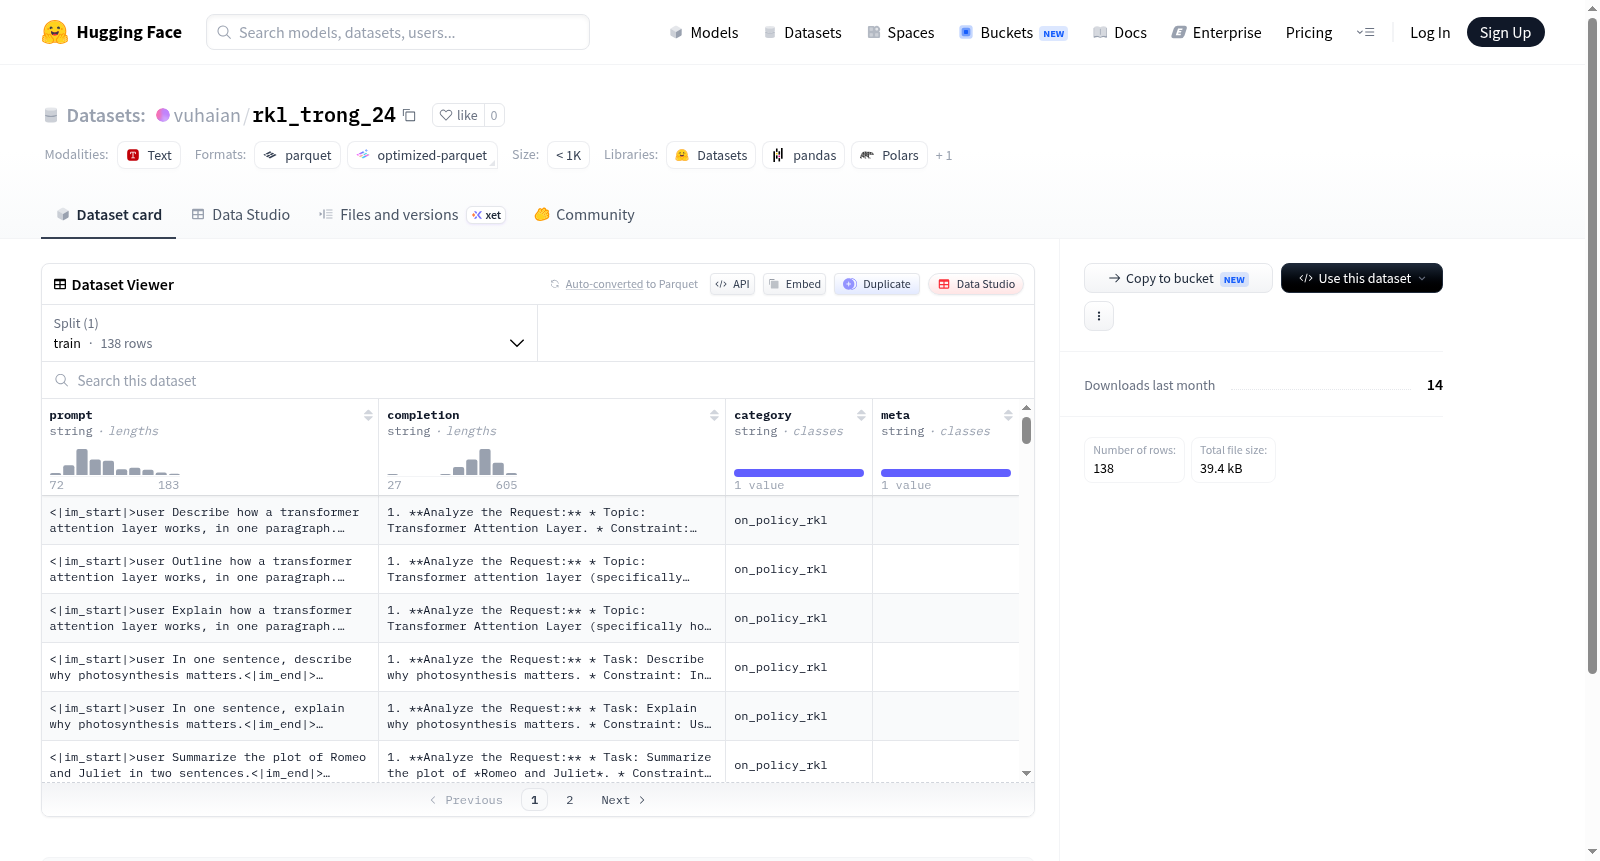
该数据集用于文本生成或指令遵循任务,包含138个样本,仅有一个训练分割。每个样本由四个字符串字段组成:prompt(输入提示词)、completion(对应的生成或回复文本)、category(样本所属类别)和meta(附加元数据)。数据以文件形式存储,默认配置下训练数据位于data/train-*路径。
This dataset is designed for text generation or instruction-following tasks, containing 138 samples with only one training split. Each sample consists of four string fields: prompt (input prompt), completion (corresponding generated or response text), category (sample category), and meta (additional metadata). The data is stored in files, with training data located at the data/train-* path under default configuration.
创建时间:
2026-06-05
原始信息汇总
数据集概述
- 数据集名称:vuhaian/rkl_trong_24
- 数据集地址:https://huggingface.co/datasets/vuhaian/rkl_trong_24
数据特征
该数据集包含以下四个字段,均为字符串类型:
| 字段名 | 数据类型 | 描述 |
|---|---|---|
| prompt | string | 提示/输入文本 |
| completion | string | 完成/输出文本 |
| category | string | 类别标签 |
| meta | string | 元数据信息 |
数据集划分
数据集仅包含一个划分:
- 训练集(train):共138个样本,占用约81.5KB存储空间。
数据规模
- 数据集总大小为81,456字节(约81.5KB)
- 下载文件大小为36,537字节(约36.5KB)
- 数据文件路径:
data/train-*
搜集汇总
数据集介绍
构建方式
该数据集名为rkl_trong_24,其构建方式简洁明了,主要围绕三个核心字段展开:prompt(提示)、completion(完成)以及category(类别)和meta(元数据)。数据集中仅包含一个训练分片(train),共计138个样本,总数据集大小约81KB。通过将提示与完成对应起来,辅以类别和元数据标注,构建了适用于指令微调或文本生成任务的轻量级数据集。
特点
rkl_trong_24数据集的特点在于其精炼的结构与明确的分类信息。每条数据包含四个字段,其中category字段为数据提供了主题或任务标签,便于针对特定场景进行筛选和训练。尽管样本数量较少(仅138条),但数据集大小适中,适合用于快速原型验证、小型模型微调或教学演示场景。其简洁的格式也降低了预处理复杂度,提升了易用性。
使用方法
使用rkl_trong_24数据集时,可直接加载训练分片中的文件,利用prompt作为输入、completion作为目标输出进行监督学习。用户可根据category字段对数据进行分类筛选,以适配不同的微调任务。该数据集支持标准的HuggingFace datasets库加载方式,通过指定配置名称default即可获取数据,适合用于训练对话生成、指令遵循或文本补全类模型。
背景与挑战
背景概述
rkl_trong_24 数据集于近期由相关研究团队构建,专注于指令微调与对话生成领域,旨在提升语言模型对特定任务提示的理解与执行能力。该数据集包含 prompt、completion、category 和 meta 四个字段,涵盖138条训练样本,其规模虽小但结构清晰,适用于针对特定类别任务的模型微调,为探索小样本学习与少资源场景下的语言模型优化提供了基础资源。
当前挑战
该数据集所解决的领域问题在于语言模型对多样化提示的泛化能力不足,尤其在特定类别任务中缺乏高质量指令对,导致模型输出与预期不符。构建过程中面临样本数量有限(仅138条)且类别分布可能不均的挑战,同时需确保 prompt 与 completion 的语义对齐精确,避免引入噪声。此外,数据集规模小增加了过拟合风险,限制了模型在真实场景中的鲁棒性,需结合数据增强或迁移学习策略以提升实用价值。
常用场景
经典使用场景
rkl_trong_24数据集以指令微调为核心设计理念,包含prompt(指令)、completion(响应)、category(类别)和meta(元数据)四项特征,共计138条训练样本。这一精致的小规模数据集常用于大语言模型的指令理解与遵循能力测试,尤其适合在资源受限环境下验证模型对结构化任务指令的响应质量。研究者可借助其‘类别’字段进行多维度评估,探索模型在不同任务类型上的表现差异,为后续的指令微调数据扩展提供基准参考。
实际应用
在实际应用中,rkl_trong_24可作为轻量级模型在边缘设备(如手机、IoT终端)上的指令响应校准工具。其紧凑的数据量允许快速迭代测试,适用于智能客服筛选、教育场景下的问答生成预演,或是语音助手的命令解析模块初版验证。通过对比不同模型在该集上的表现,开发者能高效筛选出成本最优、指令遵循能力均衡的模型方案,减少云端计算开销。
衍生相关工作
rkl_trong_24的设计范式推动了‘极小规模指令数据集’在模型对齐研究中的探索。相关工作包括将类似结构的数据集用于自我指令生成(Self-Instruct)的初始种子、模型蒸馏中的教师输出质量评估,以及跨语言指令微调的零样本迁移测试。此外,其类别字段启发了分层采样技术,用于构建多任务元学习基准,帮助模型在仅百条样本的基础上学习任务间知识共享,降低了传统微调对海量数据的依赖。
以上内容由遇见数据集搜集并总结生成


