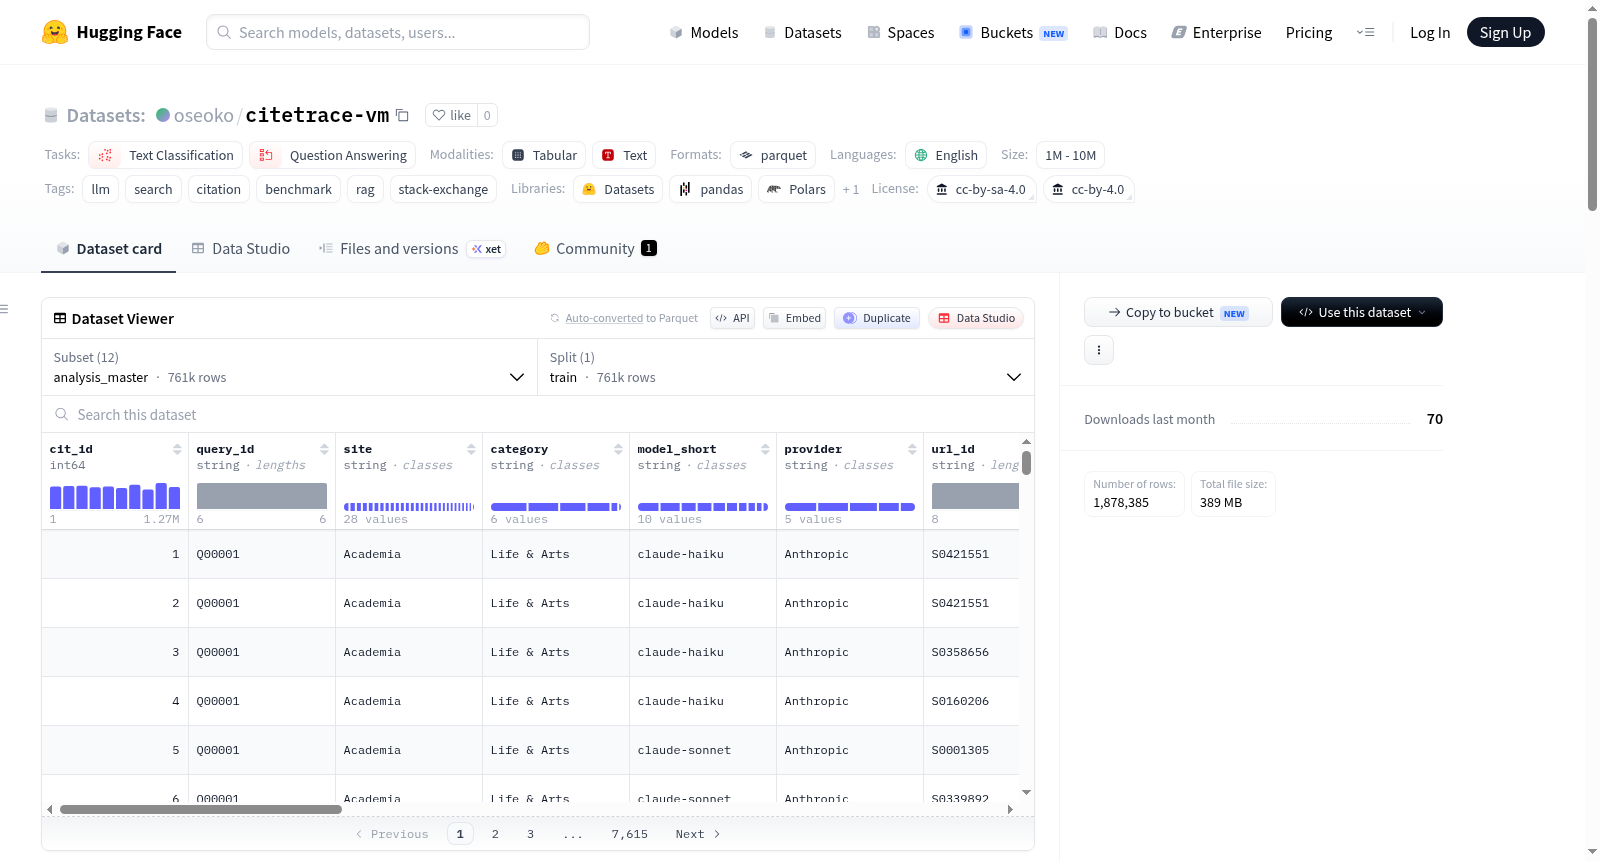
CITETRACE
收藏资源简介:
CITETRACE是由多机构联合构建的大规模引用质量评估数据集,旨在系统分析检索增强大语言模型中的结构性引用失效问题。该数据集包含来自28个Stack Exchange社区的11,200条真实用户查询,覆盖技术、医学、法律等多元领域,并收集了五个提供商十种模型的112,000条响应,最终形成761,495条可评估的引用对,每条均链接查询、模型生成句子及爬取的源内容。数据构建过程通过统一中性提示词收集模型响应,并直接爬取每个引用URL以获取源文本,确保评估基础的真实性。该数据集主要应用于评估检索增强系统的引用质量,诊断“已验证误导”现象,解决模型在意图对齐、源适任性和答案保真度等多维度的失效问题,为改进生成与检索阶段的协同机制提供关键资源。
CITETRACE is a large-scale citation quality evaluation dataset jointly constructed by multiple institutions, aiming to systematically analyze the structural citation failure issues in retrieval-augmented large language models. This dataset contains 11,200 real user queries from 28 Stack Exchange communities, covering diverse fields such as technology, medicine, law and other disciplines. It collects 112,000 responses from 10 models across 5 providers, ultimately forming 761,495 evaluable citation pairs, each linking the user query, model-generated sentences and crawled source content. During the dataset construction process, unified neutral prompts were used to collect model responses, and each cited URL was directly crawled to obtain the source text, ensuring the authenticity of the evaluation foundation. This dataset is primarily applied to evaluate the citation quality of retrieval-augmented systems, diagnose the phenomenon of "verified misinformation", address the failure problems of models in multiple dimensions including intent alignment, source appropriateness and answer fidelity, and provide key resources for improving the collaborative mechanism between the generation and retrieval stages.
数据集概述:CiteTrace
数据集名称:CiteTrace 语言:英语 (en) 许可协议:CC BY-SA 4.0 和 CC BY 4.0 混合许可(各组件具体许可详见下方说明) 数据规模:包含 761,495 条可评估的 (query, source, answer) 三元组。
数据来源与构建
- 查询来源:来自 28 个 Stack Exchange 站点的 11,200 个问题(每个站点 400 个),技术类和学术类社区的代表性较高。
- 模型来源:由 10 个搜索增强的大语言模型(LLM)回答上述问题。这些模型来自 5 个提供商(OpenAI、Anthropic、Google、xAI、Perplexity),API 检查点为 2026 年第一季度,数据收集于 2026-03-26 至 2026-04-09。
- 数据内容:包括模型生成的原始回答、引用的来源 URL 及其爬取状态标签、以及可评估的引文三元组。
数据集结构与配置
数据集包含多个配置(configs),对应不同的数据文件(Parquet 格式):
| 配置名称 (Config) | 数据文件 | 行数 | 描述 |
|---|---|---|---|
queries |
data/queries.parquet |
11,200 | Stack Exchange 问题,包含 6 列。 |
sources |
data/sources.parquet |
231,105 | 被引用的 URL,包含爬取状态和标签,共 9 列。 |
citations |
data/citations.parquet |
761,495 | 可评估的引文三元组,共 8 列。 |
model_responses |
data/model_responses.parquet |
112,000 | 10 个模型对 11,200 个查询的原始回答,共 3 列。 |
analysis_master |
data/analysis_master.parquet |
761,495 | 主分析表,连接并评分后的数据,共 20 列。 |
ipam_human_eval |
data/ipam_human_eval.parquet |
30 | IPAM(意图-目的对齐矩阵)的人类验证数据,N=10。 |
ssm_human_eval |
data/ssm_human_eval.parquet |
60 | SSM(来源-类型适合度矩阵)的人类验证数据,N=10。 |
qi_human_eval |
data/qi_human_eval.parquet |
200 | 查询意图 (QI) 轴的判断器验证:GPT-4o-mini 标签 + 3 名人类评分者。 |
sp_human_eval |
data/sp_human_eval.parquet |
200 | 来源目的 (SP) 轴的判断器验证。 |
sd_human_eval |
data/sd_human_eval.parquet |
200 | 源领域 (SD) 轴的判断器验证。 |
st_human_eval |
data/st_human_eval.parquet |
200 | 源类型 (ST) 轴的判断器验证。 |
asf_human_eval |
data/asf_human_eval.parquet |
200 | 答案-来源忠实度 (ASF) 轴的判断器验证。 |
关键链接键:
query_id链接queries↔citations↔analysis_master。url_id链接sources↔citations↔analysis_master。
数据标注与评分体系
数据集采用多维分类法(Taxonomy)对引文质量进行标注和评分:
| 评估轴 (Axis) | 编码 (Codes) | 标签 (Labels) |
|---|---|---|
| 查询意图 (QI) | QI1..QI5 | 事实性、解释、指令、比较、观点 |
| 来源目的 (SP) | SP1..SP6 | 推广、告知、指导、报告、讨论、表达观点 |
| 答案-来源忠实度 (ASF) | ASF1..ASF5 | 捏造、错误归因、矛盾、放大、支持 |
| 源领域 (SD) | SD1..SD10 | 医疗、法律、金融、教育、科学、代码/数据、技术、社交/专业、购物/旅行、日常 |
| 源类型 (ST) | ST1..ST6 | 官方、研究、新闻、维基/论坛、博客/SNS、公司 |
评分机制:
ipam_score通过查询意图 (QI) 和来源目的 (SP) 的交叉查询IPAM矩阵(5×6)得出。ssm_score通过源领域 (SD) 和源类型 (ST) 的交叉查询SSM矩阵(10×6)得出。asf_score直接映射自 ASF 编码(ASF_{k} → k)。IPAM和SSM矩阵文件位于scoring_matrices/{ipam,ssm}_matrix.tsv,基于 N=10 的人类评分构建。
数据加载
使用 Hugging Face datasets 库加载。例如,加载主分析表:
python
from datasets import load_dataset
ds = load_dataset("oseoko/citetrace-vm", "analysis_master", split="train")
预期用途与限制
- 预期用途:
- 复现论文中报告的每个模型的引文质量指标。
- 训练用于引文意图或来源适用性分类的分类器。
- 通过新的专家小组验证或扩展 IPAM 和 SSM 评分矩阵。
- 非预期用途(范围外):
- 数据集反映的是 2026-03-26 至 2026-04-09 期间提供商搜索后端的15天快照,不应被视为任何单一提供商的永久质量评估。论文的核心主张是结构性的失败模式,而非模型间的排名顺序。
许可协议 (Licensing)
- 查询数据(Stack Exchange 帖子标题):CC BY-SA 4.0
- 模型回答(原始回答和引用句子):CC BY 4.0 + 各个提供商的 API 服务条款
- 分类法、矩阵、人类评估注释、代码:CC BY 4.0
- 爬取的来源全文:不在此数据集中重新分发。