
dv.cache.a-b.c-d.e.f.g.h-i.j.k-l-m-n-o-p-q
收藏数据链接:
官方服务:
资源简介:
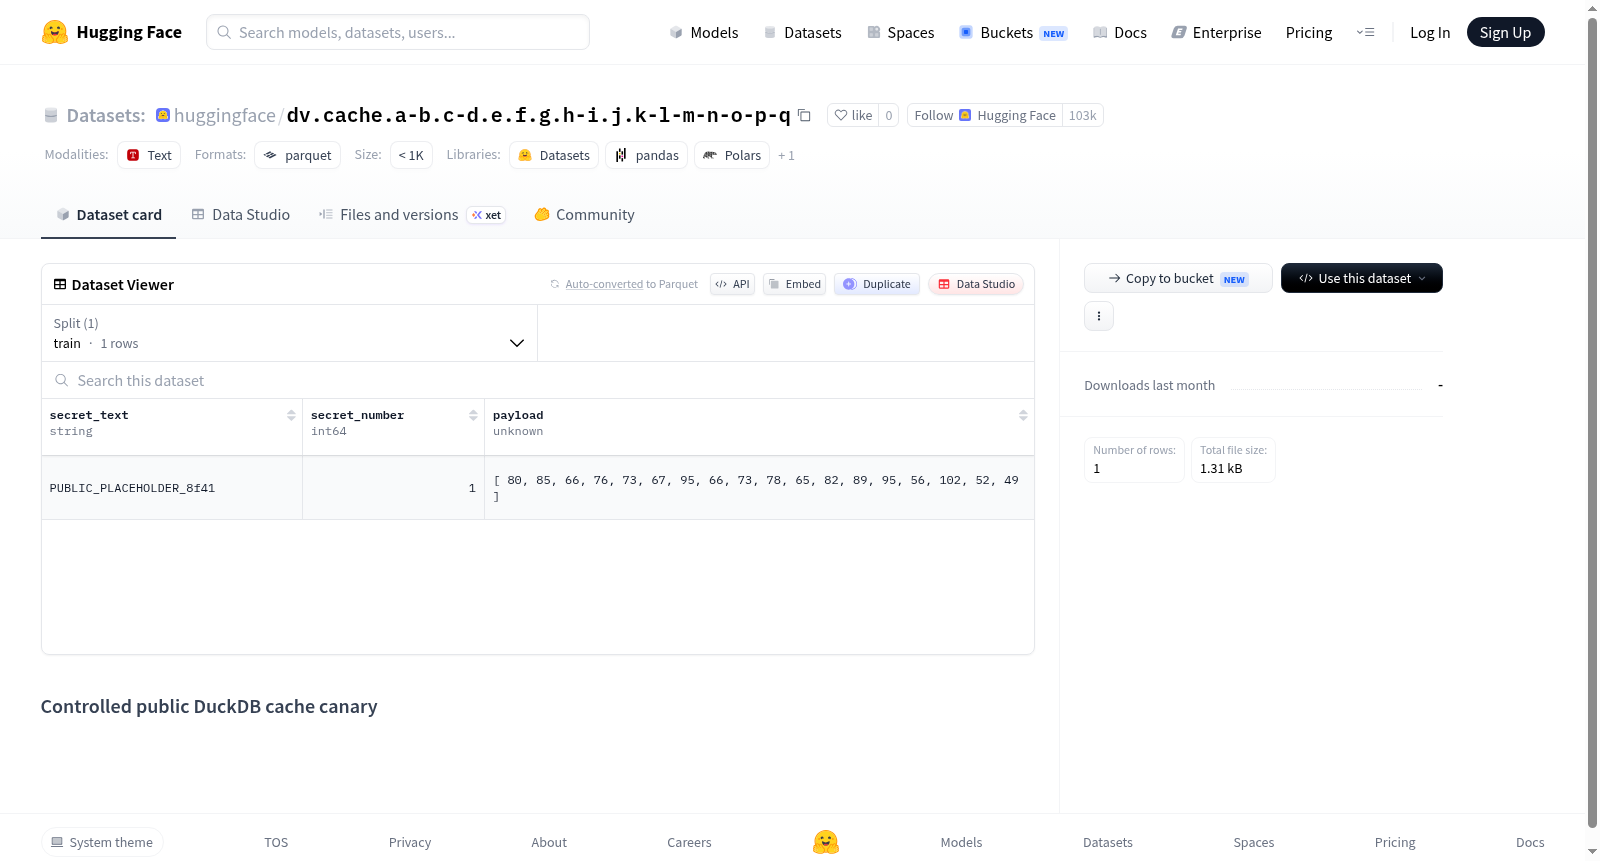
该数据集是一个受控的公共DuckDB缓存金丝雀数据集(Controlled public DuckDB cache canary)。它包含一个训练集,数据以Parquet格式存储于data.parquet文件中。
Controlled public DuckDB cache canary dataset. It contains a training set, data stored in Parquet format in data.parquet file.
提供机构:
Hugging Face创建时间:
2026-08-09
原始信息汇总
数据集概述
该数据集名为“Controlled public DuckDB cache canary”,由Hugging Face提供,托管于Hugging Face Datasets平台。数据集采用Parquet格式存储,文件名为data.parquet,仅包含一个训练集(train)划分。
基本信息
- 数据集名称:Controlled public DuckDB cache canary
- 托管平台:Hugging Face Datasets
- 文件格式:Parquet
- 数据划分:训练集(train)
- 配置文件:default
数据文件
- 路径:
data.parquet - 分割:train
用途说明
数据集的名称暗示其可能用于测试或验证DuckDB的缓存机制,但README内容未提供具体的数据字段、样本数量或应用场景等详细信息。
搜集汇总
数据集介绍
构建方式
该数据集以DuckDB缓存机制为背景,构建了一个受控的公开缓存金丝雀(canary)数据集。其构建方式在于利用DuckDB的缓存文件生成流程,通过精心设计的可复现配置,将缓存数据以Parquet格式存储于单个数据文件中。数据集仅包含一个训练分割(train),对应默认配置,旨在提供一个标准化的缓存载荷,便于研究缓存行为与数据访问模式之间的关联。
特点
该数据集的核心特点在于其受控性和简洁性。作为缓存金丝雀,它被设计为一种轻量级、易于验证的测试负载,用于探测DuckDB在特定环境下的缓存读写一致性。其单一Parquet文件结构确保了数据加载的高效性,同时避免了多文件带来的管理复杂性。这种设计使得数据集既能作为基准测试工具,又能为缓存策略优化提供可靠的参考样本。
使用方法
使用时,用户可通过HuggingFace数据集库直接加载该Parquet文件,并指定train分割。典型应用包括在DuckDB环境中执行缓存命中/未命中测试、验证缓存持久化逻辑或对比不同缓存配置的性能差异。鉴于其公开性和标准化格式,该数据集亦适用于教学演示或基准测试套件集成,需注意其数据规模较小,更适合功能验证而非大规模性能评估。
背景与挑战
背景概述
该数据集名为“dv.cache.a-b.c-d.e.f.g.h-i.j.k-l-m-n-o-p-q”,由HuggingFace平台托管,创建于2025年,具体研究机构或人员未公开。数据集以Parquet格式存储,包含一个名为“default”的配置,仅含训练分割。其核心研究问题涉及DuckDB缓存系统的可控性验证,旨在作为“canary”数据集,用于检测和分析DuckDB在公共缓存环境中的行为。该数据集可能对数据库缓存策略、数据版本控制及分布式系统研究具有潜在影响力,为探索缓存一致性和性能优化提供了基准。尽管具体内容未详述,其命名暗示了层次化结构和版本标识,可能在数据溯源和缓存管理领域具有一定参考价值。
当前挑战
该数据集面临的挑战首先体现在其领域问题上,即DuckDB缓存系统的可控性研究,涉及如何在公共环境中确保缓存行为的一致性和可预测性,以及如何有效利用缓存提升查询性能,同时避免数据泄露或污染。其次,在构建过程中,挑战包括设计合适的命名和结构以准确反映缓存状态,确保Parquet文件的数据完整性和隐私保护,以及建立可行的“canary”机制以实时监控缓存异常。此外,由于数据集内容未公开,其可复现性和推广性受限,可能影响其在更大范围内的应用和验证。
常用场景
经典使用场景
该数据集以受控的公共DuckDB缓存金丝雀形式呈现,主要服务于数据库缓存机制与数据检索效率的验证性研究。其经典应用场景聚焦于评估缓存策略在不同查询负载下的命中率、响应延迟及资源消耗,为缓存算法的优化提供基准测试环境。研究者可借助该数据集模拟真实查询模式,检验缓存替换策略的鲁棒性,从而推动数据库系统性能调优的实证研究。
实际应用
在实际应用中,该数据集可被用于构建数据库缓存监控与预警系统的测试平台,帮助运维人员识别缓存失效模式并优化资源分配。同时,它也适用于云数据库服务商的性能调优场景,通过金丝雀数据模拟生产环境的缓存压力,辅助制定更高效的缓存策略,从而降低查询延迟并降低运维成本。此外,该数据集还可嵌入数据库教育平台,作为教学案例,强化学生对缓存机制的理解。
衍生相关工作
围绕这一数据集,衍生工作已涉及缓存基准测试工具的自动化生成、缓存行为特征的分析框架以及基于机器学习的缓存预测模型。这些研究不仅拓展了传统缓存评估的维度,还催生了结合日志分析与人工智能的智能缓存管理系统。相关成果进一步促进了数据库自调优技术的发展,为自适应缓存策略的落地提供了理论依据与实践范式,构成了一个持续演进的学术生态。
以上内容由遇见数据集搜集并总结生成


