
jeffmeloy/python_documentation_code
收藏官方服务:
资源简介:
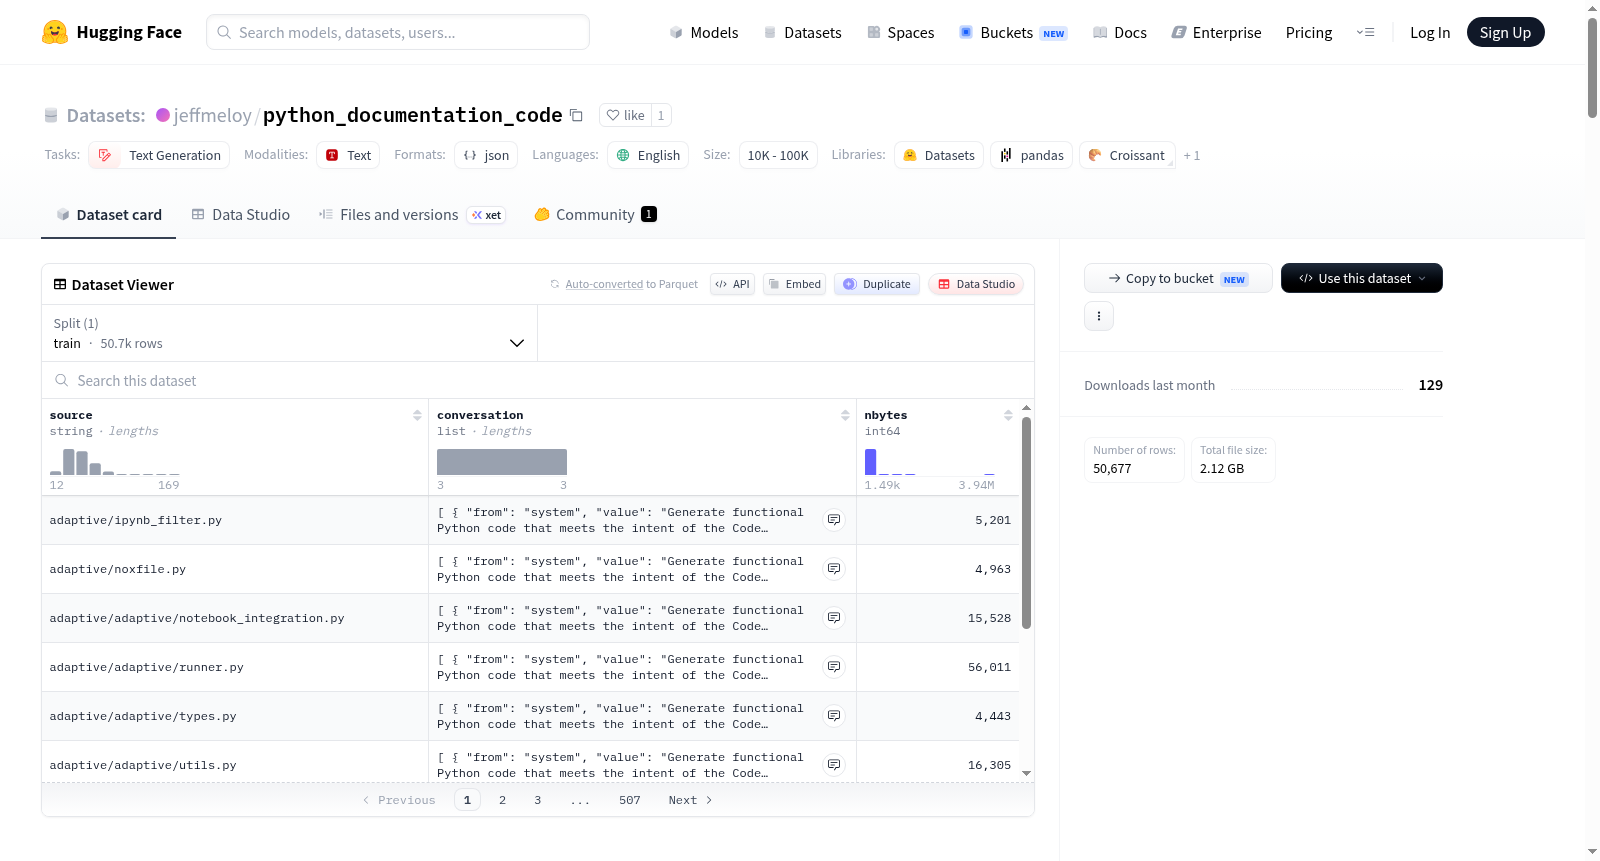
该数据集是通过使用py2dataset工具从多个Python代码库中生成的,这些代码库包括Ansible、Apache Airflow、Einops等。数据集的结构遵循sharegpt格式,即一个包含对话列表的字典,每个对话包含角色和文本内容。
该数据集是通过使用py2dataset工具从多个Python代码库中生成的,这些代码库包括Ansible、Apache Airflow、Einops等。数据集的结构遵循sharegpt格式,即一个包含对话列表的字典,每个对话包含角色和文本内容。
提供机构:
jeffmeloy原始信息汇总
数据集概述
任务类别
- 文本生成(text-generation)
语言
- 英语(en)
数据集结构
- 数据集采用sharegpt结构,由一系列字典组成,每个字典包含一个名为
conversations的新列表。 - 每个对话轮次包含两个字典,分别有
from字段表示该轮的角色,以及value字段包含实际文本。
示例条目
json { "conversations": [ { "from": "system", "value": "Output functional Python code based on the provided documentation." }, { "from": "human", "value": "Create Python code based on this documentation:<py2dataset created code documentation for python file>" }, { "from": "gpt", "value": <python file code> } ], "source": <python repository and file name>, "nbytes": <conversation nbytes> }
搜集汇总
数据集介绍
构建方式
该数据集由研究者利用自研工具py2dataset,从GitHub上精选的百余个高质量Python开源项目中提取源代码与文档注释构建而成。项目涵盖Ansible、Airflow、Transformers、PyTorch、NumPy、SciPy及Scikit-learn等众多领域顶尖库,确保了代码样本的多样性与代表性。构建过程遵循ShareGPT对话格式,将每个Python文件转化为包含系统指令、用户请求与模型回答的三轮对话结构,系统指令统一要求输出功能性Python代码,用户请求则嵌入由py2dataset生成的文档描述,模型回答为对应的原始代码文本。每条数据还附带来源仓库与文件路径信息,便于追溯与验证。
使用方法
该数据集专为文本生成任务设计,尤其适用于训练基于文档描述生成Python代码的对话模型。使用时可直接通过HuggingFace Datasets库加载,数据以标准的ShareGPT格式存储,兼容如FastChat、LLaMA-Factory等主流微调框架。用户可根据需要按来源、文件类型或字节大小进行过滤与采样。典型应用场景包括:构建代码助手、增强模型对Python生态的理解、或作为代码生成任务的微调数据集。建议在训练前对长序列进行截断或滑动窗口处理,以适配模型的最大输入长度限制。
背景与挑战
背景概述
在大型语言模型(LLMs)迅猛发展的浪潮中,代码生成任务已成为衡量模型理解与推理能力的关键基准。jeffmeloy/python_documentation_code数据集由Jeff Meloy于近期构建,旨在弥合自然语言文档与可执行Python代码之间的鸿沟。该数据集汇集了来自Ansible、Django、PyTorch、scikit-learn、Hugging Face Transformers等逾百个顶级开源项目的代码与文档,覆盖了从科学计算、机器学习到Web开发、系统运维的广阔领域。其核心研究问题聚焦于如何利用结构化文档-代码对,训练模型生成功能正确、风格一致的Python代码,从而推动自动化编程与智能软件开发工具的进步。这一资源为代码智能领域提供了高质量、多领域的训练素材,对提升LLMs在真实软件工程场景下的实用能力具有深远影响。
当前挑战
当前,该数据集面临的首要挑战在于解决代码生成领域内的语义对齐难题:文档描述与代码实现之间常存在隐含假设、上下文依赖及版本差异,模型需从海量数据中学习到精确的映射关系,避免生成语法正确但逻辑错误的代码。构建过程中,从百余个活跃仓库中抽取文档-代码对时,需处理注释风格迥异、代码片段不完整、以及文档与代码版本不一致等难题,尤其是当文档引用已弃用的API时,数据质量难以保证。此外,数据集采用ShareGPT格式,将多轮对话结构应用于代码生成任务,如何确保系统提示(system)、人类指令(human)与模型输出(gpt)之间的连贯性,避免因格式转换而丢失代码的原始上下文,亦是构建中的关键挑战。
常用场景
经典使用场景
在代码生成与文档智能补全领域,该数据集通过整合百余个顶尖Python开源库的官方文档与对应实现代码,构建了结构化的“文档-代码”对话对。其经典使用场景在于训练大语言模型精准理解函数API、参数约束与返回值语义,从而生成符合工业级规范的Python代码片段。研究者常借助这一资源,使模型能够在给定自然语言描述或技术文档时,自动输出可执行的、风格统一的函数实现,显著提升代码生成的可信度与实用性。
解决学术问题
该数据集有效攻克了代码生成领域长期面临的“文档-代码语义对齐”难题。传统方法常因训练数据中缺乏高质量、多领域的文档-代码匹配对,导致模型生成代码与真实API行为脱节。通过覆盖从科学计算(SciPy、NumPy)到深度学习(PyTorch、Transformers)的广泛生态,该数据集为探究“如何将抽象技术文档转化为精确程序逻辑”提供了标准化基准,推动了代码智能生成与语义理解研究的实质性进展。
实际应用
在实际工程中,该数据集支撑了智能编程助手与自动化文档解析系统的开发。例如,开发者可基于此训练模型,使其在集成开发环境中实时根据函数签名或注释生成完整的实现代码,大幅降低重复性编码工作。同时,该资源也被用于构建代码审查辅助工具,通过对比生成代码与标准库实现,自动检测潜在错误或风格偏差,从而提升团队协作效率与软件质量。
数据集最近研究
最新研究方向
在大型语言模型与代码生成领域交叉融合的前沿浪潮中,该数据集聚焦于将海量优质Python开源项目文档转化为结构化的指令微调语料。通过汇聚Ansible、PyTorch、scikit-learn等百余个顶尖库的源代码与文档,它构建了基于ShareGPT格式的对话式训练样本,使模型能够理解文档意图并生成对应的高质量Python代码。这一研究方向紧密关联着当前AI辅助编程与自动化代码生成的热点事件,例如GitHub Copilot的广泛采用以及大模型在科学计算、深度学习框架等专业场景的落地需求。该数据集的意义在于,它不再局限于简单的代码补全,而是推动模型掌握从文档到逻辑实现的完整推理链条,为开发更智能的编程助手、降低软件工程门槛提供了坚实的数据基石,有望加速从算法研究到工业应用的转化进程。
以上内容由遇见数据集搜集并总结生成


