
遇见数据集

projetogabi/healthbench-multilingual

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

该数据集是OpenAI的医学AI评估基准HealthBench的多语言翻译版本,覆盖32种语言。原始的HealthBench包含5,000个现实世界的多轮临床对话和超过48,000个医生撰写的评估标准,旨在评估AI系统对患者和临床医生提出的健康问题的响应能力。HealthBench Multilingual使这一基准能够被多种语言访问,包括一些在医学NLP研究中代表性严重不足的语言,如阿姆哈拉语、豪萨语、斯瓦希里语和乌尔都语,以支持服务于全球人口的AI系统的开发和评估。

This dataset is a multilingual translation of HealthBench, OpenAIs medical AI evaluation benchmark, covering 32 languages. The original HealthBench consists of 5,000 realistic multi-turn clinical conversations and more than 48,000 physician-authored rubric criteria designed to evaluate how well AI systems respond to health questions from both patients and clinicians. HealthBench Multilingual makes this benchmark accessible across a wide range of languages — including several that are severely underrepresented in medical NLP research, such as Amharic, Hausa, Swahili, and Urdu — to support the development and evaluation of AI systems that serve global populations.
提供机构:
projetogabi
搜集汇总
数据集介绍
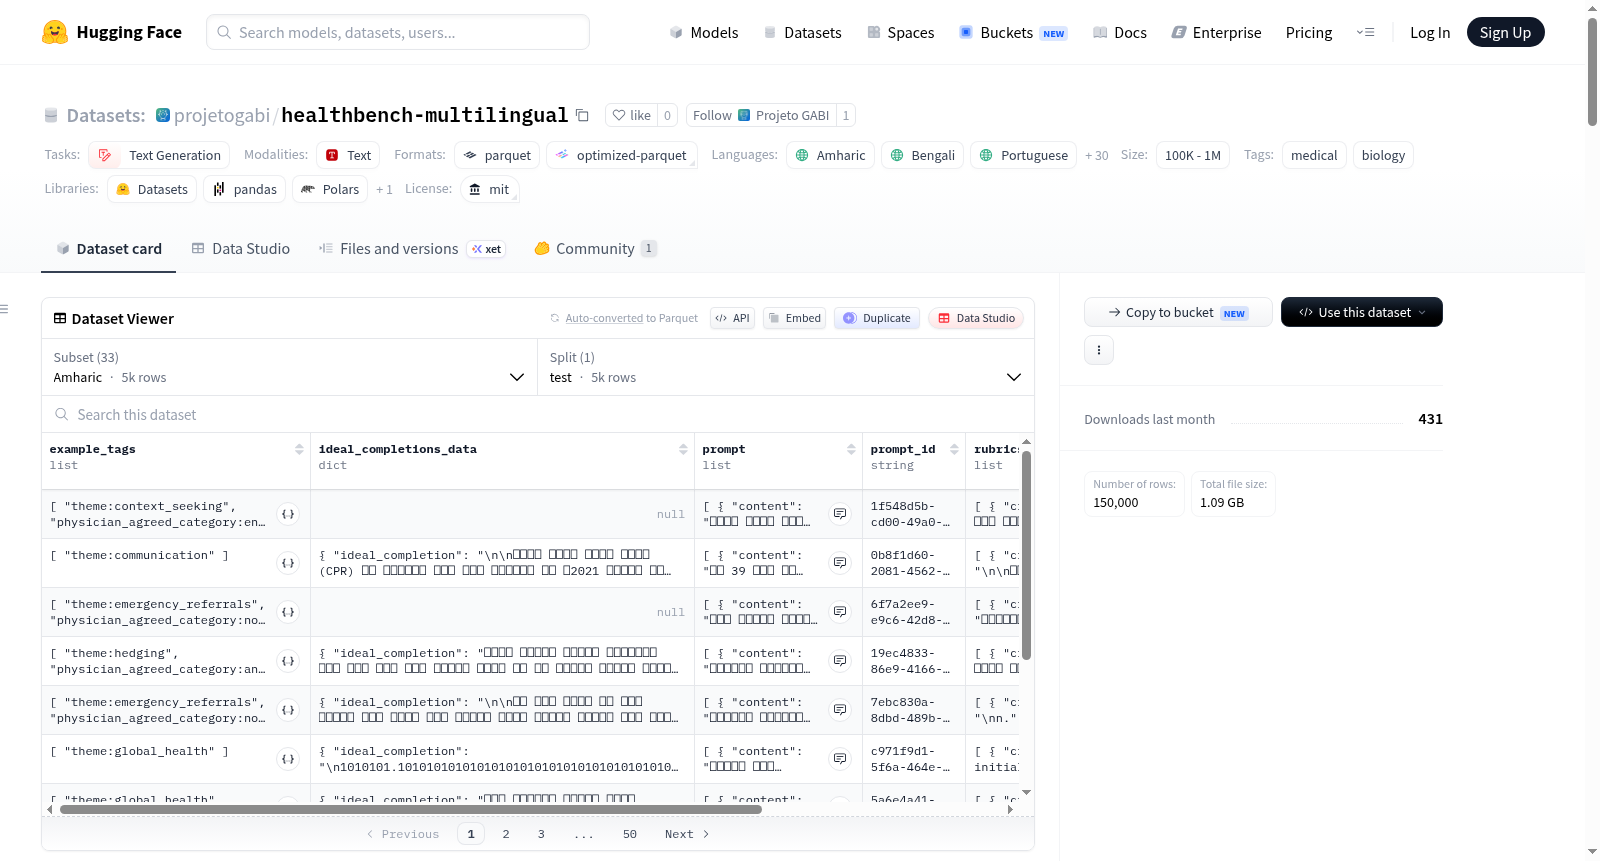
projetogabi/healthbench-multilingual 数据集图片
构建方式
HealthBench Multilingual是基于OpenAI旗下HealthBench基准测试的多语言翻译版本,覆盖32种语言。该数据集保留了原始HealthBench中5,000个多轮临床对话及超过48,000条由262位来自60个国家的医师撰写的评分细则。在构建过程中,团队通过机器翻译技术将原本仅英文的对话和评价标准转化为包括阿姆哈拉语、豪萨语、斯瓦希里语和乌尔都语等严重缺乏医学自然语言处理资源的语言,旨在打破英语中心化的医疗AI评估壁垒,促进全球健康数据公平。
特点
该数据集的核心特点在于其多语言覆盖的广度和对低资源语言的优先支持。除了法语、德语、日语等常见语言外,还包含索马里语、泰语、越南语等33个语种配置,每个语言子集均以测试集形式提供。数据结构包含提示词、理想完成组、标签和评分标准等字段,确保评估的全面性与医师验证的可靠性。作为AEGIS-1项目的一部分,该数据集专注于医疗领域的跨语言迁移学习研究,为多语言医疗大语言模型的评估和微调提供了宝贵的基准资源。
使用方法
用户可通过HuggingFace的datasets库便捷调用该数据集。加载时需指定语言配置名称,例如使用`load_dataset('projetogabi/healthbench-multilingual', 'French', split='test')`即可获取法语测试集。数据集适用于评估多语言医疗大语言模型的临床对话能力,也可作为非英语医疗场景下模型微调的训练数据。此外,研究者可利用其评分标准字段进行跨语言医学知识迁移分析,但需注意该数据集不得用于临床决策,且机器翻译可能引入的文化与术语偏差需谨慎考量。
背景与挑战
背景概述
HealthBench-Multilingual是OpenAI于2025年发布的HealthBench基准的多语言拓展版本,由来自全球多个机构的AEGIS-1项目团队主导构建。该数据集的核心研究问题在于评估大语言模型在非英语医疗对话场景中的表现,填补了当前医疗AI评估体系几乎完全依赖英语数据的空白。HealthBench原始版本包含5000次多轮临床会话和超过48000条由262位来自60个国家的医生制定的评分细则,而多语言版本将其覆盖至32种语言,尤其纳入了阿姆哈拉语、豪萨语、斯瓦希里语等医学自然语言处理研究中严重不足的语种。这一数据集的出现,使得跨语言医学AI的可评估性、可调优性和公平性研究成为可能,对推动全球健康数据公平具有里程碑意义。
当前挑战
该数据集所面临的挑战首先体现在领域问题层面:医学对话本身蕴含复杂的专业术语、文化特定表达和诊疗流程差异,英语环境下的评估标准未必适用于其他语言;而在构建过程中,多语言翻译引入了机器翻译的固有缺陷,如临床语言的细微差异、习语和健康概念可能损失准确性;此外,不同医疗系统中临床规范、患者与医生沟通模式各异,翻译后的对话难以完整再现这些文化背景。评分细则的跨语言迁移亦构成挑战,英语情境下由医生撰写的评判标准可能不适应本土化医疗体系。低资源语言受限于翻译模型的支持程度,其数据质量往往低于高资源语言,进一步加剧了评测的不均衡性。
常用场景
经典使用场景
在跨语言医疗人工智能评估的学术版图中,HealthBench Multilingual 数据集为研究者提供了一方弥足珍贵的试验田。其经典使用场景在于,通过32种语言覆盖的5000余段多轮临床对话与48000余条医生撰写的评分准则,系统性地评估大语言模型在不同语言环境下的医疗应答质量。研究者可将该数据集作为标准化测试平台,衡量模型在诊断建议、患者教育、用药指导等真实临床情境中的表现,尤其关注模型在处理非英语低资源语言时的能力边界。这一场景深刻契合了全球健康数据公平的时代命题,使得医疗AI评估不再局限于英语世界的一隅。
解决学术问题
该数据集直指医疗自然语言处理领域一个长期悬而未决的痛点:大多数医学AI基准测试仅以英语构建,导致模型在多语言环境下的性能落差难以被精确量化。HealthBench Multilingual 系统性地解决了跨语言医疗AI评估的缺失问题,为学术研究提供了首个涵盖阿姆哈拉语、豪萨语、斯瓦希里语等极度匮乏资源语言的医生验证级评测基准。其意义在于,不仅揭示了模型在实际临床语境中的语言偏见与性能鸿沟,更推动了医疗AI公平性这一社会技术议题进入可量化、可比较的研究范式,为后续构建包容性更强的医疗语言模型奠定了方法论基础。
衍生相关工作
围绕该数据集已衍生出一系列具有标杆意义的学术探索。其中最经典的当属AEGIS-1系列研究,该工作开创性地系统性翻译多个医疗AI基准到低资源语言,HealthBench Multilingual 正是其核心组件。后续工作包括:基于该数据集对比不同翻译策略(如机器翻译与人工后编辑)对评测结果的影响,揭示翻译伪影对模型评估的干扰;以及利用其评分准则进行跨语言知识蒸馏研究,探索如何将英语医疗模型的高阶能力迁移至低资源语言版本。这些衍化工作共同编织了一张从数据集构建到模型优化再到公平性评测的完整学术网络。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

